Physical AI · Deep Dive
Kann ein Roboter einen Fehler erkennen, bevor er ein Objekt berührt?
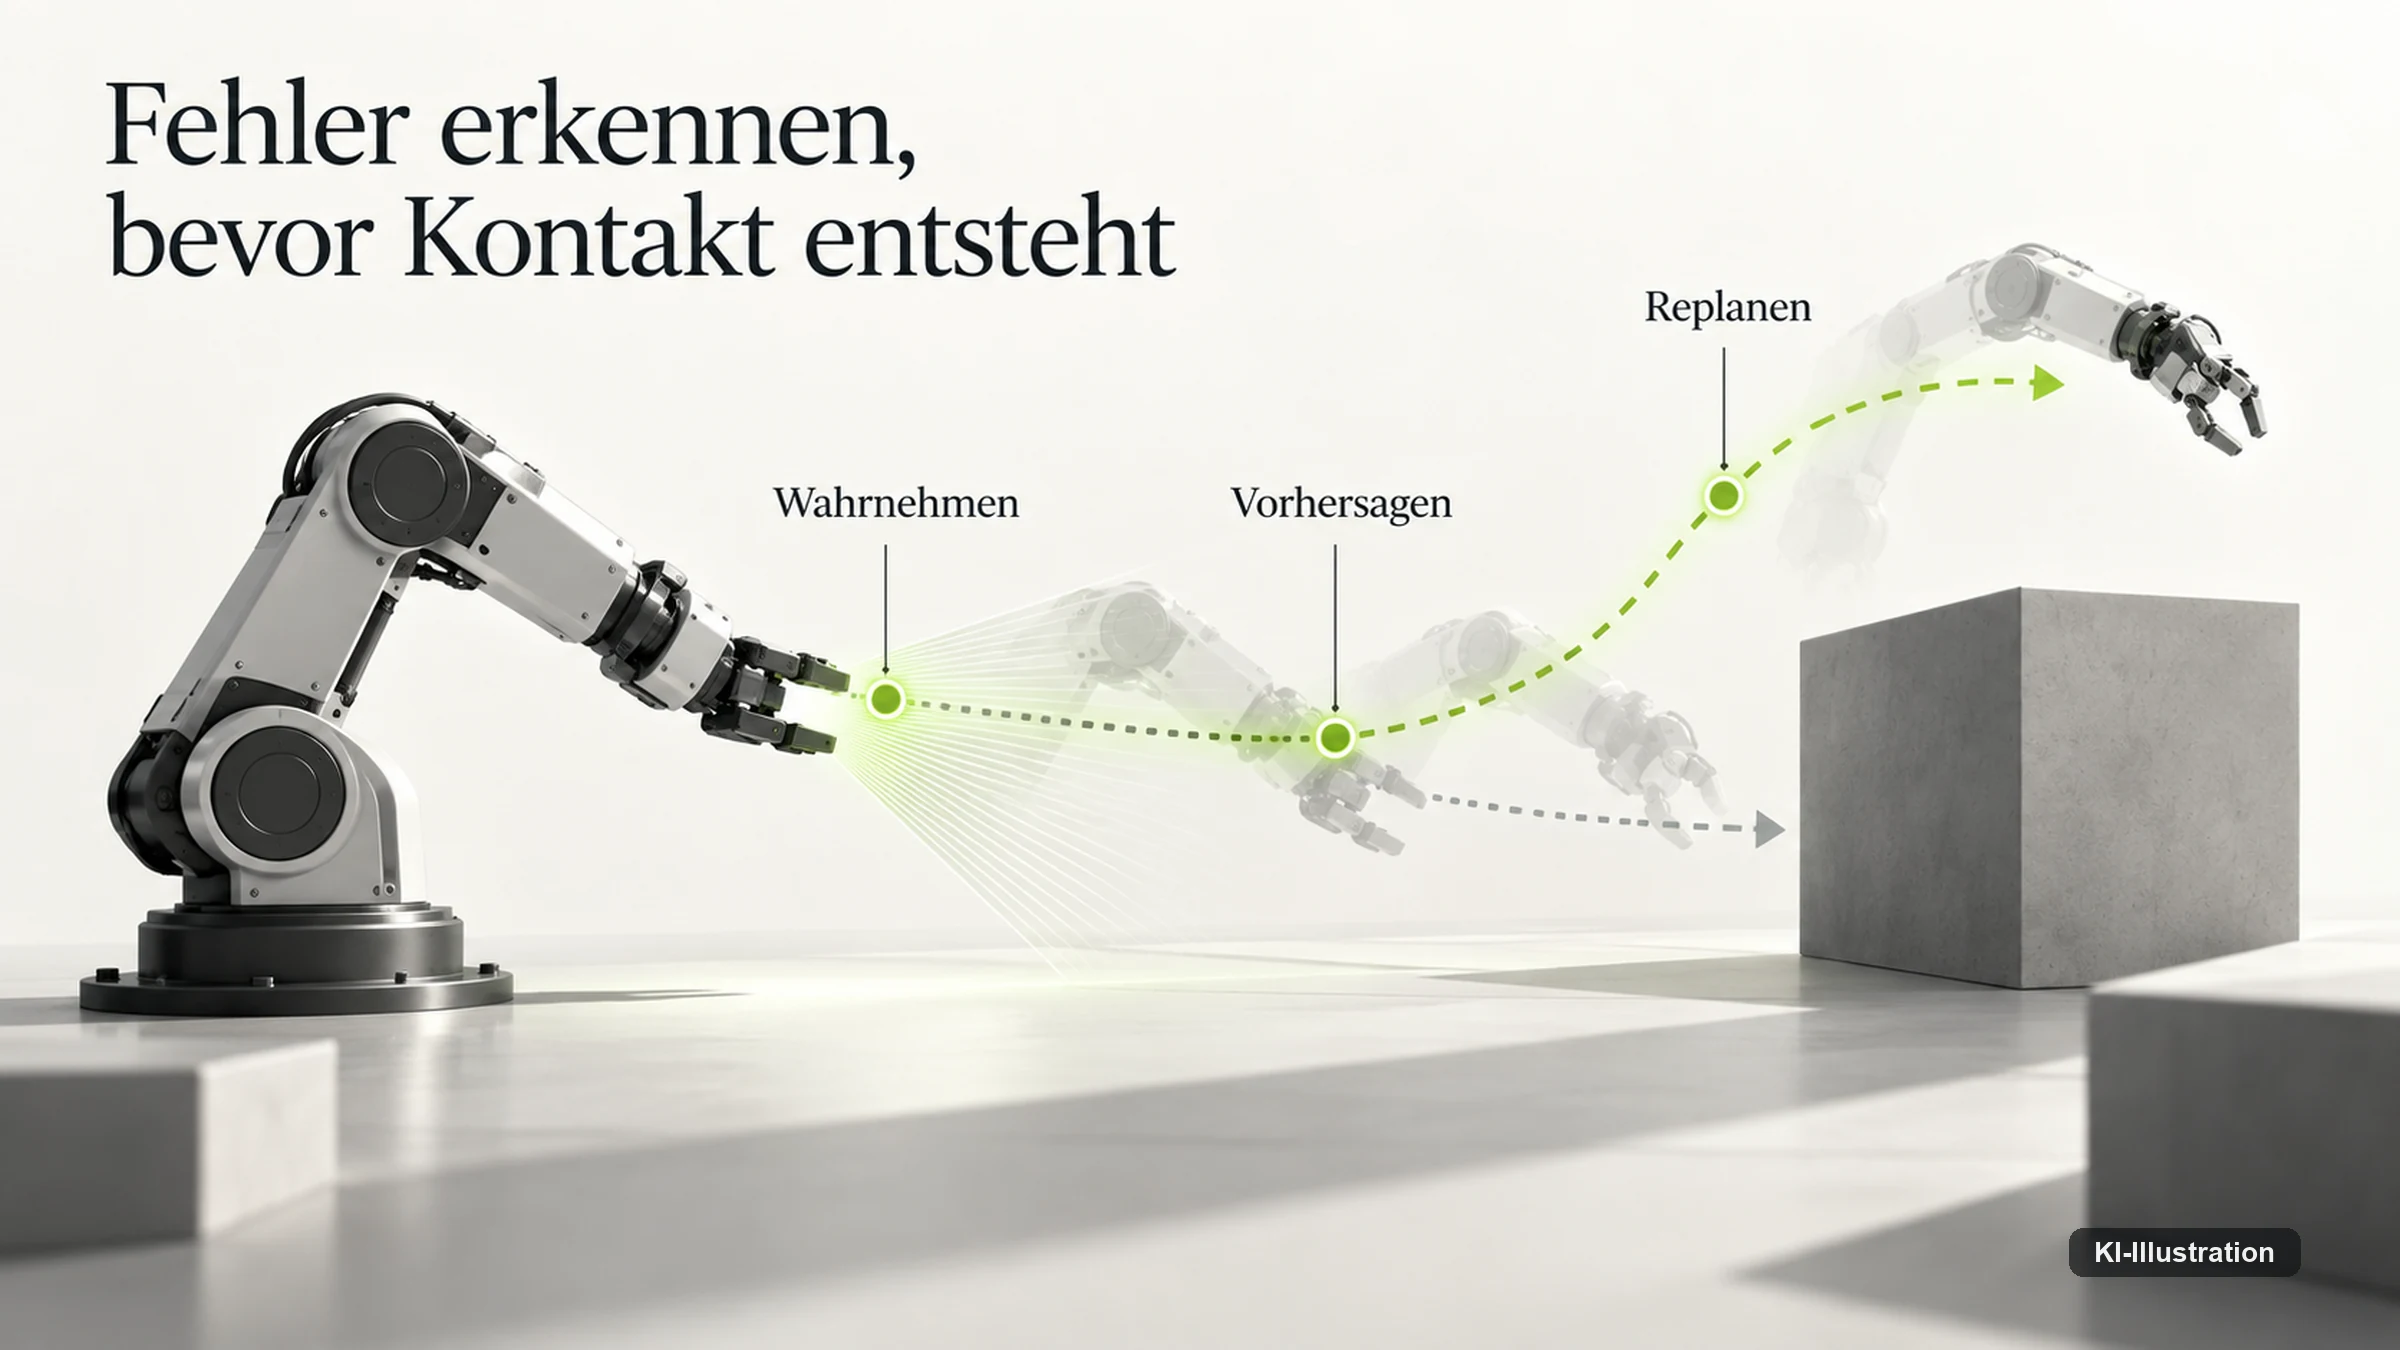
Kurz gesagt: Ja, aber nur für bestimmte Fehlerarten. Forschungssysteme wie ContactGuard, SAFE oder FIPER prüfen Geometrie, Wahrnehmungsunsicherheit und die vorausgesagte Konsequenz einer geplanten Bewegung, bevor der Greifer ein Objekt berührt. Reibung, Schlupf und reale Kontaktkraft bleiben dagegen weitgehend erst im Kontakt selbst messbar. Nach dem aktuellen Forschungsstand sind praktisch alle hier beschriebenen Verfahren Preprints, Konferenzbeiträge oder Fachartikel aus 2025/2026 – kein fertiges Serienprodukt.
Der Moment, bevor die Tasse kippt
Der Greifer ist noch wenige Zentimeter von der Tasse entfernt, und auf dem Kamerabild sieht die Bewegung richtig aus. Die Objekterkennung hat die Tasse markiert, die Policy hat eine Greifbewegung erzeugt, der Arm fährt sauber auf sein Ziel zu. Nur eine Kleinigkeit stimmt nicht: Der Greifer ist wenige Millimeter versetzt.
Würde die Bewegung unverändert weiterlaufen, träfe ein Finger zuerst den Rand. Die Tasse würde sich verschieben, aus einem kleinen Positionsfehler würde ein veränderter Szenenzustand, und ein zweiter Greifversuch müsste nicht nur den ursprünglichen Fehler korrigieren, sondern zusätzlich mit einem Objekt umgehen, das jetzt woanders steht. Viele Robotersysteme erkennen genau solche Fehler erst, nachdem der Kontakt bereits stattgefunden hat – die Information ist dann eindeutig, doch der physische Schaden ist längst entstanden.
Die interessantere Frage lautet deshalb nicht, ob ein Roboter einen Fehler bemerkt, sondern ob er ihn vorhersehen kann, bevor der Kontakt überhaupt stattfindet. Im September 2026 lautet die Antwort der Forschung: teilweise ja, aber nur für bestimmte Fehlerarten – und diese Einschränkung ist wichtiger als jede einzelne Demo.
Das ist mehr als klassische Kollisionsvermeidung. Ein Kollisionscheck stellt fest, ob der Arm gegen eine Wand fahren würde, erkennt aber nicht, dass ein formal kollisionsfreier Greifpunkt fünf Millimeter zu weit links liegt und die Tasse deshalb beim Schließen weggeschoben wird. Manipulation ist kein reines Positionsproblem, weil Geometrie, Material, Kraft, Reibung und zeitlicher Ablauf zusammenwirken – und diese Beziehung wird erst im physischen Kontakt zu echter Physik. Diese Forschungsrichtung ist ein zentraler Baustein der Physical AI und verschiebt einen Teil dieser Entscheidung vor genau diesen Moment.
Fünf Arten, wie ein Griff scheitern kann
Bevor man über Vorhersage spricht, lohnt sich eine Unterscheidung, die oft fehlt: Nicht jeder Fehler ist gleich schwer zu erkennen. Manche Probleme zeigen sich bereits in der Geometrie, bevor der Roboter sich bewegt – das Objekt steht nicht dort, wo erwartet, der Greifpunkt liegt außerhalb sinnvoller Geometrie, oder eine Kiste blockiert den Anfahrweg. Dafür braucht es keine ausgefeilte KI, sondern robuste Wahrnehmung und einen sauberen Bewegungsplaner.
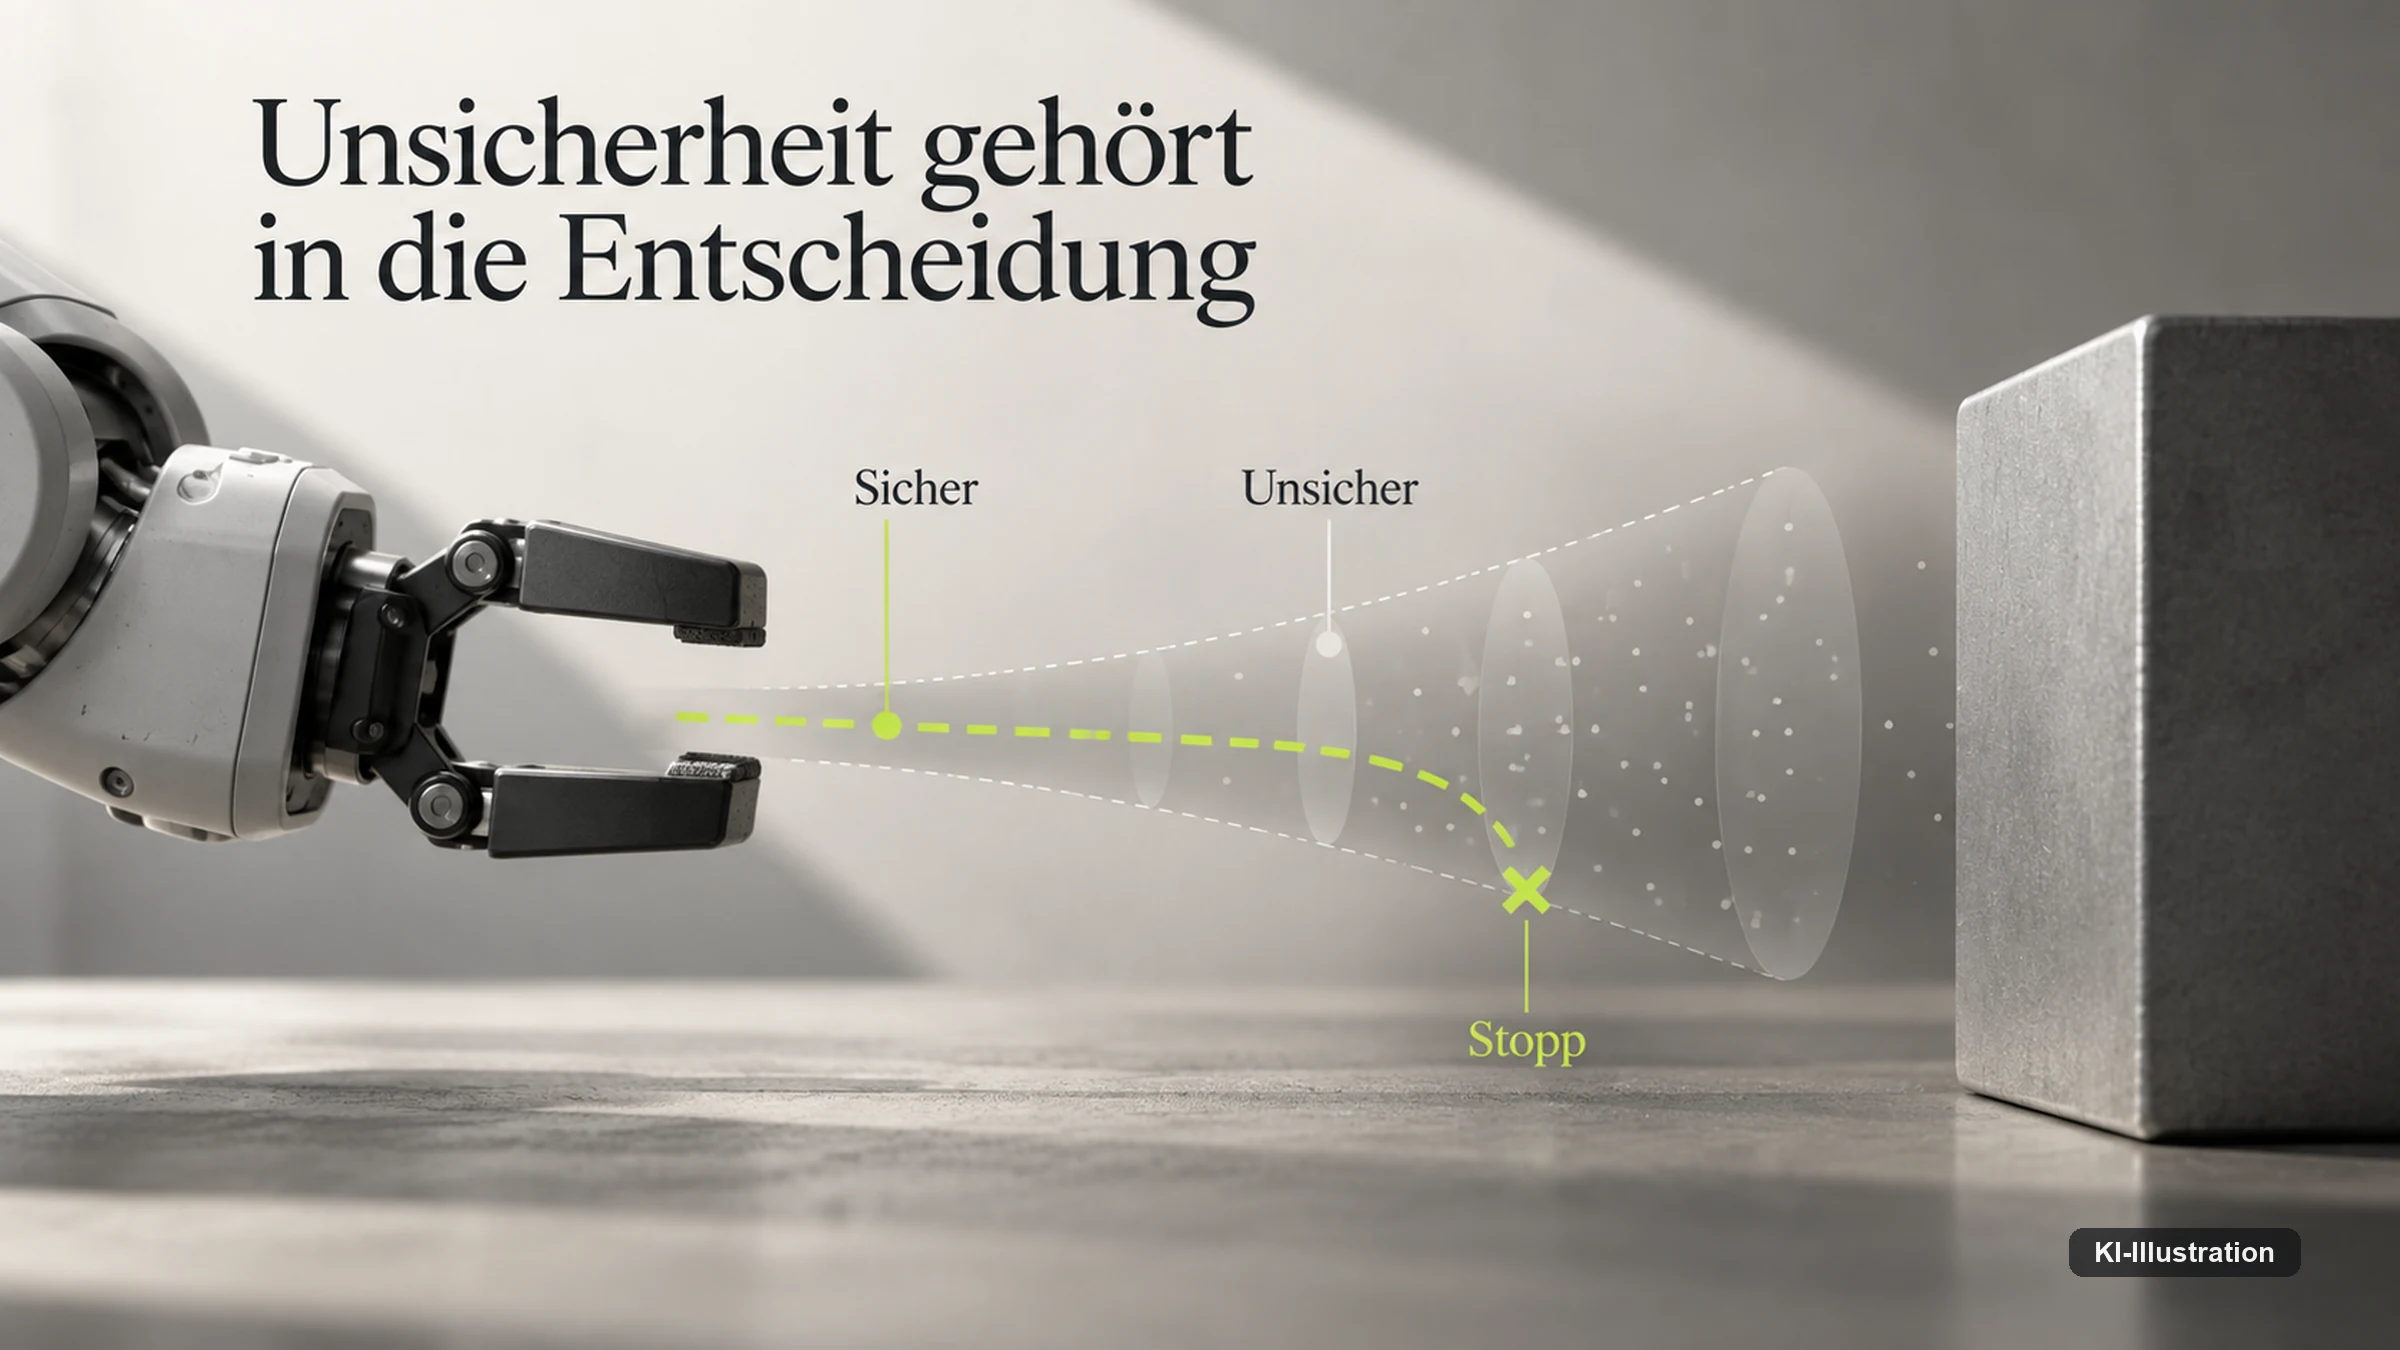
Eine zweite Klasse lässt sich nur probabilistisch abschätzen: Die Objektpose ist ungenau bekannt, der Griff liegt knapp an einer Kante, oder die Policy verhält sich in einer unbekannten Situation ungewöhnlich unsicher. Hier lautet die Frage nicht mehr, ob ein Griff falsch ist, sondern wie wahrscheinlich sein Gelingen unter der aktuellen Unsicherheit ist.
Die dritte Klasse entsteht im Nahfeld, wenige Zentimeter vor der Berührung, wo eine Handkamera oft die Übersicht verliert, weil der Greifer selbst das Objekt verdeckt. Genau hier helfen Proximity- und Pre-Touch-Sensoren, die nicht den Kontakt selbst messen, sondern die letzten Zentimeter davor.
Eine vierte Klasse benötigt eine echte Zukunftsprognose, denn der aktuelle Zustand kann gut aussehen, während die geplante Aktion trotzdem schlecht ist – hier setzen World Models an, die fragen, was vermutlich passiert, wenn der Roboter genau diesen Bewegungsabschnitt ausführt. Und dann bleibt eine fünfte, härtere Grenze: reale Reibung, Mikroschlupf und die exakte Kontaktkraft lassen sich vor der Berührung oft nur schätzen, weil die physische Wahrheit häufig erst im Kontakt selbst entsteht. Deshalb ist der moderne Robotik-Stack kein Wettbewerb zwischen Sehen und Tasten, sondern eine Staffelübergabe zwischen beidem.
Der erste Hebel: Unsicherheit ernst nehmen
Viele Robotersysteme behandeln eine erkannte Objektpose wie eine feststehende Wahrheit: Die Kamera liefert x, y, z und eine Rotation, und der Roboter plant seinen Griff darauf. In Wirklichkeit ist jede Posemessung eine Schätzung, denn 3D-Sensoren rauschen, Objekte sind teilweise verdeckt, und die Beleuchtung verändert, wie eine Oberfläche im Bild wirkt.
Ein Forschungsteam der Universität Süddänemark hat 2026 einen Ansatz veröffentlicht, der genau hier ansetzt: Statt einer einzelnen 6D-Objektpose schätzt das System eine Poseverteilung. Der Roboter greift nur, wenn ein ausreichender Anteil der plausiblen Posen mit dem gewählten Griff kompatibel ist – in der Studie diente dafür eine Schwelle von 60 Prozent. [S02]
Der Versuchsaufbau bleibt wichtig, damit die Zahlen nicht überinterpretiert werden: Getestet wurden fünf Objekte mit je zehn Versuchen, wobei die Wahrnehmungsdaten aus realen Sequenzen stammten, während die Aktionsausführung für den Vergleich in einem Digital Twin lief. Die Varianten ohne Unsicherheitslogik erreichten laut der veröffentlichten Tabelle Erfolgsraten von 44 beziehungsweise 40 Prozent, mit Unsicherheitsüberwachung stiegen die berichteten Werte auf 78,72 beziehungsweise 85,36 Prozent. [S02]
Das heißt nicht, dass Unsicherheitsmodellierung überall die Erfolgsquote verdoppelt. Es zeigt etwas Grundlegenderes: Ein Roboter kann Fehler vermeiden, indem er nicht so handelt, als wüsste er mehr, als er tatsächlich weiß. Diese Vorsicht hat allerdings einen Preis, denn ein höherer Schwellenwert bedeutet mehr Repositionierung und damit eine längere Zykluszeit – einen Zielkonflikt, den die Frontiers-Arbeit ausdrücklich benennt. [S02] Ein Detector, der jede zweite gute Aktion vorsichtshalber stoppt, kann betrieblich unbrauchbar sein, selbst wenn er kaum einen echten Fehler durchlässt.
Vier Kennzahlen, an denen sich Pre-Contact-Systeme messen lassen
Demo-Videos zeigen selten, was für den Betrieb entscheidend ist. Für diesen Beitrag schlägt die FluxLane-Redaktion deshalb vier Kennzahlen vor, mit denen sich ein Pre-Contact-System nüchtern bewerten lässt – ausdrücklich kein etablierter Industriestandard, sondern eine redaktionelle Einteilung.
| Kennzahl | Frage, die sie beantwortet | Warum sie zählt |
|---|---|---|
| Prevented Contact Failure Rate | Wie viele physische Fehlkontakte werden wirklich verhindert, bevor das Objekt unerwünscht berührt wird? | Ohne diesen Wert bleibt unklar, ob das System überhaupt etwas bewirkt. |
| False Abort Rate | Wie oft wird eine eigentlich funktionierende Aktion unnötig gestoppt? | Ein zu vorsichtiges System kostet Durchsatz statt Fehler zu sparen. |
| Warning Horizon | Wie viel Zeit liegt zwischen Alarm und erwartetem Kontakt? | Eine korrekte Warnung fünf Millisekunden vor dem Kontakt ist praktisch wertlos, wenn der Arm nicht mehr rechtzeitig stoppen kann. |
| Recovery Cost | Was kostet ein durchgelassener Fehler in Zeit, Neulokalisierung, Material oder menschlichem Eingriff? | Erst zusammen mit den anderen drei Werten zeigt sich, ob Vorsicht wirtschaftlich sinnvoll ist. |
Diese vier Größen hängen zusammen, statt unabhängig zu funktionieren. ContactGuard etwa berichtet die False Abort Rate ausdrücklich neben der Erkennungsleistung, weil ein Preprint, das nur die verhinderten Fehler zeigt, die halbe Geschichte erzählt. [S01] Ein System, das 95 von 100 schlechten Griffen verhindert, dabei aber 400 gute Aktionen zusätzlich stoppt, kann in einer Hochgeschwindigkeits-Sortieranlage schlechter sein als eines, das nur 85 schlechte Griffe verhindert und dafür nur 20 gute stoppt. Welche Kombination sich lohnt, entscheidet die Recovery Cost: Bei einem Karton für wenige Cent zählt jede Sekunde Taktzeit, bei einer Laborprobe zählt jeder verhinderte Fehler mehr als die verlorene Zeit.
Ein Rechenbeispiel: was die vier Kennzahlen für eine Sortierzelle bedeuten
Damit die vier Kennzahlen mehr sind als vier Definitionen, folgt ein Rechenbeispiel. Es ist ausdrücklich hypothetisch: Keine der folgenden Zahlen stammt von einem realen Hersteller oder einer realen Anlage, sie dienen nur dazu, die Zusammenhänge zwischen den Größen sichtbar zu machen.
Nehmen wir eine angenommene Sortierzelle mit 10.000 Greifversuchen pro Woche. Ohne jede Pre-Contact-Prüfung wären davon geschätzt 5 Prozent, also 500 Versuche, fehlerhaft geplant. Ein angenommenes System mit einer Prevented Contact Failure Rate von 70 Prozent würde davon 350 Fehlkontakte vor der Berührung abfangen, die übrigen 150 blieben unentdeckt.
Gleichzeitig verbleiben 9.500 eigentlich funktionierende Griffe. Bei einer angenommenen False Abort Rate von 2 Prozent würden davon 190 unnötig gestoppt – Taktzeit-Kosten ohne einen verhinderten Fehler dahinter.
Der Warning Horizon entscheidet, ob eine Warnung überhaupt wirken kann. In Anlehnung an das bei ContactGuard berichtete Timing von rund einer halben Sekunde vor dem geplanten Greifschluss [S01] sei in unserem Beispiel ein Zeitfenster von 500 Millisekunden angenommen: Reicht die Aktorik aus, den Arm binnen dieser Zeit zu stoppen, wird aus jeder erkannten Gefahr ein tatsächlich verhinderter Fehler; reicht sie nicht, sinkt die reale Prevented Contact Failure Rate unter den gemessenen Erkennungswert.
Für die Recovery Cost sei angenommen, dass jeder durchgelassene Fehlkontakt im Schnitt 90 Sekunden zusätzliche Zeit kostet – für Neulokalisierung und einen zweiten Greifversuch. Bei 150 durchgelassenen Fehlern wären das rechnerisch 13.500 Sekunden, gut 3,75 Stunden pro Woche. Dem stehen die 190 unnötigen Stopps gegenüber, die bei angenommenen 5 Sekunden je Stopp knapp 16 Minuten kosten. In diesem konstruierten Beispiel wiegt die Recovery Cost der durchgelassenen Fehler erkennbar schwerer als die Kosten der unnötigen Stopps – bei anderen Annahmen kann sich das Verhältnis umkehren. Genau deshalb lässt sich die Wirtschaftlichkeit eines Pre-Contact-Systems nicht an einer einzelnen Kennzahl ablesen, sondern nur am Zusammenspiel aller vier.
Das Schichtenmodell L0 bis L6
Aus den hier untersuchten Arbeiten lässt sich ein Schichtenmodell ableiten, das zeigt, an welcher Stelle welche Prüfung ansetzt – ausdrücklich keine offizielle Norm, sondern eine redaktionelle Einteilung von FluxLane.
| Ebene | Leitfrage | Beispiel |
|---|---|---|
| L0 – Geometrie und Kollision | Kann die Bewegung physisch ausgeführt werden? | klassischer Bewegungsplaner, Kollisionscheck, Erreichbarkeit |
| L1 – Wahrnehmungssicherheit | Wie sicher ist die geschätzte Welt? | Poseverteilung statt Einzelschätzung [S02] |
| L2 – Pre-Touch-Sensorik | Was befindet sich im unmittelbaren körpernahen Raum? | GenTact-Prox, SuperTac, ECT-Sensor [S04][S07][S05] |
| L3 – Aktionsverifikation | Ist die geplante Aktion plausibel? | SAFE, FIPER, FPC-VLA [S08][S10][S14] |
| L4 – World-Model-Prognose | Was passiert voraussichtlich bei genau dieser Aktion? | ContactGuard [S01] |
| L5 – Kontaktintelligenz | Entspricht der reale Kontakt der Erwartung? | Sparsh, Sparsh-X, TouchWorld [S21][S23][S26] |
| L6 – Recovery | Was tut der Roboter nach einem Abbruch? | Stoppen, neu beobachten, alternative Aktion, menschlicher Eingriff |
Die Reihenfolge ist kein Ranking, sondern eine zeitliche Kette: L0 und L1 arbeiten, bevor der Arm sich überhaupt bewegt, L2 bis L4 in den letzten Sekunden und Zentimetern davor, L5 während und nach dem Kontakt, L6 als Reaktion darauf. Kein einzelnes Modell muss dabei perfekt sein, weil unterschiedliche Ebenen unterschiedliche Fehlerarten abfangen – eine Redundanz, wie man sie aus anderen sicherheitskritischen technischen Systemen kennt.
Pre-Touch: Fühlen, bevor man fühlt
Kameras sehen aus der Distanz, Tastsensoren fühlen erst nach dem Kontakt – dazwischen liegt eine Zone, die in vielen Robotern schlecht abgedeckt ist: die letzten Zentimeter vor der Berührung. Hier wird klassische Bildverarbeitung schwächer, weil die Hand ins Bild fährt und der Greifer den Kontaktpunkt verdeckt.
Eine 2026 vorgestellte Arbeit zu GenTact-Prox – bislang nur als Preprint veröffentlicht – kombiniert taktile und Proximity-Sensorik in einer 3D-gedruckten künstlichen Haut. Die Autoren berichten Reichweiten von bis zu 18 Zentimetern und bezeichnen diesen körpernahen Wahrnehmungsraum als „Perisensory Space“. [S04] Der Begriff trifft etwas Alltägliches: Auch ein Mensch wird kurz vor einer Interaktion körperbezogen aufmerksam – wie nah die eigene Hand ist, wo die Kante relativ zum Finger liegt.
Noch deutlicher wird diese Verschmelzung beim 2026 in Nature Sensors veröffentlichten, peer-reviewten SuperTac-System, das Kraft, Position, Temperatur, Proximity und Vibration in einer dünnen Sensorhaut kombiniert und für die Proximity-Funktion einen Bereich unter 15 Zentimetern nennt. [S07] Das zeigt eine Architekturrichtung: Taktile Hardware entwickelt sich von reiner Kontaktmeldung zu einem System, das Annäherung erkennt, Kontakt registriert und anschließend mehrere physische Eigenschaften misst.
Auf der Konferenz Robotics: Science and Systems 2026 kam ein Dual-Mode-Sensor auf Basis Electrical Capacitance Tomography hinzu, der im Nahbereich Distanz und Orientierung ohne direkten Kontakt bestimmen und Materialeigenschaften grob klassifizieren soll; in der Greifervariante demonstrieren die Autoren Pre-Touch-Servoing und adaptive Greifausrichtung. [S05] Der Vorteil solcher Verfahren liegt nicht darin, die Kamera zu ersetzen, sondern dort zu helfen, wo sie geometrisch im Nachteil ist – direkt am Greifer.
ContactGuard: Der Roboter rollt seine eigene Zukunft vor
Die spannendste Entwicklung dieses Feldes stammt 2026 nicht aus der Sensorik, sondern aus World Models. Am 13. August 2026 stellten Gehan Zheng, Matthew Johnson-Roberson und Weiming Zhi den Preprint ContactGuard vor – bislang ausschließlich als Preprint verfügbar, ohne unabhängige Begutachtung. [S01] Der Ansatz ist elegant, weil er die eigentliche Roboterpolicy nicht ersetzt: Sie schlägt weiterhin die Aktion vor, während ContactGuard danebensitzt wie ein Prüfer.
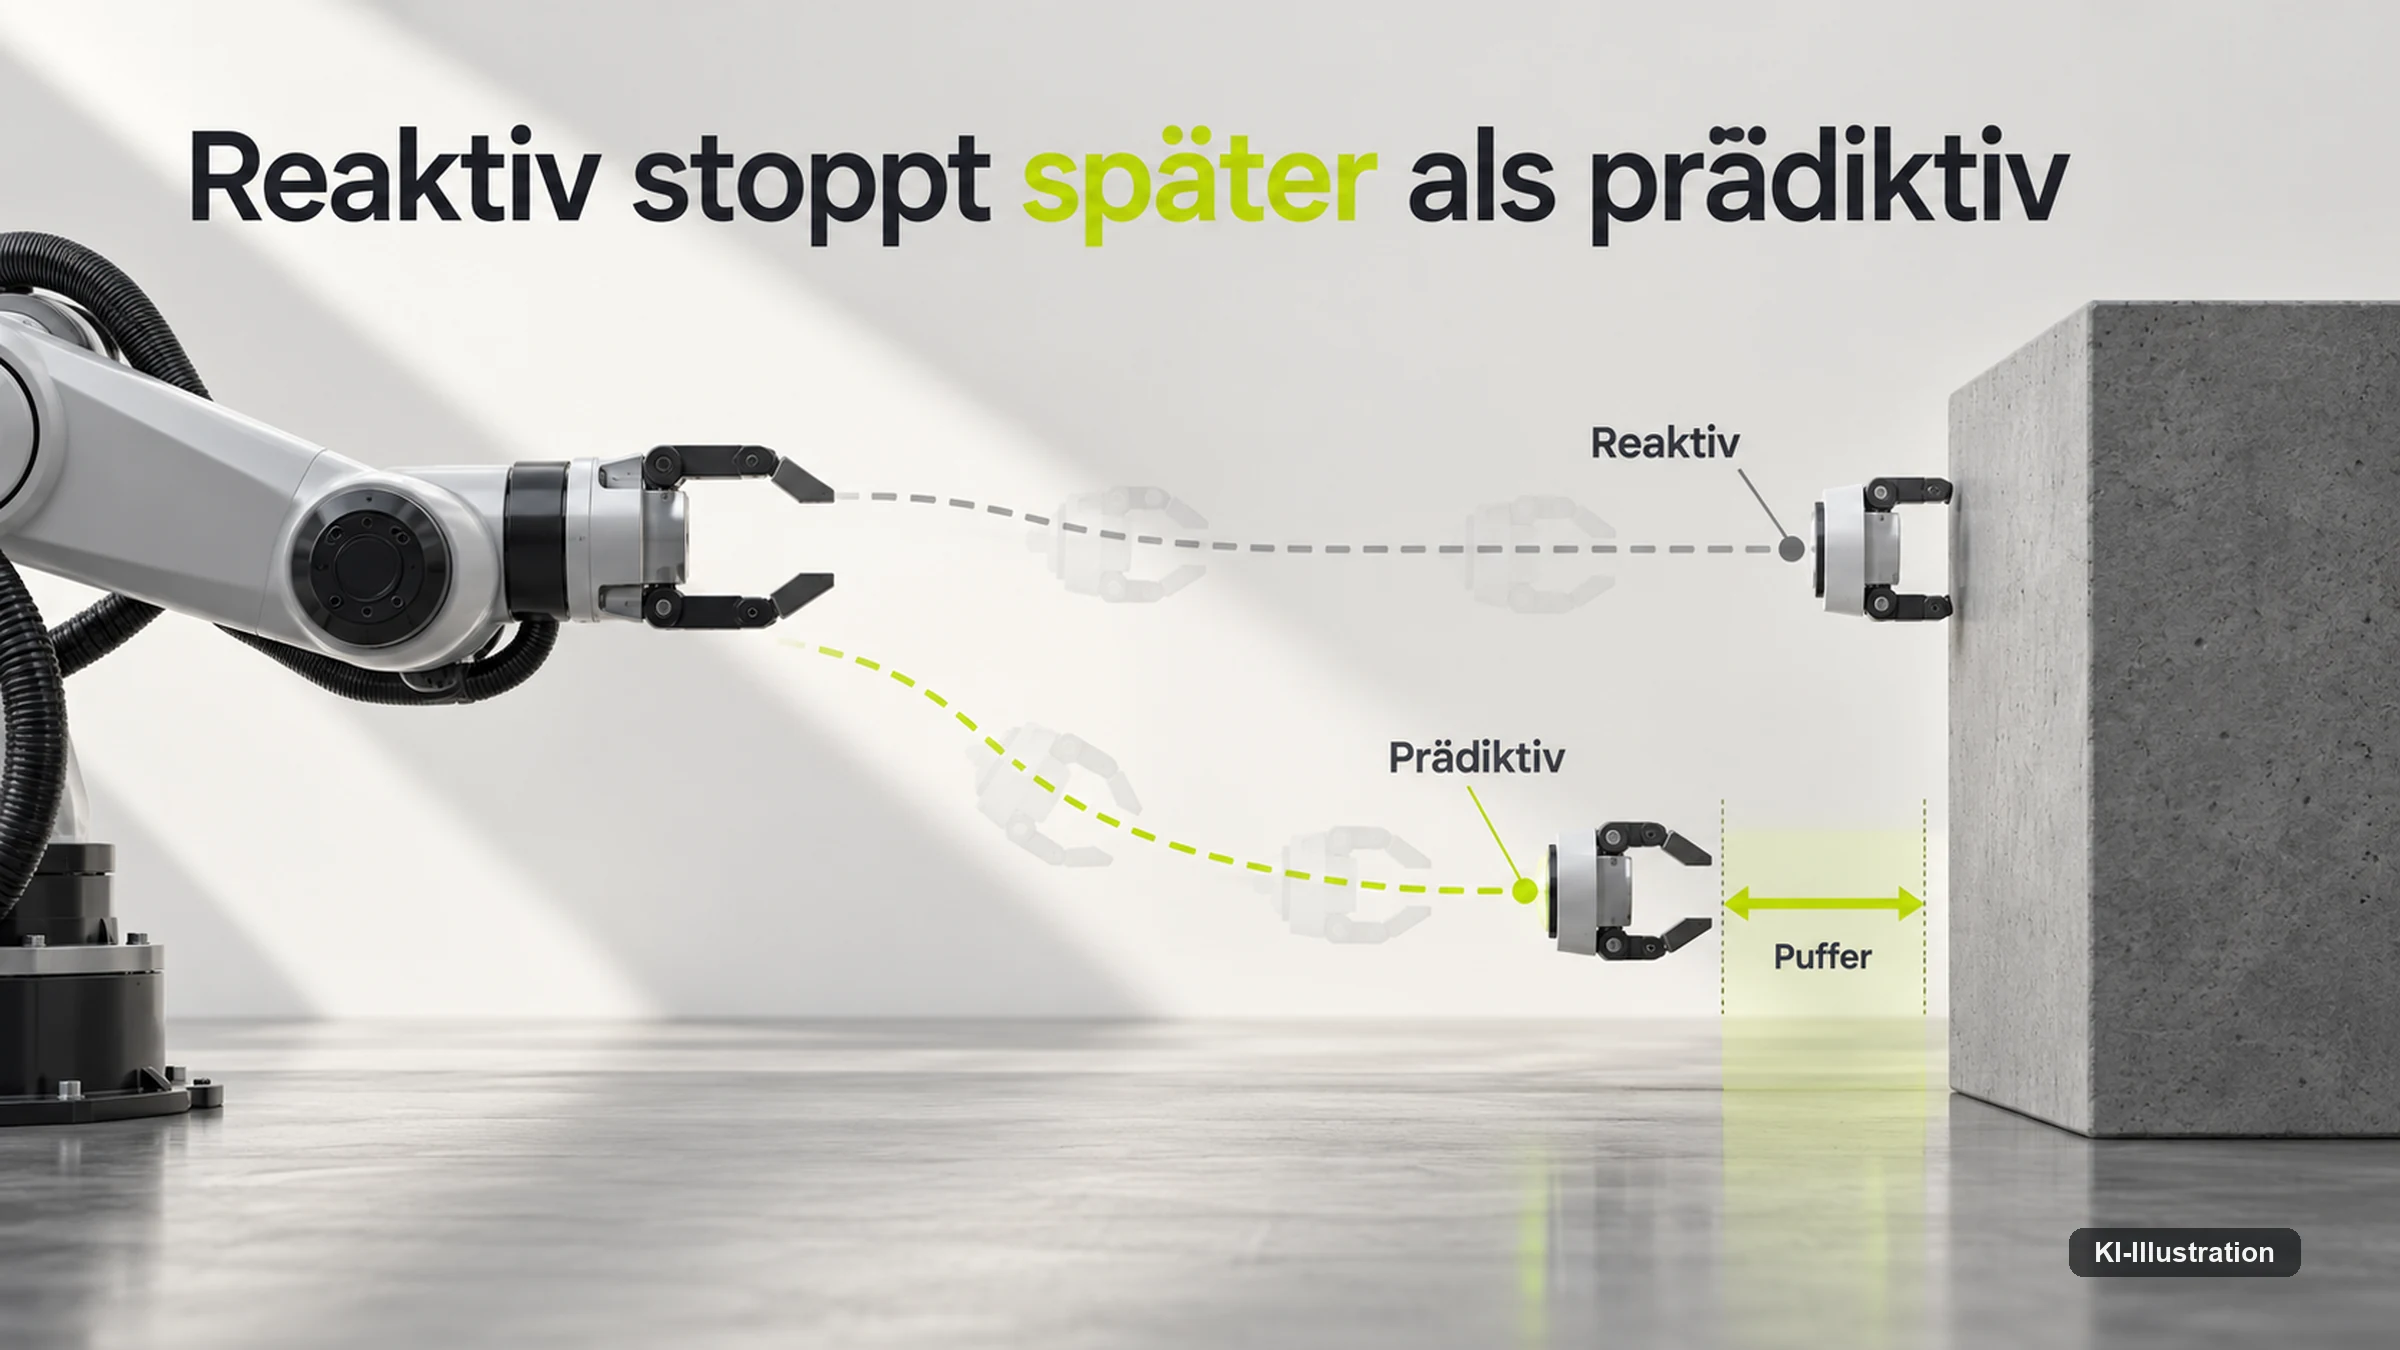
Ein gewöhnlicher Failure Detector betrachtet den aktuellen Kamerazustand. ContactGuard geht weiter: Es bekommt Beobachtungen aus mehreren Kameras, den geplanten Bewegungsabschnitt und ein gelerntes latentes Dynamikmodell, rollt die geplante Bewegung im latenten Raum voraus und lässt einen kleinen Failure Probe den erwarteten Zukunftszustand bewerten. Fällt die Fehlerwahrscheinlichkeit zu hoch aus, wird die Aktion vor dem physischen Kontakt abgebrochen. [S01] Zwei fast identische Kamerabilder können so zu unterschiedlichen Risikobewertungen führen, wenn die dahinterliegenden geplanten Bewegungen verschieden sind – die Risikofrage lautet nicht mehr, ob eine Szene gefährlich ist, sondern ob sie es unter genau dieser Aktion wird.
Der Versuchsaufbau macht die Idee konkret: ContactGuard wird 15 Frames vor dem geplanten Schließen des Greifers aktiviert, bei 30 Hertz also rund eine halbe Sekunde vor dem Kontaktmoment, und rollt anschließend 30 Schritte voraus. [S01] Getestet wurde das System auf einem 14-DoF-AgileX-Piper-Dual-Arm mit drei synchronisierten RGB-Kameras, in vier Greifsituationen – Becher, Box, Stift, Handtuch –, mit rund 250 gelabelten Greifversuchen je Situation und 50 Live-Rollouts je Setting. [S01] Die berichteten Live-AUC-Werte liegen bei 0,992 für den Becher, 0,946 für die Box, 0,898 für den Stift und 0,917 für das Handtuch, in Offline-Pools zwischen 0,982 und 0,992 – jeweils höher als ein Vergleichssystem ohne vorausgerollte Zukunft. [S01]
Diese Werte sind bemerkenswert, doch ihr Status muss sauber bleiben: Ein Preprint ist ein starker Forschungsbeleg, aber weder ein industrieller Sicherheitsstandard noch der Beweis, dass ein beliebiger Roboter einen beliebigen Fehler eine halbe Sekunde im Voraus erkennt.
Die Supervisor-Familie im Schnelldurchlauf
ContactGuard steht nicht allein. Seit 2025 wächst eine Forschungsfamilie, die der ausführenden Robotikpolicy eine zweite, prüfende Instanz zur Seite stellt. Die Grundidee: Die Vision-Language-Action-Modelle, die heute viele Roboter steuern, dürfen einen Vorschlag machen, müssen aber nicht automatisch das letzte Wort haben.
| System | Kernidee | Status / Konferenz |
|---|---|---|
| SAFE | lernt aus internen Features eines VLA-Modells eine skalare Fehlerwahrscheinlichkeit, breit statt Pre-Contact-spezifisch | NeurIPS 2025 [S08] |
| FIPER | erkennt ungewöhnliche Beobachtungen und ungewöhnlich unsichere Action Chunks; Kalibrierung ohne Failure-Daten | NeurIPS 2025 [S10] |
| AHA | nutzt ein Vision-Language-Modell, um Fehler nicht nur zu erkennen, sondern sprachlich zu begründen | ICLR 2025 [S12] |
| FPC-VLA | Supervisor bewertet an Keyframes die Durchführbarkeit einer Aktion und kann Korrekturen erzeugen | Fachartikel 2026 [S14][S15] |
| PATCH | überwacht den projizierten Ausführungskorridor der aktiven Bewegung auf relevante Veränderungen | Preprint 2026 [S16] |
| RoVer | Reward Model als Test-Time-Verifier, bewertet mehrere Kandidatenaktionen vor der Ausführung | Preprint 2025 [S18] |
Für die Praxis zählt das Timing mehr als die Namen der einzelnen Systeme. SAFE und AHA sind breit angelegt, nicht speziell auf den letzten Moment vor dem Kontakt zugeschnitten. FIPER löst ein praktisches Problem: Fehlerdaten lassen sich in der Industrie schlecht sammeln, weil sie Produkte beschädigen oder selten auftreten – FIPER kalibriert deshalb allein mit erfolgreichen Rollouts über Conformal Prediction. [S10] PATCH reagiert speziell auf eine sich verändernde Welt, etwa wenn jemand ein Objekt in den Anfahrweg stellt, während RoVer, ebenfalls bislang nur als Preprint veröffentlicht, mehrere Kandidatenaktionen erzeugt und bewertet, bevor der Roboter überhaupt eine davon ausführt. [S18] Beim Roboter kann eine schlechte Aktion die Welt verändern, während sie bei Text-KI nur Rechenzeit kostet – deshalb kann zusätzliche Rechenleistung vor der Bewegung günstiger sein als eine Recovery danach.
Der Zielkonflikt: False Abort gegen übersehenen Fehler
Eine naheliegende, aber zu einfache Lösung wäre: Ist das System unsicher, stoppt der Roboter eben. Das funktioniert nicht, denn ein Roboter, der jeden möglichen Fehler verhindert, indem er selten handelt, ist kein produktiver Roboter mehr.
Das Problem lässt sich mit zwei gedachten Systemen zeigen. System A verhindert 95 von 100 schlechten Griffen, stoppt dabei aber zusätzlich 400 eigentlich gute. System B verhindert nur 85 schlechte Griffe, stoppt dafür nur 20 gute. Welches besser ist, hängt von den Fehlerkosten ab: Bei einer Kartonage für wenige Cent ist womöglich System B die bessere Wahl, bei einem teuren Bauteil eher System A, und in einer Hochgeschwindigkeits-Sortieranlage kann zu häufiges Zögern den Business Case gefährden.
Genau deshalb berichtet ContactGuard die False Abort Rate ausdrücklich neben der Erkennungsleistung, statt sie zu verschweigen. [S01] Der beste Failure Detector ist nicht der, der niemals einen Fehler durchlässt, sondern derjenige, dessen Verhältnis von verhinderten Fehlern zu unnötigen Stopps zu den tatsächlichen Fehlerkosten passt. Sicherheit und Produktivität lassen sich nicht getrennt betrachten, sondern nur gemeinsam.
Warum Touch trotzdem unverzichtbar bleibt
Je weiter World Models reifen, desto naheliegender wirkt der Gedanke, Tastsensorik werde überflüssig. Das Gegenteil ist wahrscheinlicher: Je besser Roboter voraussagen können, desto wertvoller wird der Vergleich zwischen erwarteter und tatsächlicher Physik. Ein Kamerabild erkennt einen glatten Kunststoffdeckel, kennt aber nicht zwingend dessen realen Reibwert.
Meta FAIR hat mit Sparsh eine allgemeine Repräsentation für vision-basierte Tastsensorik veröffentlicht, selbstüberwacht auf mehr als 460.000 taktilen Bildern vortrainiert, mit dem Ziel, über mehrere Sensortypen und Aufgaben hinweg wiederverwendbare Touch-Features zu liefern. [S21] Sparsh-X, ebenfalls bislang nur als Preprint veröffentlicht, erweitert das auf mehrere taktile Modalitäten zugleich: Training auf rund einer Million kontaktreichen Interaktionen, kombiniert aus Bild-, Audio-, Bewegungs- und Drucksignalen. [S23] Das zeigt, wie vielschichtig die Physik hinter einem einzigen Griff ist – ein System kann vor dem Kontakt eine gute Hypothese haben, doch erst nach dem Kontakt zeigen mehrere Sensoren gemeinsam, ob sie stimmte.
Der 2026 veröffentlichte Preprint TouchWorld trennt zwei Zeitskalen: eine langsamere Vorhersage, was gleich passieren sollte, und eine schnelle taktile Reaktion, die korrigiert, sobald die Wirklichkeit abweicht. [S26] ContactWorld, ebenfalls ein 2026er Preprint, untersucht vision-taktile World Models für zwölf kontaktreiche Manipulationsaufgaben und berichtet, dass taktile Informationen bei längeren Planungshorizonten an Bedeutung gewinnen. [S27] Eine lange Kontaktsequenz aus Einstecken, Drehen und Nachführen sammelt Unsicherheit, bei der jeder kleine Modellfehler schwerer wiegt – Touch liefert dann die realen Korrekturpunkte, die kein World Model ersetzen kann.
Was heute käuflich ist – und was Forschung bleibt
Trotz aller genannten Fortschritte ist Pre-Contact Intelligence heute kein Regal voller fertiger Produkte. Nach dem aktuellen Forschungsstand sind ContactGuard, SAFE, FIPER, AHA, FPC-VLA, PATCH, RoVer, GenTact-Prox, die ECT-Sensorvariante der RSS 2026, Sparsh, Sparsh-X, TouchWorld und ContactWorld ausnahmslos Preprints, Konferenzbeiträge oder Fachartikel aus 2025 und 2026 – keines davon ist als abgeschlossenes, käufliches Industrieprodukt belegt. Auch das peer-reviewte SuperTac-System ist ein veröffentlichtes Forschungsergebnis, kein Katalogartikel.
Käuflich sind heute vor allem die Bausteine darunter: Kraft-Momenten-Sensoren an Greifern, taktile Sensorhäute für einzelne Fingerspitzen, kamerabasierte Posenschätzung und die nach der aktuell geltenden Maschinenrichtlinie 2006/42/EG beziehungsweise ab dem 20. Januar 2027 nach der EU-Maschinenverordnung geforderte Sicherheitssensorik. Diese Bausteine sind seit Jahren im industriellen Einsatz und bilden die Hardware-Grundlage, auf der Forschungssysteme wie die hier vorgestellten aufsetzen – sie sind aber nicht dasselbe wie ein System, das die Konsequenz einer geplanten Bewegung vorausberechnet.
Für einen industriellen Integrator bedeutet das eine nüchterne Erwartungshaltung: Wer heute eine Anlage plant, kauft bewährte Sicherheits- und Wahrnehmungstechnik, keine fertige Pre-Contact-Intelligenz nach dem Muster von ContactGuard. Woher die für solche World Models nötigen Trainingsdaten kommen, behandelt FluxLane in einem eigenen Beitrag zur industriellen Produktion von Robotik-Trainingsdaten gesondert.
Sechs Reaktionen auf einen Alarm
Ob ein System einen schlechten Kontakt früh genug erkennt, ist nur die halbe Frage. Für den realen Betrieb zählt mindestens genauso, was danach passiert – ein Failure Detector, der nur eine rote Lampe einschaltet, verschiebt das Problem zum Menschen.
Stoppen ist die einfachste Reaktion und besonders wertvoll, wenn ein Fehler die Szene irreversibel verändern könnte, etwa bei empfindlichen Bauteilen oder eng gepacktem Bin Picking – dauerhaftes Stoppen ist aber keine Recovery, sondern nur ihr Anfang. Diese Recovery-Logik setzt einen erkannten physischen Wahrnehmungsfehler voraus; wie eine Anlage stattdessen nach einem Cyberangriff in einen sicheren Notbetrieb zurückfindet, behandelt ein eigener Beitrag zu Recovery und Notbetrieb nach einem Cyberangriff.
Noch einmal hinsehen lohnt sich, wenn die Ursache Unsicherheit ist: Der Manipulator fährt wenige Zentimeter weiter, eine zweite Kamera übernimmt, und die Poseverteilung wird enger. [S02] Der Roboter handelt dann nicht vorsichtiger, weil ihm etwas Angst macht, sondern weil der erwartete Informationsgewinn höher ist als die Kosten des Wartens.
Pre-Touch einsetzen hilft, wenn die globale Kamera das Objekt gut lokalisiert, aber die letzten Millimeter unsicher bleiben: Aus der Warnung wird eine gezielte Messaktion, bevor der Greifer überhaupt schließt.
Eine alternative Aktion wählen geht weiter: Verifier-Systeme wie RoVer bewerten, welche von mehreren möglichen Aktionen infrage kommt [S18] – der Greifer dreht sich um wenige Grad, oder der Roboter nähert sich langsamer an. Aus Failure Prediction wird damit Action Selection.
Gezielter Kontakt als Informationsgewinn klingt widersprüchlich, ergibt aber Sinn, wenn der Kontakt bewusst als Messung eingesetzt wird: Manche Eigenschaften lassen sich ohne Berührung nicht zuverlässig bestimmen, weshalb ein vorsichtiger Probe-Kontakt besser sein kann als eine aggressive Greifbewegung – eine Sichtweise, die eine Dissertation der Carnegie Mellon University zu kontaktreicher Manipulation unter partieller Beobachtbarkeit ausdrücklich vertritt. [S33]
Menschliche Intervention sollte die oberste Eskalationsstufe bleiben, nicht der Normalfall: Ein Mensch kann einen Zielpunkt korrigieren oder kurz die Steuerung übernehmen, doch ein System, das bei jeder kleinen Unsicherheit nach einem Menschen ruft, hat wenig gewonnen.
Wo der industrielle Nutzen am größten ist
Nicht jede Anwendung braucht dieses Arsenal. Ein Roboter, der immer dieselbe Metallplatte aus einer exakt positionierten Vorrichtung entnimmt, ist mit klassischer Automation oft besser bedient. Pre-Contact Intelligence wird dort interessant, wo Variation und Fehlerkosten gleichzeitig hoch sind.
Beim Bin Picking kann ein falscher Griff mehrere Teile verschieben und die nachfolgende Szene schwerer machen, weshalb ein abgebrochener schlechter Griff hier wertvoller ist als eine Recovery nach massivem Umräumen. Bei empfindlichen Teilen wie Elektronik oder lackierten Flächen kann bereits der unerwünschte Erstkontakt Ausschuss erzeugen, in Labor und Healthcare betreffen die Fehlerkosten oft eine Probe oder sterile Güter statt nur Zeit, und in der Montage kann ein schlecht angefahrener Steckverbinder Pins beschädigen – Pre-Contact Alignment in Kombination mit Kraft- und Tastsensorik ist hier naheliegend.
Deformierbare Objekte wie Textilien und Kabel bilden eine eigene Grenzklasse, weil sich ihre Geometrie vor dem Kontakt nur abschätzen lässt und die Aktion selbst den Zustand beim Kontakt weiter verändert. Genau hier setzt ein eigener FluxLane-Beitrag zur robotischen Schaltschrankverdrahtung an, denn Kabelrouting und Crimpen zeigen diese Grenzklasse in einem konkreten industriellen Umfeld.
Ob humanoide Roboter davon automatisch mehr profitieren als ein klassischer Arm, lässt sich nicht pauschal bejahen. Die Methode hängt weniger von der Körperform ab als von Sensorik, World Model und der Fähigkeit, sicher zu stoppen. Humanoide sollen allerdings besonders offene Umgebungen bedienen, während ein stationärer Industrieroboter seine Welt mechanisch normieren kann – und je offener die Umgebung, desto wertvoller werden Unsicherheitsmessung, Verifier, World Models und Touch gemeinsam.
Was 2026 noch fehlt
Die Forschung macht sichtbare Fortschritte, doch mehrere Punkte bleiben offen. Ein Detector, der bei Bechern, Boxen, Stiften und Handtüchern gut funktioniert, muss nicht automatisch mit Tausenden Objektvarianten einer echten Industrieumgebung zurechtkommen – diese Generalisierung ist bislang nicht breit belegt.
Auch das Benchmarking bleibt uneinheitlich: AUC-Werte aus verschiedenen Papers sind nicht direkt vergleichbar, weil unterschiedliche Aufgaben, Fehlerdefinitionen und Datensätze zugrunde liegen. Selbst der Begriff „Kontakt“ ist nicht überall gleich definiert – beginnt er beim geplanten Greifschluss oder beim ersten Sensorereignis –, und das beeinflusst, wie ein Warning Horizon gemessen wird.
Ein lernender Verifier ist zudem nicht automatisch ein Sicherheitssystem im normativen Sinn, und ein Detector, der für einen bestimmten Greifer trainiert wurde, muss nicht auf einer anderen Hand funktionieren. Auch World Models brauchen passende Trainingsdaten aus der realen Welt, häufig gewonnen aus Teleoperation und menschlichen Demonstrationen – wie aufwendig deren Produktion ist, zeigt der bereits erwähnte FluxLane-Beitrag zu diesem Thema. Diese offenen Punkte sind kein Grund, das Feld gering zu schätzen, sondern der normale Zustand eines jungen Forschungsbereichs.
Fazit: Ja – aber nicht so, wie die Schlagzeile klingt
Kann ein Roboter einen Fehler erkennen, bevor er ein Objekt berührt? Ja, für bestimmte Fehlerarten bereits heute: Manche Fehler lassen sich direkt aus der Geometrie ausschließen, andere probabilistisch abschätzen, weitere im Nahbereich mit Pre-Touch-Sensorik messen, und mit Systemen wie ContactGuard lässt sich sogar die Konsequenz einer konkreten geplanten Bewegung vorausrollen und vor dem physischen Kontakt abbrechen. [S01]
Die zweite Hälfte der Antwort ist genauso wichtig: Der Roboter kennt die Physik nicht vollständig, bevor er sie erlebt. Reibung, Schlupf und unerwartete Materialreaktionen bleiben teilweise erst im Kontakt selbst beobachtbar, weshalb Pre-Contact Intelligence die physische Unsicherheit nicht abschafft, sondern managt. Die Zukunft ist deshalb ein Roboter, der vor dem Anfassen möglichst viel prüft und beim Anfassen sofort merkt, ob seine Vorhersage stimmte – nicht einer, der nie mehr etwas anfassen muss.
Für die betriebliche Praxis heißt das: Wer eine Anlage mit hoher Variation und hohen Fehlerkosten plant, sollte Prevented Contact Failure Rate, False Abort Rate, Warning Horizon und Recovery Cost im Blick behalten, selbst wenn die konkreten Systeme dahinter noch Forschungsarbeiten sind. Diese vier Größen entscheiden gemeinsam, ob ein zusätzlicher Prüfschritt vor dem Kontakt echten Nutzen bringt oder nur zusätzliche Komplexität schafft. Der wichtigste Fortschritt dieses Feldes ist damit technisch wertvoller als jede hellseherische Robotik: Ein Roboter muss einen geplanten Fehler nicht mehr zwingend physisch ausführen, um zu lernen, dass er ihn besser unterlässt.
Ist ContactGuard schon ein industrieller Sicherheitsstandard?
Nein. ContactGuard ist Stand September 2026 ausschließlich als Preprint veröffentlicht und noch nicht unabhängig begutachtet. Die berichteten AUC-Werte zeigen, dass das Prinzip funktioniert, ersetzen aber keine normative Sicherheitsprüfung.
Können Pre-Touch-Sensoren die Reibung eines Objekts messen?
Nicht direkt. Pre-Touch-Sensoren wie GenTact-Prox oder die ECT-Sensorvariante der RSS 2026 messen vor allem Distanz, Orientierung und grobe Materialhinweise im Nahbereich. Der reale Reibwert einer Oberfläche hängt von Feuchtigkeit, Verschmutzung und Anpresskraft ab und bleibt weitgehend erst im Kontakt selbst messbar.
Was passiert, wenn ein Pre-Contact-System zu oft fälschlich abbricht?
Dann steigt die False Abort Rate, und der Roboter stoppt eigentlich funktionierende Aktionen unnötig. Das kostet Taktzeit und kann in einer Hochgeschwindigkeitsanlage den wirtschaftlichen Nutzen des Systems übersteigen, selbst wenn es viele echte Fehler verhindert.
Werden Tastsensoren durch World Models überflüssig?
Nein, eher das Gegenteil. Je genauer ein World Model die Zukunft vorhersagt, desto wertvoller wird der Abgleich mit dem tatsächlichen Kontakt, den nur Tastsensorik wie Sparsh, Sparsh-X oder TouchWorld liefert. Reibung, Schlupf und reale Kontaktkraft bleiben Bereiche, die Vision allein nicht zuverlässig abbildet.
Lohnt sich ein Pre-Contact-System für jede Anwendung?
Nein. Wirtschaftlich sinnvoll wird es dort, wo Variation und Fehlerkosten gleichzeitig hoch sind, etwa bei Bin Picking, empfindlichen Teilen oder in der Montage. Bei einer immer gleichen, exakt positionierten Aufgabe ist klassische Automation oft die günstigere Lösung.
Wie schnell muss eine Warnung vor dem Kontakt kommen, um nützlich zu sein?
Das hängt vom Warning Horizon und von der Aktorik der Anlage ab. ContactGuard setzt in seinen Versuchen auf ein Zeitfenster von rund einer halben Sekunde vor dem geplanten Greifschluss; reicht die Mechanik nicht aus, den Arm innerhalb dieser Zeit sicher zu stoppen, bleibt selbst eine korrekte Warnung praktisch wirkungslos.
Profitieren humanoide Roboter besonders stark von Pre-Contact Intelligenz?
Nicht automatisch. Der Nutzen hängt weniger von der Körperform ab als von Sensorik, World Model und Recovery-Fähigkeit. Humanoide Roboter sollen allerdings besonders offene Umgebungen bedienen, in denen sich Fehler schwerer vorab ausschließen lassen als bei einem stationären Arm mit normierter Umgebung.
Woher stammen die Trainingsdaten für Systeme wie ContactGuard?
Solche World Models werden unter anderem mit Daten aus Teleoperation und menschlichen Demonstrationen trainiert, ergänzt um reale Rollout-Sequenzen aus dem jeweiligen Versuchsaufbau. Wie aufwendig die Produktion solcher Trainingsdaten in der Praxis ist, behandelt FluxLane in einem eigenen Beitrag.
Ist eine hohe AUC in einem Preprint schon ein Beweis für Praxistauglichkeit?
Nein. Eine hohe AUC zeigt, dass ein System in seinem konkreten Testaufbau gut zwischen Erfolg und Fehler unterscheidet, hier bei vier Greifsituationen mit jeweils rund 250 gelabelten Versuchen. Sie sagt nichts darüber aus, wie das System bei Tausenden Objektvarianten einer realen Industrieumgebung abschneidet, solange keine unabhängige Begutachtung und breitere Erprobung vorliegen.
Quellen & Stand: arxiv.org/abs/2608.13438 (ContactGuard, Zheng/Johnson-Roberson/Zhi, Preprint 13.08.2026), arxiv.org/abs/2510.10975 (RoVer, Dai et al., Preprint 2025), arxiv.org/abs/2410.24090 (Sparsh, Higuera et al.), arxiv.org/abs/2506.14754 (Sparsh-X), arxiv.org/abs/2607.07287 (TouchWorld), arxiv.org/abs/2606.13877 (ContactWorld), arxiv.org/abs/2603.04714 (GenTact-Prox, Kohlbrenner et al.), huggingface.co und github.com (PATCH-Projektquelle), frontiersin.org (Naik et al., Poseverteilung für Pre-Grasp-Planung, publ. 14.01.2026), roboticsproceedings.org (RSS 2026, ECT-Dual-Mode-Sensor, Shi et al.), doi.org (IEEE Robotics and Automation Letters, 09.03.2026), nature.com (SuperTac in Nature Sensors, publ. 15.01.2026), vla-safe.github.io und arxiv.org/abs/2506.09937 (SAFE, NeurIPS 2025), mlanthology.org und arxiv.org/abs/2510.09459 (FIPER, NeurIPS 2025), aha-vlm.github.io und arxiv.org/abs/2410.00371 (AHA, ICLR 2025), doi.org (FPC-VLA, Expert Systems with Applications, 2026), publications.ri.cmu.edu (Carnegie Mellon Robotics Institute, Dissertation Mai 2026). Preprints sind ausdrücklich als solche gekennzeichnet und noch nicht unabhängig begutachtet; genannte Kennzahlen und AUC-Werte stammen aus den jeweiligen Veröffentlichungen und wurden nicht durch FluxLane nachgemessen. Das Rechenbeispiel zu den vier Kennzahlen ist eine redaktionelle, hypothetische Illustration ohne Bezug zu einer realen Anlage. Diese Einordnung ist redaktionell und keine Sicherheits- oder Rechtsberatung. Stand: 19. September 2026.