Physical AI & Robotik-KI · Fachanalyse
Recovery nach dem Cyberangriff: Warum ein Backup nicht reicht
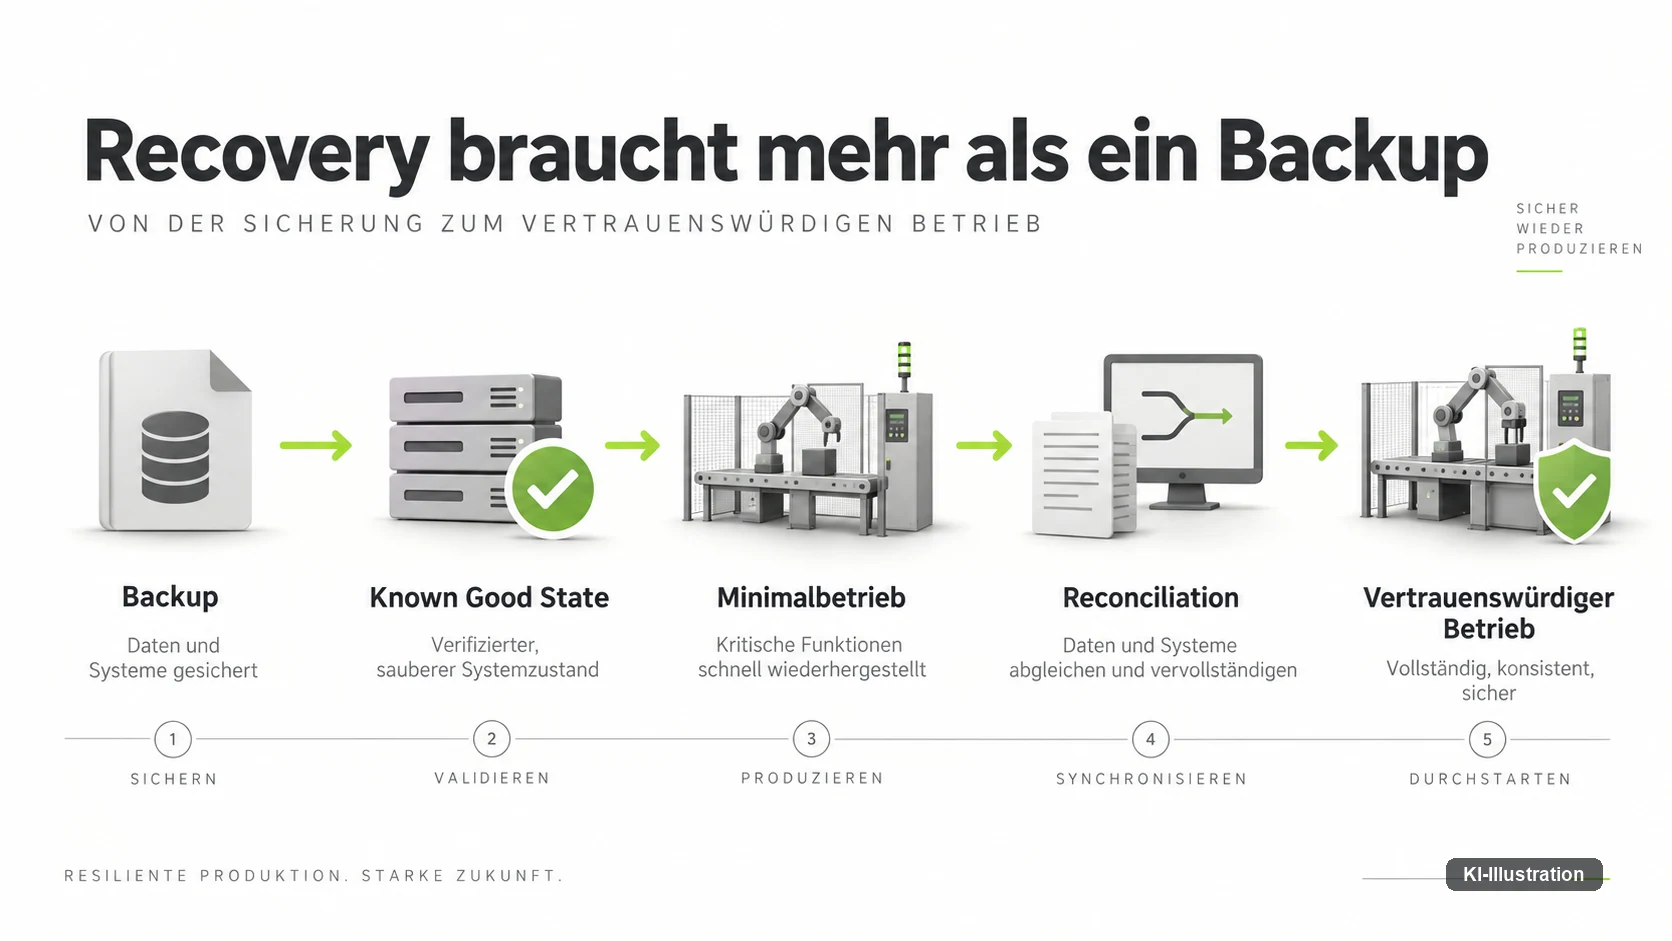
Kurz gesagt: Ein Backup ist eine Datei, die sich zurückspielen lässt — Recovery ist ein vertrauenswürdiger Betriebszustand, der erst nach einem geprüften Ausgangspunkt, einem definierten Minimalbetrieb und einer abgeschlossenen Zusammenführung der Notbetriebsrealität mit dem wiederhergestellten System entsteht. Für Klinik und Fabrik bedeutet das: ein Minimum Viable Hospital beziehungsweise eine Minimum Viable Factory, ein Known Good State, eine Reconciliation-Phase und ein Wiederanlauf-Gate mit sieben Prüffragen, bevor irgendein System zurück in den Regelbetrieb geht.
Ein Backup ist eine Datei, Recovery ist ein Zustand
Drei Tage nach einem Ransomware-Vorfall gehen im Krankenhausinformationssystem die ersten Rückmeldungen ein: Das Backup ist zurückgespielt, die Datenbank steht, die Anmeldemaske reagiert. Als IT-Sicherheitsleiterin eines Klinikums müssten Sie an dieser Stelle aufatmen. Das wäre verfrüht, denn eine wiederhergestellte Datenbank beantwortet die eigentliche Frage nicht: Stimmen die Medikationseinträge der letzten drei Tage mit dem überein, was auf den Stationen tatsächlich verabreicht wurde, und wurde irgendwo ein Zugang wiederhergestellt, den der Angreifer selbst angelegt hatte?
Die Unterscheidung ist einfach zu benennen, aber folgenreich: Ein Backup ist eine Datei, die auf einem Speichermedium liegt und sich zurückspielen lässt. Recovery ist ein Betriebszustand, dem Sie und Ihre Mitarbeitenden wieder vertrauen können, weil er geprüft, nicht nur wiederhergestellt wurde. Dieselbe Lücke trifft eine Fabrik mit vernetzten Roboterzellen genauso: Eine zurückgespielte Steuerungssoftware beweist noch nicht, dass die Zelle wieder genau das tut, was sie soll, und nichts zusätzlich, was sie nicht soll.
Zwischen der Datei und dem vertrauenswürdigen Zustand liegen vier Elemente: ein geprüfter Ausgangspunkt, ein definierter Minimalbetrieb für Klinik und Fabrik, eine Phase, in der sich die während des Ausfalls entstandene Realität mit dem wiederhergestellten System verträgt, und ein Satz von Prüffragen, der über den Wiederanlauf entscheidet, statt ihn zu unterstellen.
Warum die eigene Bereinigung zur zweiten Schadensursache wurde
Nach Angaben des Sicherheitsunternehmens Gambit Security löschte die Bereinigungsroutine des Angreifer-Agenten bei einem der betroffenen Online-Händler 180 Tabellen nach dem Namensmuster ZQ oder Backup, darunter vom Opfer selbst angelegte Backup-Tabellen; der Bericht ist ein Interimsbericht eines auf Resilienz spezialisierten Anbieters.
Zum Veröffentlichungszeitpunkt am 22. September 2026 nannte Gambit Security mindestens 27 unterschiedlich stark kompromittierte Unternehmen, über 600.000 exfiltrierte Kartendaten bei zweien von ihnen und 105 zwischen dem 10. und 15. September 2026 gestartete Angriffsprojekte — nach eigener Einschätzung des Anbieters eher eine Unterschätzung des tatsächlichen Ausmaßes. Die Kampagne lief nach dieser Darstellung seit Juli 2026 und war beim Abruf weiterhin aktiv, nicht abgeschlossen.
Der hier beschriebene Gambit-Vorfall ist ein real dokumentierter, mit Primärquelle belegter Fall — anders als das rein hypothetische Angriffspfad-Beispiel in einem anderen Beitrag dieses Blocks. Was vor und während eines solchen Vorfalls zu tun ist, etwa welche Verbindung sofort getrennt werden darf, behandelt ein eigener Beitrag zum digitalen Notaus in der Fabrik; hier zählt nur die Lehre danach: Ein Backup in derselben Vertrauens- und Fehlerdomäne wie das Produktivsystem kann von genau der Bereinigung getroffen werden, die es schützen sollte.
Der Known Good State: ein Ausgangspunkt, dem Sie vertrauen können
Recovery braucht zuerst einen Ausgangspunkt, dem sich vertrauen lässt. Wir nennen diesen Ausgangspunkt hier Known Good State — ein Arbeitsbegriff dieser Redaktion, kein zertifizierter Zustand und keine Normbezeichnung. Gemeint ist ein Softwarestand, eine Konfiguration und ein Satz an Zugängen, für die sich mit vertretbarem Aufwand nachweisen lässt, dass sie vor der Kompromittierung galten und seither nicht durch den Angreifer verändert wurden.
Das ist anspruchsvoller, als es klingt: Ein Known Good State prüft nicht nur das Rückspielziel, sondern seine Umgebung — wiederverwendete Zugangsdaten, unerklärte Konfigurationsänderungen und die Frage, ob der gewählte Zeitpunkt vor der ersten bekannten Kompromittierung liegt.
Dass Backup und Wiederherstellung für Betreiber operativer Technik eigene Aufmerksamkeit brauchen, unterstreicht auch NIST: Die Behörde veröffentlichte am 17. Juni 2026 mit SP 1339 einen eigenen, finalisierten Leitfaden speziell zu OT-Backups. Für eine Roboterzelle bedeutet ein geprüfter Ausgangspunkt konkret, dass Steuerungssoftware, Parameterdatenbank und die Rechte der Servicekonten auf denselben verifizierten Zeitpunkt zurückgeführt werden — sonst bleibt der Zustand technisch lauffähig, aber nicht notwendig vertrauenswürdig.
Dass der ursprüngliche Angriff nicht notwendig von einer Person mit begrenzter Zeit ausging, verschärft diese Prüfung zusätzlich: Bei der hier beschriebenen Kampagne übernahm ein KI-Agent die Auswahl und Ausführung einzelner Angriffe zu einem Grenzkostenpunkt von rund 25 US-Dollar pro Ziel — eine gesonderte Auswertung rechnet diese Kostenlogik nach, was bedeutet, dass ein wiederhergestelltes System einem Akteur gegenübersteht, der einen erneuten Versuch kaum kalkulieren muss.
Minimum Viable Hospital: der klinische Minimalbetrieb
In Anlehnung an eine Formulierung aus dem Gambit-Bericht übertragen wir den Gedanken „minimum viable business“ hier auf Klinik und Fabrik — als Minimum Viable Hospital beziehungsweise Minimum Viable Factory. Beides ist kein technischer Minimalserver, sondern ein klinischer beziehungsweise betrieblicher Minimalbetrieb: die kleinste Menge an Funktionen, Daten und Kommunikationswegen, mit der ein Haus verantwortbar weiterarbeitet, während die zentrale IT noch nicht vollständig wiederhergestellt ist.
Ein Minimum Viable Hospital legt für das eigene Haus fest, welche Versorgung in jedem Fall möglich bleiben muss, welche Kommunikationswege dafür notwendig sind, welche lokalen Daten verfügbar sein müssen, welche Geräte auch ohne zentrale Systeme weiterarbeiten können, wie sich Patientinnen und Patienten trotzdem eindeutig identifizieren lassen und welche Medikation sich auch ohne das übliche System sicher dokumentieren lässt. Keine dieser sechs Fragen lässt sich allgemein beantworten — die Antwort hängt am Leistungsspektrum des jeweiligen Hauses.
Vorrang hat, was Menschenleben unmittelbar gefährdet, wenn es ausfällt: Notaufnahme, Intensivstation, Blutbank und die Fähigkeit, akute Medikation sicher zu dokumentieren, stehen deshalb vor elektiver Chirurgie und zentraler Aktenverwaltung. Ein Haus, das diese Rangfolge erst während eines Vorfalls festlegt, verliert wertvolle Zeit mit einer Diskussion, die vorher hätte geführt werden können.
Minimum Viable Factory: der betriebliche Minimalbetrieb
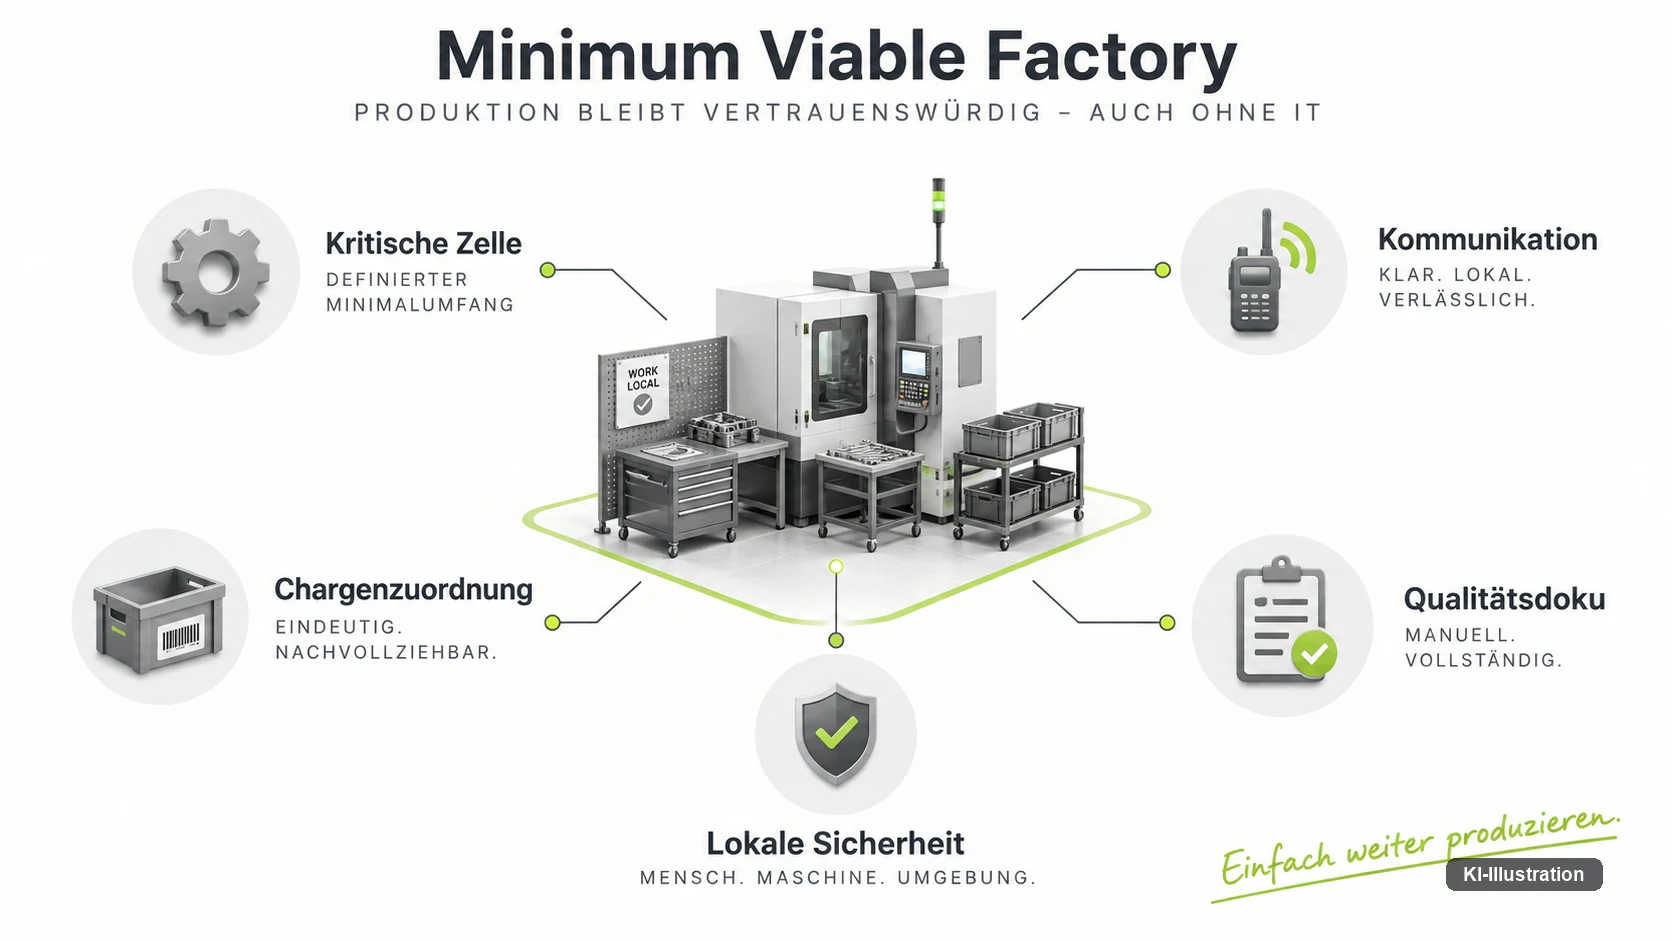
Für die Fabrik lässt sich dieselbe Systematik sinngemäß übertragen, auch wenn keine Menschenleben im selben Sinn auf dem Spiel stehen wie in der Klinik. Eine Minimum Viable Factory legt fest, welche Produktion in jedem Fall weiterlaufen muss, welche Kommunikationswege zwischen Leitstand, Zelle und Qualitätssicherung dafür notwendig sind, welche lokalen Prozessdaten verfügbar sein müssen, welche Zellen und Fördertechnik auch ohne zentrale Systeme sicher weiterarbeiten können, wie sich einzelne Chargen und Werkstücke trotzdem eindeutig zuordnen lassen und welche qualitätsrelevante Dokumentation sich auch ohne das gewohnte MES-System verlässlich führen lässt.
Die letzten beiden Fragen sind das Fabrik-Pendant zur Patientenidentifikation und zur Medikationsdokumentation: Ohne eindeutige Chargenzuordnung weiß niemand mehr, welches Werkstück unter welchen Bedingungen entstanden ist, und ohne verlässliche Qualitätsdokumentation lässt sich später nicht rekonstruieren, ob ein Produkt die Fabrik geprüft verlassen hat.
Auch hier gilt eine Rangfolge: Zellen mit eigenständiger, vom Netzwerk unabhängiger Sicherheitsfunktion können weiterlaufen, solange ihre lokale Steuerung als Known Good State gilt. Zellen, die zwingend auf zentrale Parameter oder Cloud-Dienste angewiesen sind, gehören dagegen zu den ersten Kandidaten für einen kontrollierten Stillstand.
Reconciliation: zwei Realitäten wieder zusammenführen
Zwischen dem Ausfall eines Systems und seiner zentralen Wiederherstellung vergeht Zeit — und in dieser Zeit passiert etwas, was kein Backup abbildet: reale Behandlung in der Klinik, reale Produktion in der Fabrik, oft handschriftlich, auf Zetteln, in provisorischen Listen. Wir bezeichnen die Phase, in der diese während des Ausfalls entstandene Realität mit dem wiederhergestellten System zusammengeführt wird, hier als Reconciliation — ebenfalls ein redaktionelles Arbeitsmodell dieses Beitrags, keine etablierte NIST- oder Industrienorm.
Reconciliation ist damit mehr als ein technischer Datenimport: Sie prüft, ob die Papierlisten vollständig und widerspruchsfrei zurückfließen, ob doppelt erfasste Vorgänge erkannt werden, und ob Notfall-Berechtigungen wieder zurückgenommen werden, statt unbemerkt weiterzubestehen.
Manche Häuser fassen den Aufwand für diese Zusammenführung als eigene Kennzahl zusammen, etwa als Reconciliation Debt — ein Arbeitsmodell dieser Redaktion, keine etablierte Kennzahl.
Das Wiederanlauf-Gate: sieben Fragen vor dem Wiederanlauf
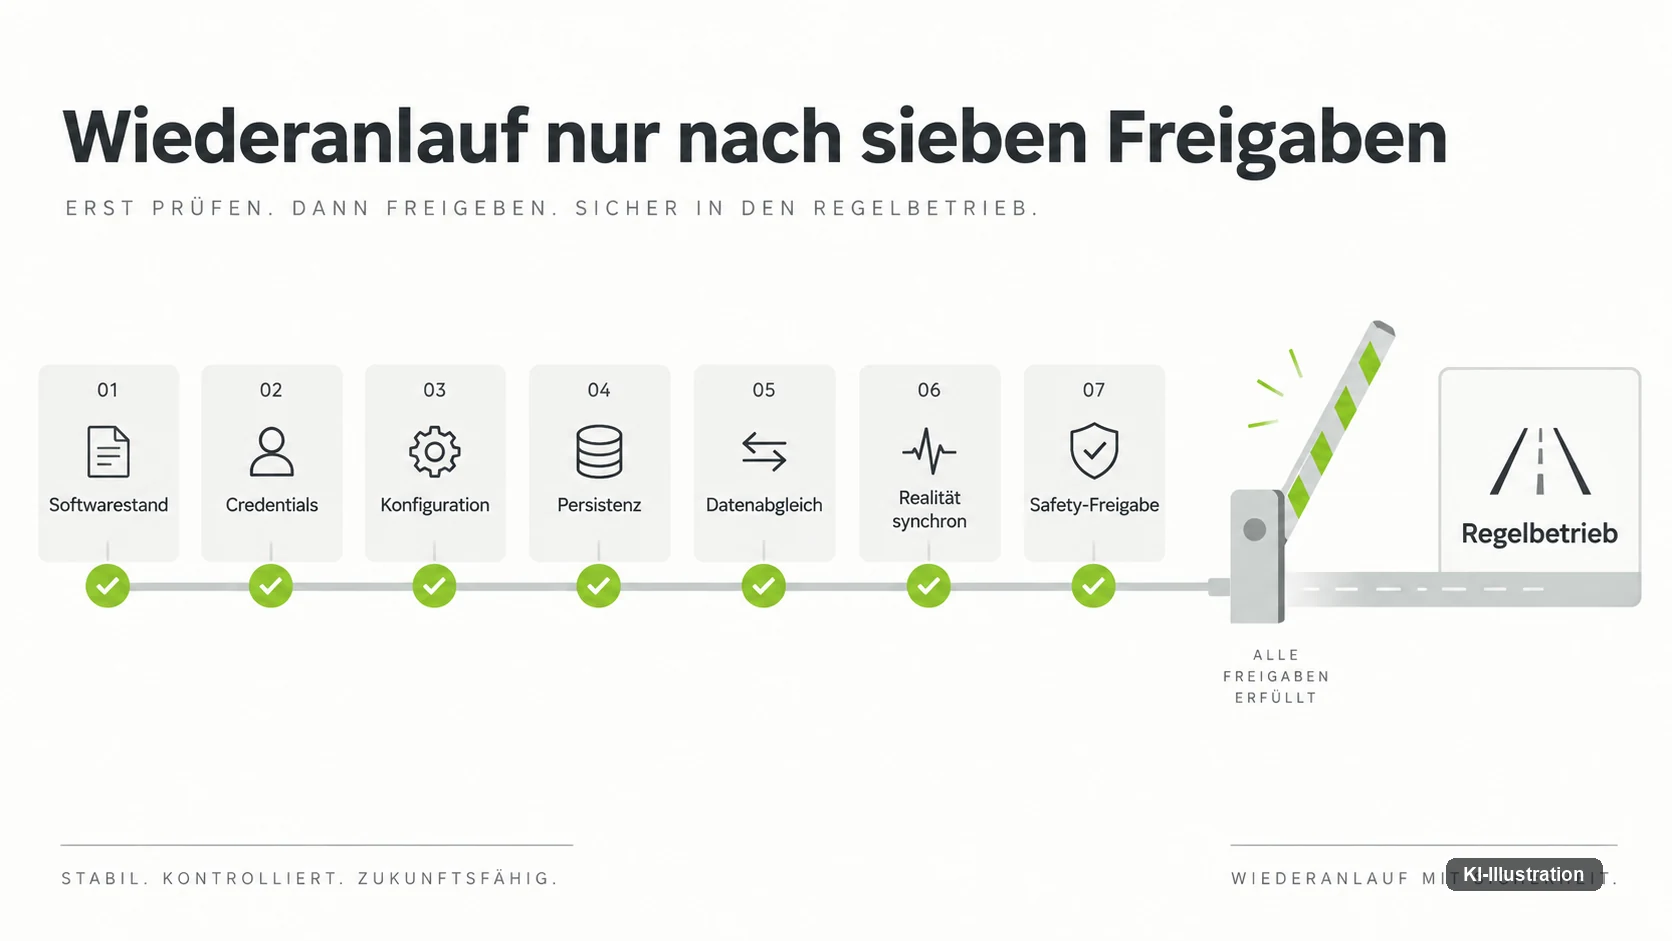
Ein Backup, das sich technisch zurückspielen lässt, ist noch keine Freigabe, wieder in den Regelbetrieb zu wechseln. Wir nennen die Instanz, die genau diese Freigabe erteilt, hier Wiederanlauf-Gate — wiederum ein Arbeitsbegriff, kein Normbegriff. Aus den in einem zugrunde liegenden Sicherheitsbericht vorgeschlagenen Prüfpunkten lässt sich eine Checkliste mit 7 Prüffragen ableiten, die vor jedem Wechsel zurück in den Normalbetrieb beantwortet sein sollten.
| Prüffrage | Worauf sie zielt | Typisches Versäumnis |
|---|---|---|
| Softwarestand verifiziert? | Entspricht dem Known Good State, nicht nur irgendeinem Backup | Rückspielung eines bereits kompromittierten Standes |
| Credentials rotiert? | Alle Passwörter, Zertifikate, API-Schlüssel des Angreifers | Servicekonten von Maschinenherstellern übersehen |
| Konfiguration vertrauenswürdig? | Keine unerklärten Änderungen an Firewall-Regeln oder Rechten | Eine vom Angreifer geöffnete Regel bleibt bestehen |
| Persistenzmechanismen ausgeschlossen? | Keine zurückgelassenen Aufgaben, Dienste oder Agenten | Ein übersehener Scheduler-Task genügt für den Wiedereinstieg |
| Datenbestände abgeglichen? | Reconciliation der Notbetriebsdaten abgeschlossen | Papierlisten werden nie vollständig nacherfasst |
| Lokale Realität synchronisiert? | Was tatsächlich geschah, deckt sich mit dem Systemstand | Ein Gerät bleibt im Notbetrieb, das System meldet „normal“ |
| Safety- und Betriebsfreigaben erfolgt? | Patienten- beziehungsweise Anlagensicherheit hat ausdrücklich freigegeben | Die IT erklärt „fertig“, ohne Fachverantwortliche zu fragen |
Keine der 7 Fragen ersetzt die anderen: Ein System mit verifiziertem Softwarestand, aber unrotierten Zugangsdaten, bleibt für einen Angreifer mit gestohlenen Credentials weiterhin offen. Erst wenn alle Fragen mit Ja beantwortet sind, verlässt ein System den Minimalbetrieb — ein einzelnes „noch nicht“ reicht, um dort zu bleiben.
Die Reihenfolge des Wiederanlaufs
Die Reihenfolge, in der Systeme das Wiederanlauf-Gate durchlaufen, entscheidet mit, wie lange der Minimalbetrieb insgesamt dauert. Wer versucht, alles gleichzeitig zurückzuholen, verteilt knappe Aufmerksamkeit auf zu viele Baustellen zugleich.
Tragfähiger ist eine Reihenfolge, die zunächst die im Minimum Viable Hospital oder in der Minimum Viable Factory als kritisch eingestuften Funktionen zurückholt — und innerhalb dieser Funktionen zuerst die Identitäts- und Zugangsverwaltung, weil jedes andere System von ihr abhängt. Erst danach folgen spürbare, aber nicht unmittelbar gefährliche Ausfälle.
Ob ein Software-Agent nach einem Vorfall automatisch wieder aktiv werden darf, ist eine eigene Frage der Handlungsbefugnis, die ein eigener Beitrag zu Identität und Autorität von KI-Agenten vertieft. Für den Wiederanlauf selbst gilt: Diese Reihenfolge lässt sich vor einem Vorfall festlegen, weil sie an der Kritikalität hängt, nicht am konkreten Angriffsweg — wer sie erst während des Vorfalls verhandelt, verhandelt sie unter Zeitdruck zwischen Abteilungen.
Reconciliation im Krankenhaus: ein konkreter Ablauf
Konkret beginnt Reconciliation im Krankenhaus meist mit der Frage, wie viele Patientinnen und Patienten während des Notbetriebs aufgenommen, verlegt oder entlassen wurden, ohne dass ein Eintrag im Hauptsystem entstand — jede dieser Bewegungen existiert zunächst nur auf Papier oder in einer improvisierten Tabelle und muss händisch, aber nachvollziehbar zurückfließen.
Der heikelste Teil betrifft die Medikation: Wurde während des Ausfalls etwas verabreicht, das im System nicht als verordnet erscheint, weil die Verordnung mündlich oder auf Papier erfolgte? Ein einfacher Datenimport reicht hier nicht aus. Eine Pflegekraft oder ein Arzt muss jede Angabe inhaltlich prüfen, bevor sie als gültiger Eintrag gilt.
Parallel prüft die IT, ob während des Notbetriebs eingerichtete Notfallzugänge — etwa ein temporäres Konto für eine externe Vertretungsärztin — wieder entzogen wurden.
Reconciliation in der Fabrik
In der Fabrik konzentriert sich Reconciliation auf Chargen, Werkstücke und Prozessparameter, die während des Notbetriebs außerhalb des zentralen Systems entstanden sind. Eine Zelle, die auf lokale Steuerung umgeschaltet hatte, produzierte in dieser Zeit häufig weiter — nur ohne die übliche automatische Protokollierung jedes Prozessschritts.
Für sicherheitsrelevante Bauteile bedeutet das einen zusätzlichen Prüfschritt: Qualitätssicherung und Produktionsleitung entscheiden gemeinsam, ob sich die im Notbetrieb entstandenen Werkstücke nachträglich dokumentieren lassen oder ob einzelne Chargen als nicht rückverfolgbar gelten müssen.
Ebenso wichtig ist der Abgleich der Maschinenparameter: Wurde an einer Zelle lokal ein Parameter verändert, der danach nicht in die zentrale Rezeptverwaltung zurückfließt, produziert die Zelle nach dem Wiederanlauf im Zweifel wieder mit dem alten, zentral gespeicherten Wert.
Abhängigkeiten kartieren, bevor der Vorfall es erzwingt
Sowohl das Minimum Viable Hospital als auch die Minimum Viable Factory setzen voraus, dass jemand vorher weiß, welche Systeme technisch und organisatorisch voneinander abhängen. Diese Karte unterscheidet sich von einem gewöhnlichen Netzplan, weil sie nicht zeigt, welche Systeme miteinander sprechen, sondern was passiert, wenn ein System für Stunden oder Tage ausfällt.
Für ein Klinikinformationssystem gehört dazu die Frage, welche Medizingeräte ihre Parameter aus der Zentrale beziehen und welche autark weiterlaufen — ein Patch für bestimmte Contec-/Epsimed-Monitore entfernte am 2. Juli 2025 die Netzwerkfunktion vollständig, ein Beleg dafür, dass eine Kernfunktion auch ohne zentrale Anbindung lokal weiterläuft. Für eine Fabrikzelle gehört dazu, welche Sicherheitsfunktion unabhängig von der Prozesssteuerung bleibt.
Diese Abhängigkeitskarte entsteht nicht aus einer einmaligen Bestandsaufnahme, sondern muss bei jeder neuen Anbindung, jedem neuen Gerät und jedem neuen Fernwartungszugang nachgezogen werden.
RTO pro Betriebsmodus statt einer einzigen Zahl
Recovery Time Objective und Recovery Point Objective bleiben die klassischen Kennzahlen der Betriebsfortführungsplanung: wie schnell ein System zurück sein muss und wie viel Datenverlust hinnehmbar ist. Für Klinik und Fabrik reicht eine einzige RTO für „das System“ jedoch nicht aus, weil nicht jede Funktion gleich dringend ist.
Ein zugrunde liegender Sicherheitsbericht nennt dafür Beispielwerte für ein Krankenhaus. Diese Zeitwerte sind ein illustratives Beispiel, keine externe Vorgabe und kein Benchmark — das eigene Haus muss seine RTO-Werte je Betriebsmodus selbst herleiten.
| Betriebsmodus | Beispiel-RTO | Was bis dahin lokal tragen muss |
|---|---|---|
| Lokale Notaufnahme / kritische Zelle | 15 Minuten | Mechanische Sicherheitsfunktion, manuelle Dokumentation |
| Basislabor / lokale Qualitätsprüfung | 30 Minuten | Eigenständige Geräte ohne Cloud-Abgleich |
| Zentrale Akteneinsicht / Rezeptverwaltung | 4 Stunden | Papierdokumentation, provisorische Listen |
| Vollständige Integrationen / MES-Anbindung | 12 Stunden | Insellösungen je Zelle oder Station |
Ein Fabrik-Pendant zu diesen konkreten Zeitwerten liefert die zugrunde liegende Quelle nicht; das eigene Werk muss die Systematik selbst auf seine Zellen und Linien übertragen, orientiert an der Rangfolge aus der eigenen Minimum Viable Factory. Wer die Klinikwerte unverändert auf die Fabrik übertragen will, übernimmt eine fremde Rangfolge.
Warum Cyber-Recovery und Business-Recovery getrennte Pläne brauchen
Viele Organisationen führen einen einzigen Business-Continuity-Plan für Stromausfall, Naturereignis und Cyberangriff gemeinsam. Das funktioniert für die meisten dieser Szenarien. Ein Cyberangriff ist anders, weil das wiederhergestellte System selbst zum Verdachtsfall wird, solange der Known Good State nicht bestätigt ist.
Deshalb braucht Cyber-Recovery einen eigenen Ablauf neben dem klassischen Business-Recovery: Business-Recovery fragt, wie schnell ein Prozess wieder läuft. Cyber-Recovery fragt zusätzlich, ob der wiederhergestellte Prozess vertrauenswürdig läuft — eine Frage, die sich bei einem Stromausfall nicht stellt.
§ 30 BSIG nennt Risikomanagementmaßnahmen einschließlich Backup, Wiederherstellung und Lieferkettensicherheit ausdrücklich — die vollständige Pflichtenlage für das eigene Haus behandelt ein eigener Beitrag zur Klinik- und Betriebs-Cybersicherheit. Hier zählt nur, dass ein Wiederanlauf-Gate diese gesetzliche Randbedingung technisch einlöst, ohne sie zu ersetzen; das ist keine Rechtsberatung.
Was am Ende zählt: ein Zustand, dem Sie vertrauen
Ein Backup ist die notwendige, aber nicht die hinreichende Bedingung für Recovery. Was dazwischen liegt, lässt sich größtenteils vor einem Vorfall erledigen: ein definierter Minimalbetrieb für Klinik oder Fabrik, ein geprüfter Ausgangspunkt, eine vorbereitete Reihenfolge und ein Wiederanlauf-Gate, das niemand unter Zeitdruck neu erfinden muss. Die mechanische Sicherheitsfunktion einzelner Maschinen bleibt davon unberührt; wie sie in das Sicherheitskonzept einer Anlage eingeordnet wird, erklärt ein Beitrag zur Sicherheit autonomer Roboter.
Was sich nicht vorab erledigen lässt, ist die Reconciliation selbst — sie entsteht erst aus der konkreten Realität eines Vorfalls. Vorbereiten lässt sich aber, mit welchen Rollen und nach welchen Kriterien ein System als vertrauenswürdig gilt. Genau das unterscheidet einen Betrieb, der nach einem Cyberangriff in Tagen wieder verantwortbar arbeitet, von einem, der Wochen braucht, um sich selbst wieder zu glauben.
Reicht ein technisch funktionierendes Backup, um nach einem Cyberangriff wieder sicher zu arbeiten?
Nein. Ein Backup zeigt nur, dass sich eine Datei zurückspielen lässt. Ob der wiederhergestellte Zustand vertrauenswürdig ist, entscheidet erst ein geprüfter Known Good State, eine abgeschlossene Reconciliation und ein bestandenes Wiederanlauf-Gate mit seinen 7 Prüffragen.
Was unterscheidet ein Minimum Viable Hospital von einem technischen Minimalserver?
Ein Minimum Viable Hospital ist kein technischer Minimalserver, sondern ein klinischer Minimalbetrieb: die kleinste Menge an Versorgung, Kommunikation, lokalen Daten und Patientenidentifikation, mit der ein Haus verantwortbar weiterarbeitet, während die zentrale IT noch nicht vollständig wiederhergestellt ist.
Lässt sich die Minimum Viable Factory einfach aus dem Minimum Viable Hospital übertragen?
Nur sinngemäß. Statt Patientenidentifikation zählt die eindeutige Zuordnung von Chargen und Werkstücken, statt Medikationsdokumentation die qualitätsrelevante Prozessdokumentation. Welche Zellen weiterlaufen dürfen, hängt von ihrer eigenständigen Sicherheitsfunktion ab, nicht von der Klinik-Rangfolge.
Wann gilt Reconciliation als abgeschlossen?
Wenn alle während des Notbetriebs auf Papier oder in Insellösungen entstandenen Vorgänge inhaltlich geprüft, vollständig ins System zurückgeführt und alle temporär eingerichteten Notfallzugänge wieder entzogen sind — nicht schon, wenn ein Datenimport technisch durchgelaufen ist.
Muss jede der 7 Fragen im Wiederanlauf-Gate erfüllt sein, bevor ein System zurück in den Regelbetrieb geht?
Ja. Die 7 Prüffragen ersetzen sich nicht gegenseitig — ein verifizierter Softwarestand ohne rotierte Zugangsdaten bleibt für einen Angreifer mit gestohlenen Credentials weiterhin offen. Ein einzelnes „noch nicht“ hält das System im Minimalbetrieb.
Sind die genannten RTO-Werte von 15 Minuten, 30 Minuten, 4 Stunden und 12 Stunden ein branchenüblicher Richtwert?
Nein. Diese Zeitwerte sind ein illustratives Beispiel für ein Krankenhaus, keine externe Vorgabe und kein Benchmark. Das eigene Haus muss seine RTO-Werte je Betriebsmodus selbst herleiten, für die Fabrik gilt das ebenso ohne unmittelbares Vorbild aus dieser Quelle.
Wie belastbar sind die Zahlen zum Gambit-Vorfall?
Die Zahlen stammen aus einem Interimsbericht des Sicherheitsunternehmens Gambit Security, das selbst mögliche Ungenauigkeiten einräumt und die tatsächliche Kampagne für größer hält als berichtet. Der Vorfall ist real, aber ein Anbieterbericht — kein forensisch unabhängig geprüfter Tatbestand.
Ersetzt dieser Beitrag eine individuelle Sicherheitsberatung für den eigenen Recovery-Plan?
Nein. Diese Einordnung ersetzt keine individuelle IT-Sicherheits- oder Rechtsberatung für den eigenen Recovery-Plan; die konkrete Umsetzung hängt an Sektor, Systemlandschaft und den geltenden Pflichten des jeweiligen Hauses.
Quellen & Stand: Gambit Security, Fallbeschreibung (veröffentlicht 22.09.2026) — ein Interimsbericht eines Anbieters mit eigenem wirtschaftlichem Interesse an Resilienz-Software, der selbst mögliche Ungenauigkeiten einräumt und die Kampagne für größer als berichtet hält. NIST SP 1339, OT Backup Quick Start Guide (finalisiert 17.06.2026). § 30 BSIG (Fassungsstand 26.09.2026). FDA Safety Communication, Contec/Epsimed (02.07.2025). Known Good State, Reconciliation, Minimum Viable Hospital/Factory und Wiederanlauf-Gate sind redaktionelle Arbeitsmodelle dieser Redaktion, keine etablierten NIST- oder Industrienormen; die genannten RTO-Beispielwerte sind ein illustratives Beispiel, kein Benchmark. Diese Einordnung ersetzt keine individuelle IT-Sicherheits- oder Rechtsberatung für den eigenen Recovery-Plan. Abruf der Quellen: 26.09.2026.