Physical AI · Analyse
Chinas Datenfabriken: Wie Physical AI industriell trainiert wird
Kurz gesagt: China baut seit 2025 in Beijing, Shanghai, Shenzhen und Wuxi Trainingszentren, die physische Robotererfahrung nicht mehr im Labor, sondern industriell erzeugen – mit Teleoperatoren, Motion Capture, Simulation und eigenen Qualitätsstandards. Die gemeldeten Kapazitäten reichen von 180.000 Datenstunden in Beijing bis zu mehr als einer Million Stunden im Shanghaier Netzwerk, sind aber je nach Betreiber und Zähleinheit kaum vergleichbar. Für europäische Robotik-Entscheider zählt weniger die einzelne Rekordzahl als die Frage, woran sich eine reale Verschiebung der Wettbewerbsposition erkennen lässt – dazu mehr im Abschnitt „Was heißt das für Sie“.
Der Engpass liegt nicht im Modell, sondern im Rohstoff
Ein humanoider Roboter hebt einen Karton an. Kameras erfassen den Raum, Gelenksensoren messen Winkel und Geschwindigkeit, ein Kraftsensor registriert den Kontakt zum Karton. Möglicherweise sitzt gerade ein Mensch an der Fernsteuerung, möglicherweise handelt die Maschine bereits selbstständig, und der Mensch greift nur ein, wenn etwas schiefgeht.
Für Physical AI ist genau diese Kette aus Wahrnehmung, Entscheidung, Handlung und physischer Konsequenz der eigentliche Rohstoff. China versucht seit rund zwei Jahren, diesen Rohstoff nicht mehr punktuell in Robotiklaboren zu gewinnen, sondern industriell: mit Trainingszentren, bezahlten Datensammlern, Teleoperatoren und eigenen Qualitätsstandards.
Bei Sprachmodellen lag der entscheidende Rohstoff bereits vor, bevor die heutige KI-Welle begann. Das Internet enthielt Text, Code und Bilder in gewaltiger Menge. Für einen Roboter existiert kein vergleichbares Archiv. Milliarden Bilder eines Bechers verraten nicht, wie stark eine Hand zudrücken darf, bevor dünner Kunststoff nachgibt, und ein Video von einer sich öffnenden Tür liefert keine Gelenkwinkel, Kontaktkräfte oder Steuerbefehle. Vision-Language-Action-Modelle brauchen deshalb Daten, die näher an der Physik liegen: Tiefendaten, Kraft-Momenten-Werte, Bewegungsbahnen, dazu die Information, ob eine Aktion gelang oder woran sie scheiterte.
Eine Textdatei lässt sich beliebig oft kopieren, eine echte Robotererfahrung muss dagegen erst stattfinden. Jemand muss die Tasse greifen, jemand muss den Stecker einsetzen, und wenn der Roboter danebengreift, gehört auch dieser Fehler aufgezeichnet – für jede andere Beleuchtung, jedes andere Objekt erneut. Die Datenfrage bei Physical AI ist deshalb gleichzeitig eine Personal-, Hardware-, Immobilien- und Qualitätsfrage. China behandelt sie inzwischen genau so.
Was eine Datenfabrik industriell produziert
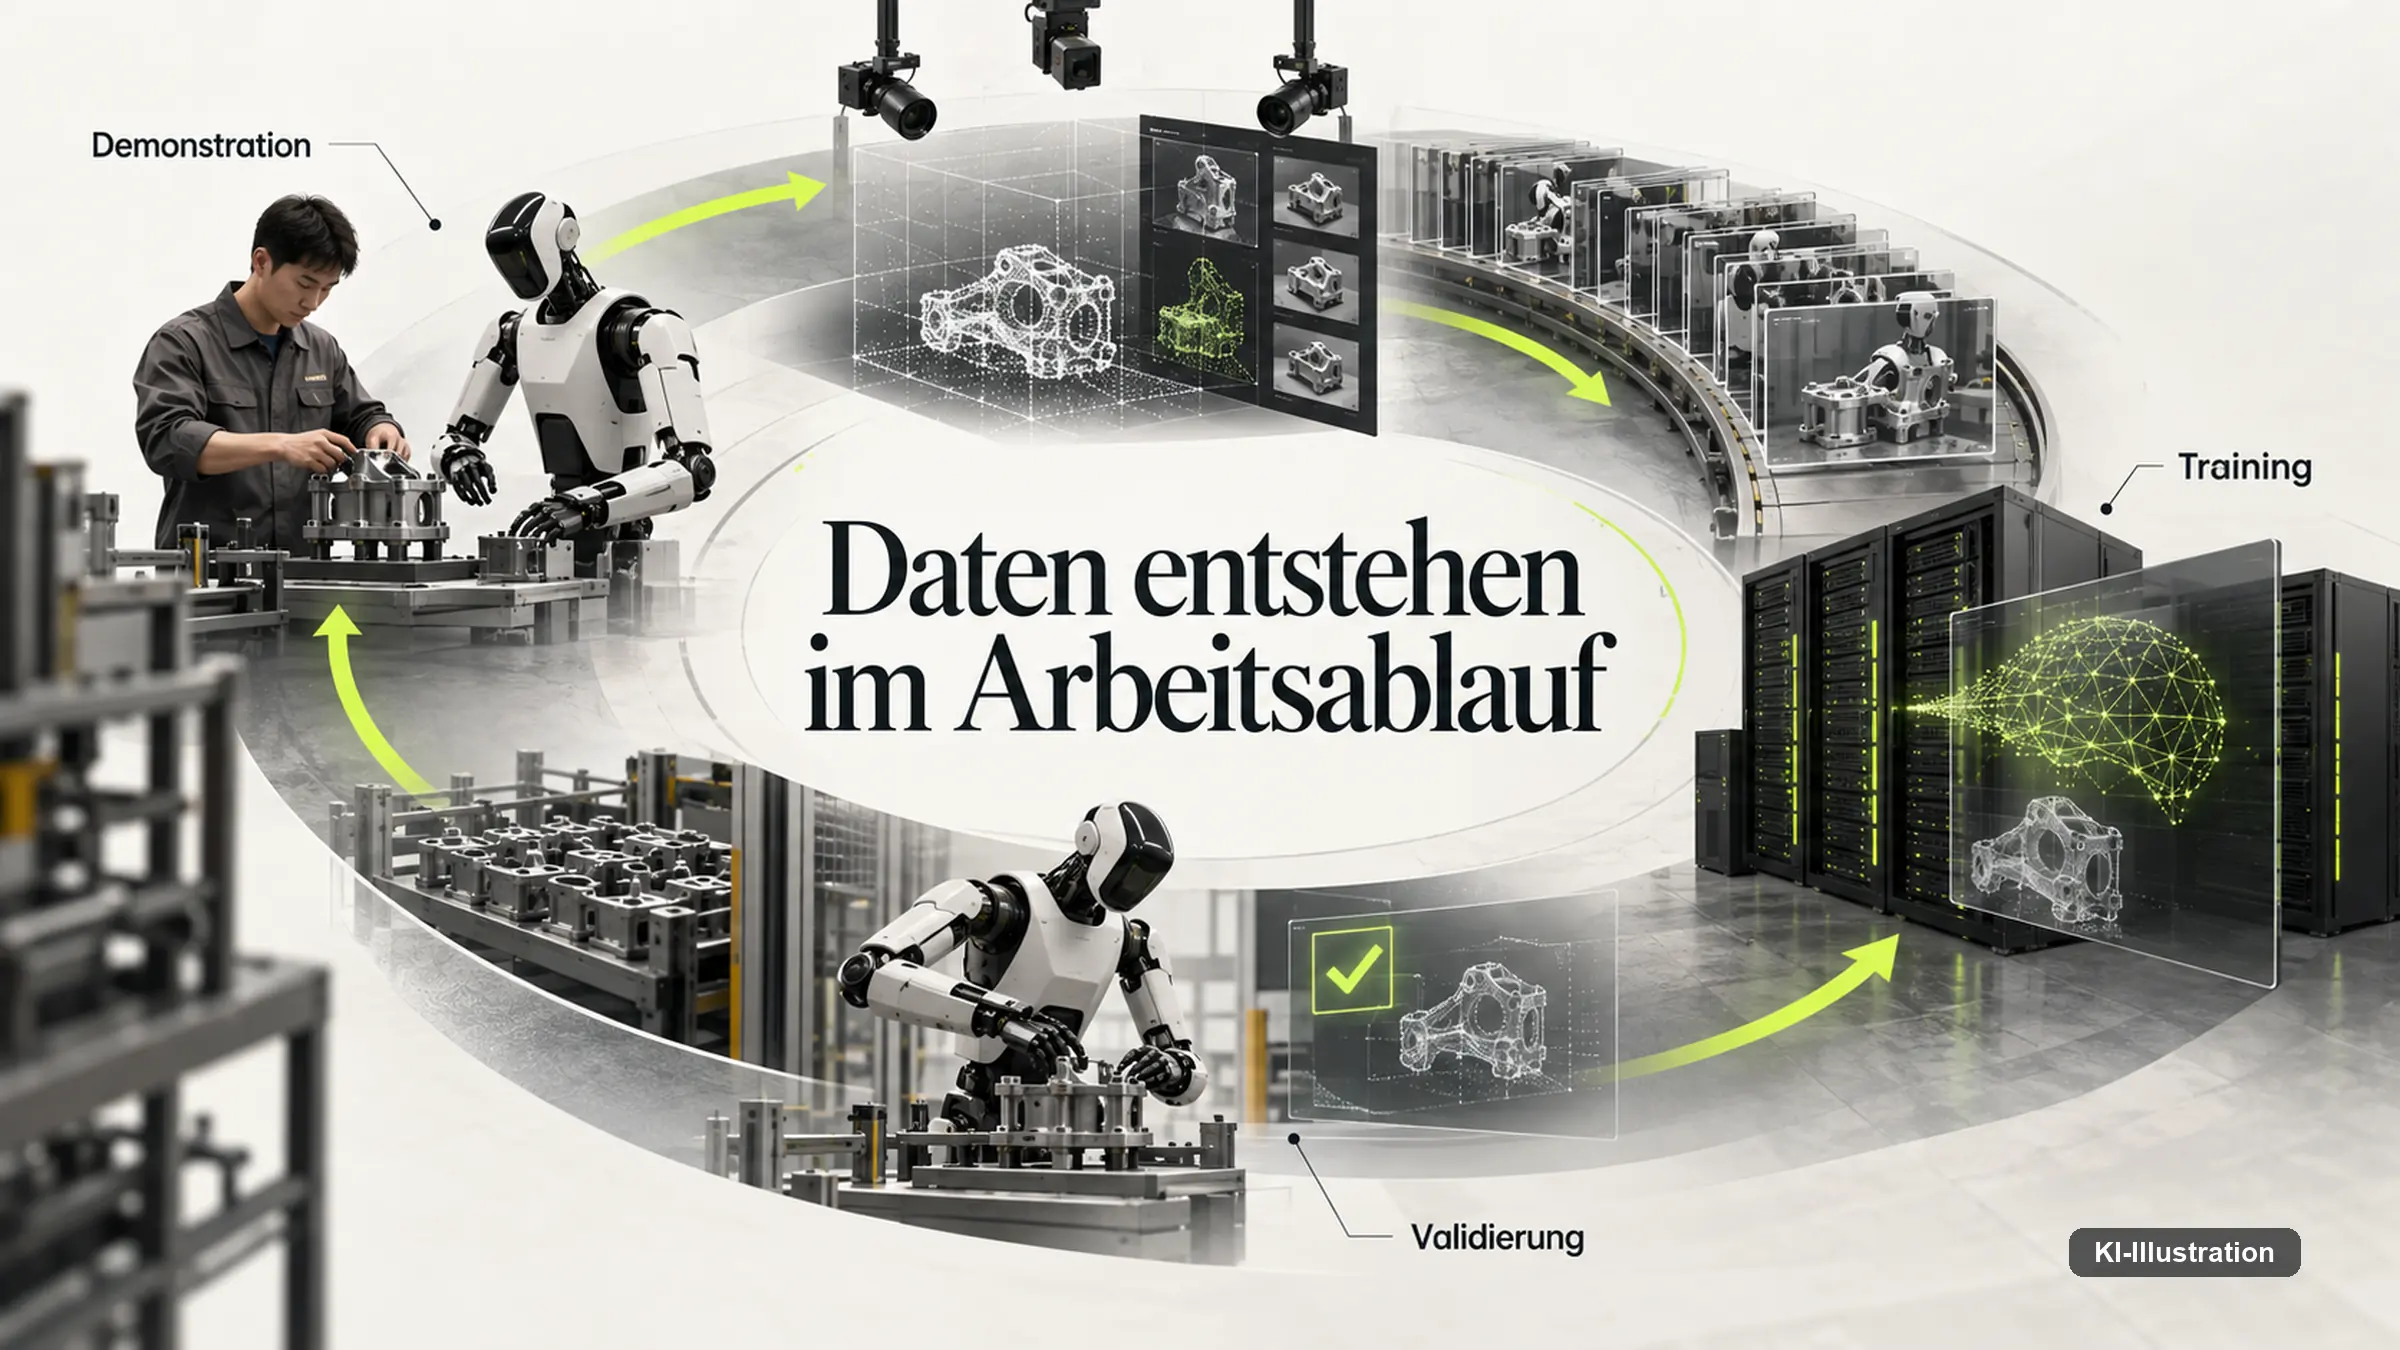
Der Begriff Datenfabrik klingt zunächst nach Marketing, beschreibt den Aufbau der neuen chinesischen Zentren jedoch erstaunlich genau. Am Anfang steht keine Maschine, sondern eine Aufgabenbeschreibung – etwa: Ein Gegenstand soll aus einem Regal genommen und in einen Behälter gelegt werden. Daraus entsteht eine standardisierte Szene mit festgelegter Regalhöhe, Kamerapositionen und Variationsspielraum, bevor ein Mensch den Vorgang vormacht oder einen Roboter teleoperiert.
Sensoren zeichnen dabei synchron Wahrnehmung, Zustand und Aktion auf. Die eigentliche Arbeit beginnt jedoch erst danach: Daten müssen synchronisiert, beschädigte Sequenzen erkannt, unbrauchbare Versuche aussortiert, Aufgabenabschnitte annotiert und Metadaten ergänzt werden, bevor aus einer Rohaufnahme ein Trainingsbeispiel wird. Die Pekinger Datenbasis beschreibt diesen Prozess mittlerweile ausdrücklich als Abfolge aus Erfassung, Bereinigung, Annotation, Verifikation und Qualitätskontrolle.
Damit ähnelt ein solches Zentrum weniger einem klassischen Robotiklabor als einer Produktionsstätte mit Arbeitsstationen, Taktung, Personal und Ausschuss – nur dass das Produkt kein Bauteil, sondern Erfahrung ist. Ein Forschungsdatensatz muss beweisen, dass eine Methode funktioniert; eine Datenfabrik dagegen muss wiederholbar, planbar und wirtschaftlich skalierbar liefern. Sobald ein Betreiber regelmäßig beantwortet, welche Aufgaben, Objekte, Kamerawinkel oder Fehlerarten im Datensatz noch fehlen, wird aus der Datenerhebung ein industrieller Prozess.
Zur Einordnung: Kapazitäts-, Umsatz- und Erfolgsquotenangaben in diesem Beitrag stammen, wenn nicht anders vermerkt, von Betreibern, Herstellern oder lokalen Behörden – nicht von unabhängigen Prüfstellen. Wo eine Zahl zusätzlich an einer wissenschaftlichen Quelle bestätigt werden konnte, steht das jeweils dabei.
Beijing: die integrierte Datenfabrik hinter X-Humanoid
Beijing besitzt nicht ein einziges Trainingszentrum, sondern mehrere parallele Strukturen. Am größten ist die vom Beijing Humanoid Robot Innovation Center betriebene Beijing Humanoid Embodied Intelligence Robot Data and Training Base; das Zentrum tritt international auch unter dem Namen X-Humanoid auf. Nach Angaben der Stadt Beijing umfasst die Basis knapp 6.000 Quadratmeter und mehr als 40 simulierte Realweltszenarien, von Haushalt und Einzelhandel bis zu industrieller Montage, Logistik und medizinischer Unterstützung, bespielt von mehr als 150 Robotersystemen aus rund 40 Bauformen.
Die angegebene Jahreskapazität liegt bei 180.000 Datenstunden. Bemerkenswerter als diese Zahl ist eine zweite: Knapp 30.000 Stunden sollen bereits extern ausgeliefert worden sein, mehr als 70 Prozent davon an Industriekunden sowie Forschungseinrichtungen. Damit verlässt das Konzept die Ebene eines reinen Forschungsprojekts. Hier entstehen Daten als Infrastrukturleistung für andere Akteure, nicht nur zur Verbesserung der zentrumseigenen Tiangong- und Tianyi-Systeme.
Dazu passt RoboMIND, die vom Zentrum aufgebaute offene Datenfamilie. In ihrer ersten wissenschaftlichen Veröffentlichung umfasste sie rund 107.000 Demonstrationstrajektorien über 479 Aufgaben und vier Roboterausführungen. Im September 2026 meldete das Zentrum mehr als 300.000 veröffentlichte Zweiarm-Trajektorien über mehr als 700 praktische Aufgaben – eine deutliche Erweiterung, deren genaue Versionsbezeichnung und mögliche technische Zusatzmerkmale sich an der Primärquelle jedoch nicht bestätigen ließen und deshalb hier offenbleiben. Wichtig bleibt ohnehin die Einordnung: 300.000 Trajektorien sind keine 300.000 Stunden, und eine hohe Downloadzahl sagt nichts darüber, wie viele Modelle dadurch nachweislich besser wurden.
Auch finanziell ist die Struktur bemerkenswert. Das Beijing Humanoid Robot Innovation Center wurde unter Beteiligung von Industriepartnern und staatsnahen Akteuren gegründet und schloss Anfang 2026 seine erste marktbasierte Finanzierungsrunde über mehr als 700 Millionen RMB ab, unter anderem mit dem Beijing Artificial Intelligence Industry Investment Fund als Geldgeber. Der Staat baut damit nicht jeden Roboter selbst, sondern stellt Kapital, Fläche und Standards bereit, während Unternehmen Hardware, Software und operative Kompetenz liefern. Mit Tiangong besitzt das Zentrum eigene Roboterplattformen, mit RoboMIND veröffentlicht es Datensätze, mit seiner Basis produziert es Trainingsmaterial, und gleichzeitig wirkt es an nationalen Standards mit – eine vertikale Integration, die dem Zentrum eher die Rolle eines Infrastrukturunternehmens gibt als die eines gewöhnlichen Roboterherstellers.
Shijingshan: reale Erfassung trifft synthetisches Weltmodell
Ein zweiter Pekinger Cluster liegt in Shijingshan, wo seit 2025 ein Human-Robot Data Training Center existiert. Im Mai 2026 berichtete die Stadt von knapp 270 Robotersystemen und einer Jahresproduktion von fast 20 Millionen Dateneinheiten über drei Trainingsphasen hinweg. Diese Zahl lässt sich nicht direkt mit den 180.000 Stunden der X-Humanoid-Basis vergleichen, weil der eine Betreiber in Stunden zählt und der andere in Dateneinheiten – eine Lehre, die für den gesamten chinesischen Markt gilt und weiter unten eigens behandelt wird.
Technisch ist Shijingshan trotzdem der interessantere Standort. Die erste Ausbaustufe wird 2026 um 4D-Welterfassung und Weltmodell-Technik erweitert: Mehrkamera-Lichtfeldsysteme sollen Bewegungen, Verformungen und Lichtverhältnisse hochdimensional aufzeichnen, aus denen generative Modelle wiederum neue, virtuelle Varianten erzeugen. Reale und synthetische Daten werden damit nicht mehr als zwei getrennte Lager behandelt: Die Fabrik sammelt reale Physik, erzeugt daraus digitale Repräsentationen und skaliert bestimmte Erfahrungen anschließend virtuell weiter.
Diese Kombination ist deshalb bedeutsam, weil reine Realweltdatenerfassung an physische Grenzen stößt. Ein Raum fasst nur so viele Roboter, ein Operator kann nur eine begrenzte Zahl an Stunden arbeiten, und Hardware verschleißt. Shijingshan zeigt damit eine zweite Generation der Datenfabrik – nicht nur Roboter plus Teleoperator, sondern Realitätserfassung plus generatives Modell plus Robotiktraining in einem Kreislauf.
Shijingshan war 2026 zugleich Kulisse der World Humanoid Robot Games. Was die Wettkämpfe selbst an Rekorden, Medaillen und Randgeschichten hervorgebracht haben, ordnet die Auswertung zu den Pekinger Trainingsdaten ein. Für die hier beschriebene Infrastruktur zählt nur, dass die Trainingsflächen auch nach dem Ende der Spiele weiterarbeiten.
Shanghai: ein Datennetz statt einer einzelnen Halle
Shanghai verfolgt eine andere Strategie. Im Januar 2025 nahm in Zhangjiang ein Trainingsfeld des National and Local Co-built Humanoid Robot Innovation Center den Betrieb auf, mit mehr als 5.000 Quadratmetern und über 100 heterogenen humanoiden Robotern von Herstellern wie AgiBot, Fourier und Kepler.
Der Begriff heterogen ist entscheidend. Ein Modell, das Daten nur von einem einzigen Roboterkörper sieht, beherrscht dessen Kinematik womöglich perfekt, ohne dass sich das Wissen auf einen anderen Roboter übertragen lässt. Deshalb bindet Shanghai bewusst unterschiedliche Hersteller und Konstruktionen in dieselbe Dateninfrastruktur ein – Vielfalt bei Robotern, Greifern, Umgebungen, Materialien und Fehlertypen ist für ein generalisierbares Modell kein Nebeneffekt, sondern eine funktionale Notwendigkeit.
Der eigentliche Hebel ist inzwischen aber das sogenannte 1+N-System: Zhangjiang bildet das Zentrum, während weitere Trainingsfelder in anderen Regionen nach gemeinsamen Standards liefern und regionale Besonderheiten abdecken – die eine Region etwa industrielle Fertigung, eine andere Textilproduktion oder Logistik. Für das Gesamtnetz nennt die offizielle Dokumentation eine nominelle Kapazität von mehr als einer Million Datenstunden pro Jahr.
Damit verschiebt sich der Engpass. Nicht mehr die Größe einer einzelnen Halle entscheidet, sondern wie viele unterschiedliche Realwelten ein standardisiertes Netzwerk erfassen kann. Das ist organisatorisch anspruchsvoller als eine große Fabrik, weil es gemeinsame Definitionen und eine geteilte Qualitätssicherung braucht – weshalb Standardisierung in nahezu jedem chinesischen Programm so früh auftaucht.
Shenzhen: der dezentrale Datenmarkt
Shenzhen denkt dezentraler als Beijing oder Shanghai. Der im September 2026 veröffentlichte Arbeitsplan für die Robotikindustrie 2026 bis 2028 fordert ausdrücklich, dass Unternehmen selbst Datenfelder aufbauen, und nennt sechs Datenwege: Simulation und synthetische Daten, klassisches Video, Ego- beziehungsweise First-Person-Aufnahmen, UMI-Systeme, Exoskelette und echte Roboterdaten.
Gleichzeitig sollen Robotikhersteller mit industriellen Anwendern zusammenarbeiten und direkt in Fertigung, Logistik und Service sammeln, während kommerzielle Drittanbieter für Erfassung, Bereinigung und Annotation gefördert werden. Der Bezirk Longhua nennt in seinem Regierungsarbeitsbericht beispielhaft die Unterstützung von Noitom beim Aufbau einer Cross-Embodiment Data Factory.
Statt einer gigantischen Zentralfabrik entstehen damit viele kleinere Produzenten. Das könnte langfristig mindestens so wichtig werden wie staatliche Großzentren, denn ein allgemeines Robotermodell braucht nicht nur Stunden, sondern vor allem Unterschiede: andere Wohnungen, andere Werkstücke, andere Lichtbedingungen, andere Roboterkörper. Dezentralisierung kann deshalb selbst zum Qualitätsmerkmal werden.
Wuxi: wenn Trainingsdaten zum Produkt werden
Am deutlichsten wird die Kommerzialisierung in Wuxi. Dort eröffnete im Juli 2026 die von Kaipuyun aufgebaute Embodied-Intelligence-Training-Base im Bezirk Huishan, mit AgiBot als Partner. Nach Angaben der Stadt soll die rund 6.000 Quadratmeter große Anlage langfristig mit 300 AgiBot-Robotern arbeiten, bei einer geplanten effektiven Jahreskapazität von 500.000 Datenstunden und einem über fünf Jahre erwarteten kumulierten Datenumsatz von rund 500 Millionen RMB.
Kaipuyun selbst teilte im September mit, der erste Kundenauftrag habe 1.300 effektive Trainingsstunden erreicht, bei einer Datenabnahmequote von 95,6 Prozent im Testbetrieb – Unternehmensangaben, keine unabhängige Qualitätsprüfung. Bemerkenswert ist trotzdem das Modell dahinter: Wuxi trennt Datenproduktion und Robotermodellentwicklung stärker als die anderen Standorte und macht aus dem Trainingsplatz einen Zulieferer, vergleichbar mit einem Komponentenhersteller.
Daraus lässt sich eine grobe, ausdrücklich hypothetische Rechnung ableiten: Würde die nominelle Kapazität von 500.000 Stunden jedes der fünf Jahre vollständig verkauft und entstünden daraus tatsächlich 500 Millionen RMB Umsatz, ergäbe das im Mittel rund 200 RMB je Datenstunde. Das ist kein beobachteter Marktpreis, sondern zeigt lediglich, wie ein Betreiber intern kalkulieren könnte, während Auslastung, Datenqualität und Kundenprojekte den realen Wert stark verschieben können.
| Standort / Betreiber | Kapazität (Betreiberangabe) | Schwerpunkt | Stand |
|---|---|---|---|
| Beijing / X-Humanoid | 180.000 Datenstunden/Jahr, ca. 30.000 Std. bereits extern ausgeliefert | über 40 Realweltszenarien, RoboMIND-Datensatz, >150 Robotersysteme | operativ, im Ausbau |
| Shijingshan (Beijing) | rund 20 Mio. Dateneinheiten/Jahr (Mai 2026) | 4D-Welterfassung, Weltmodell-Erweiterung 2026 | im Ausbau |
| Shanghai / Zhangjiang (1+N) | >1 Mio. Datenstunden/Jahr, nominell fürs Gesamtnetz | heterogene Roboterflotte, regionale Standorte | im Aufbau |
| Shenzhen (Arbeitsplan 2026–2028) | keine zentrale Kapazitätszahl, viele Einzelanbieter | sechs Datenwege, dezentrale Marktförderung | in Umsetzung |
| Wuxi / Kaipuyun (Huishan) | 500.000 Datenstunden/Jahr geplant, ca. 500 Mio. RMB Umsatz über 5 Jahre | kommerzieller Datenservice für Dritte, Partner AgiBot | eröffnet Juli 2026 |
Die Menschen in der Datenfabrik: von der Fernsteuerung zur Korrektur
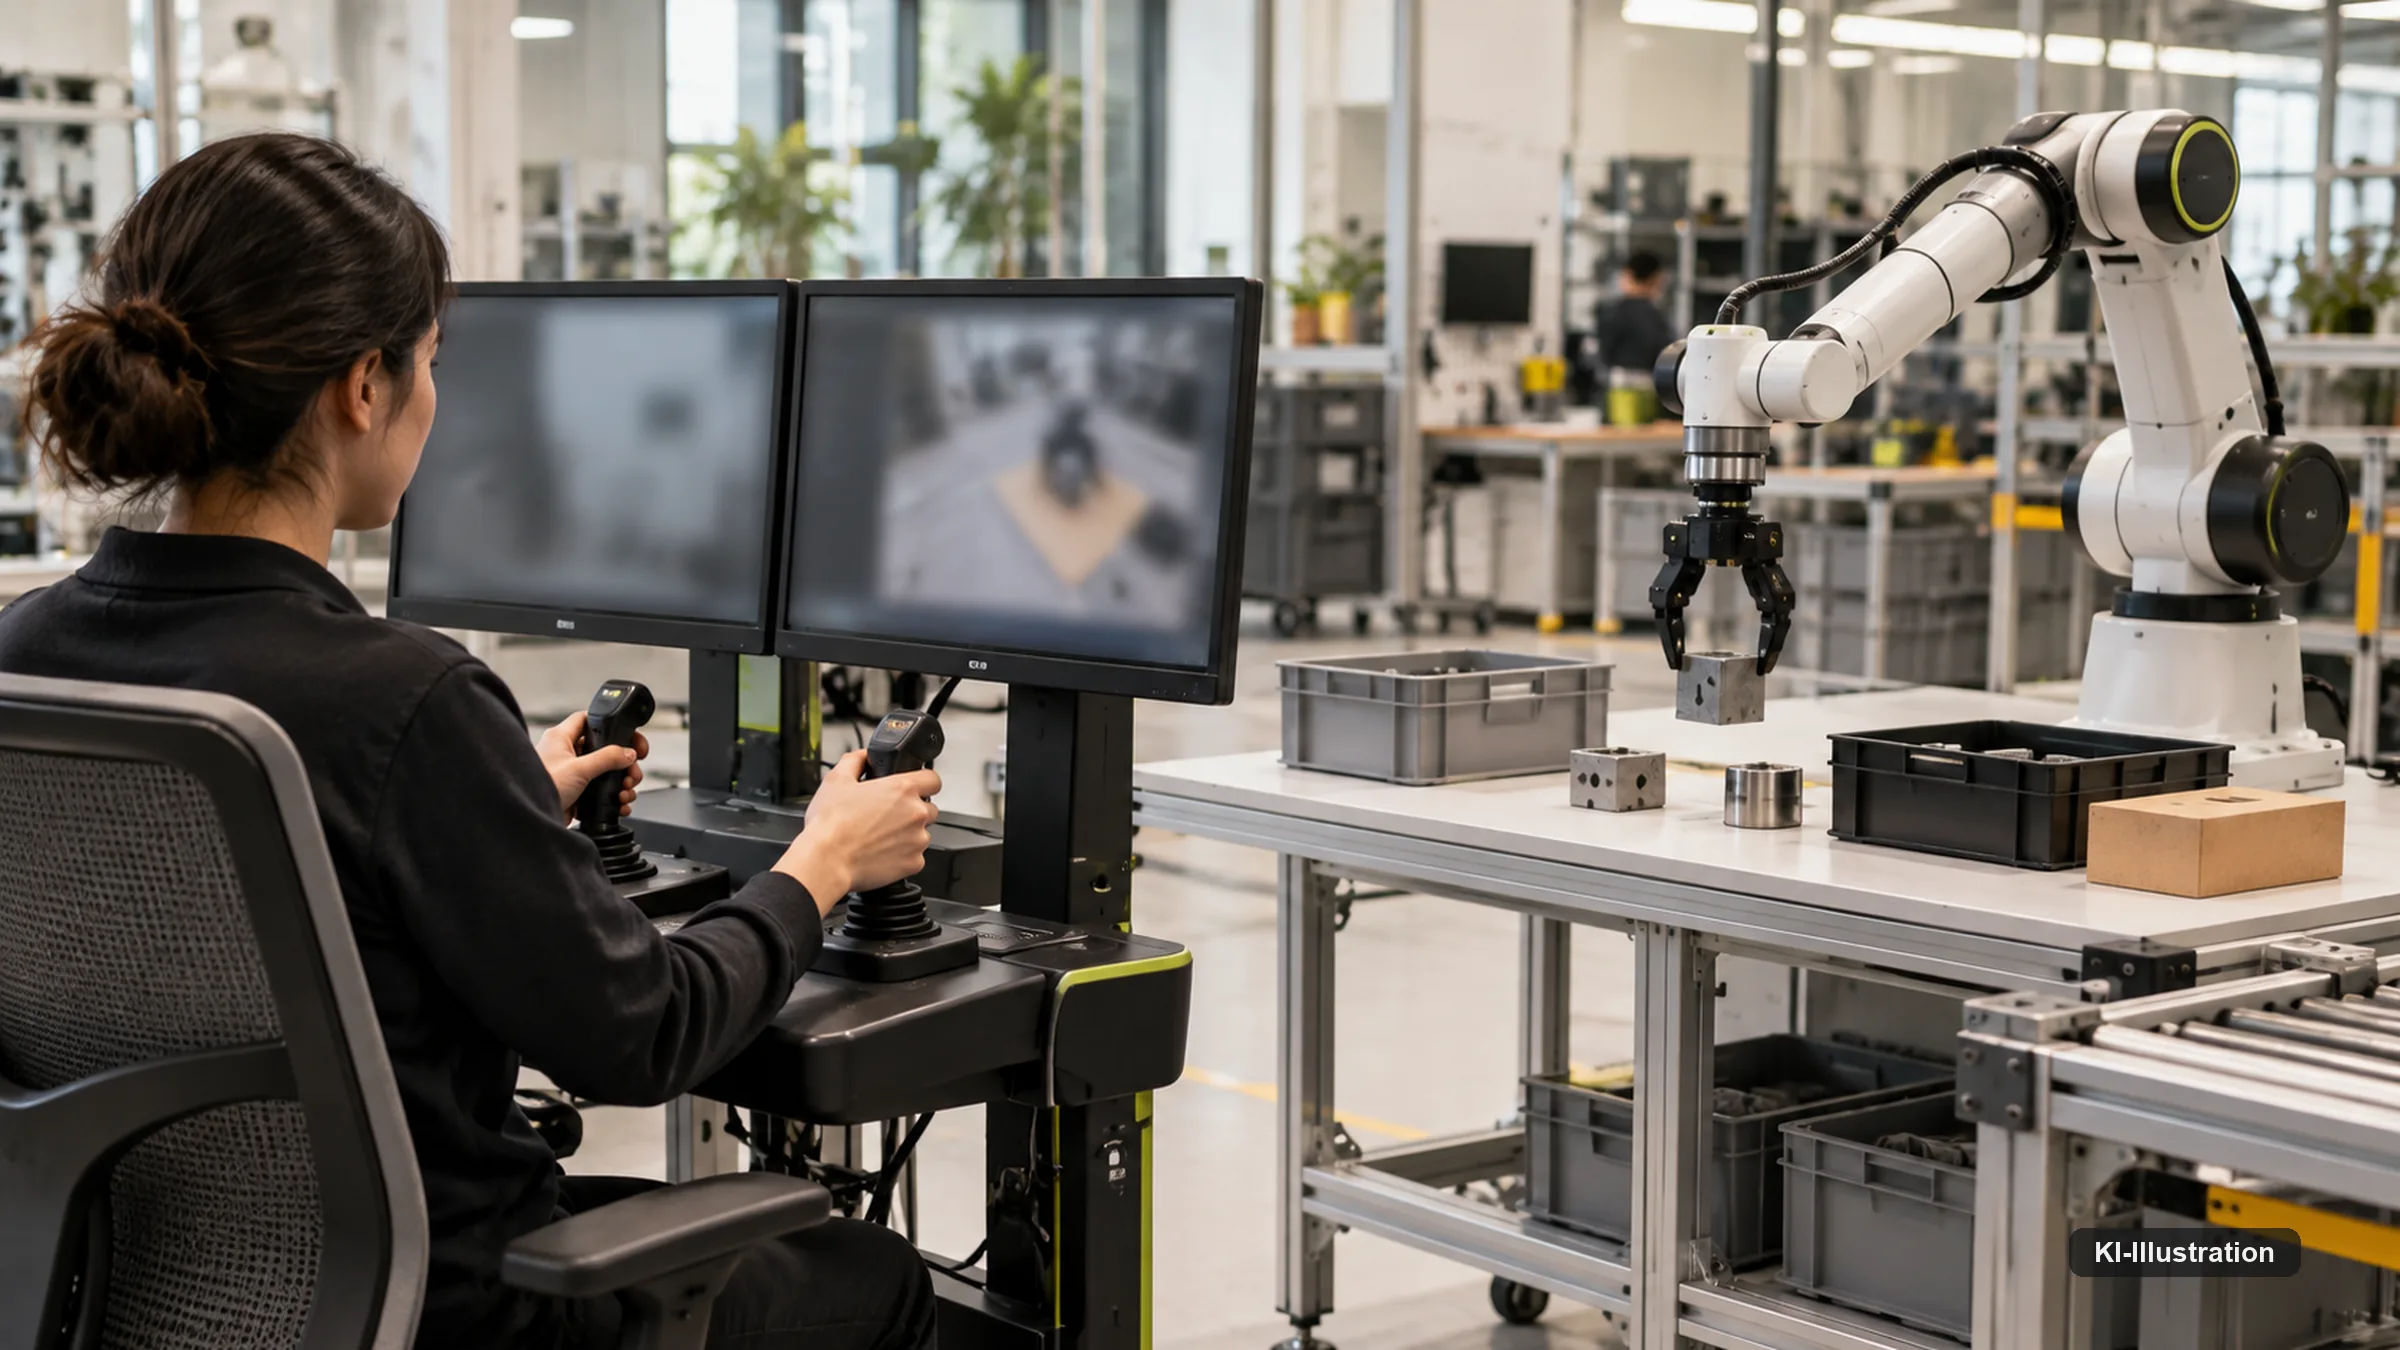
Wer durch Bilder der Trainingszentren scrollt, sieht vor allem Roboter. Ökonomisch mindestens ebenso wichtig sind die Menschen daneben: Datensammler, Teleoperatoren, Motion-Capture-Operatoren, Qualitätsprüfer und Szenarioentwickler, die Beispiele erzeugen, aus denen ein Roboter später ohne sie handeln soll.
Die einfachste Variante bleibt die klassische Teleoperation: Ein Mensch steuert Arme oder den ganzen Körper, während das System Kamerabilder, Gelenkzustände und Kräfte aufzeichnet. Der Vorteil liegt darin, dass die Aktion bereits im Körper entsteht, für den das Modell später Befehle erzeugen muss. Der Nachteil ist, dass eine Stunde Demonstration ungefähr eine Stunde physische Zeit kostet, zuzüglich Vorbereitung und Fehlversuchen. Deshalb experimentiert die Branche zusätzlich mit Human Demonstrations ohne vollständigen Roboter: Beijing beschreibt Datensammler mit speziellen Erfassungsgeräten in simulierten Alltagsszenen, Shenzhen nennt ausdrücklich Ego-Daten und UMI-Systeme, bei denen ein Mensch mit Kamera oder handgehaltenem Greifgerät Aufgaben ausführt, ohne dass ein teurer Humanoid dabei funktionstüchtig sein muss.
Weil eine menschliche Hand jedoch andere Gelenke, Kraftgrenzen und taktile Fähigkeiten hat als eine Roboterhand, wird das sogenannte Retargeting – die Übertragung menschlicher Bewegung auf einen anderen Körper – selbst zu einem zentralen technischen Problem. Mehr Daten bedeuten deshalb nicht automatisch bessere Roboterdaten.
Ein zweiter Wandel betrifft die Rolle des Menschen selbst. AgiBot verfolgt das 2026 mit AGIBOT WORLD Theme 3, das Expertendemonstrationen, autonome Policy-Rollouts, gescheiterte Versuche und menschliche Eingriffe kombiniert; eine Veröffentlichung vom September nennt dafür 11.430 reale Trajektorien über 14 Aufgaben, jeweils mit markierten Fehlern und Interventionen. LimX Dynamics verfolgt denselben Grundgedanken mit COSA 0.5: Der Roboter läuft zunächst selbstständig, ein Experte übernimmt nur bei kritischer Abweichung, und die markierten Fehlerszenen fließen in ein Reward-Modell ein. Der Teleoperator wird damit vom Fahrer zum Lehrer, und ein misslungener Griff oder ein wegkippender Gegenstand liefert dem Modell oft mehr Information als die tausendste identische Erfolgstrajektorie.
Simulation gegen Realität: Galbots Wette und AgiBots Doppelstrategie
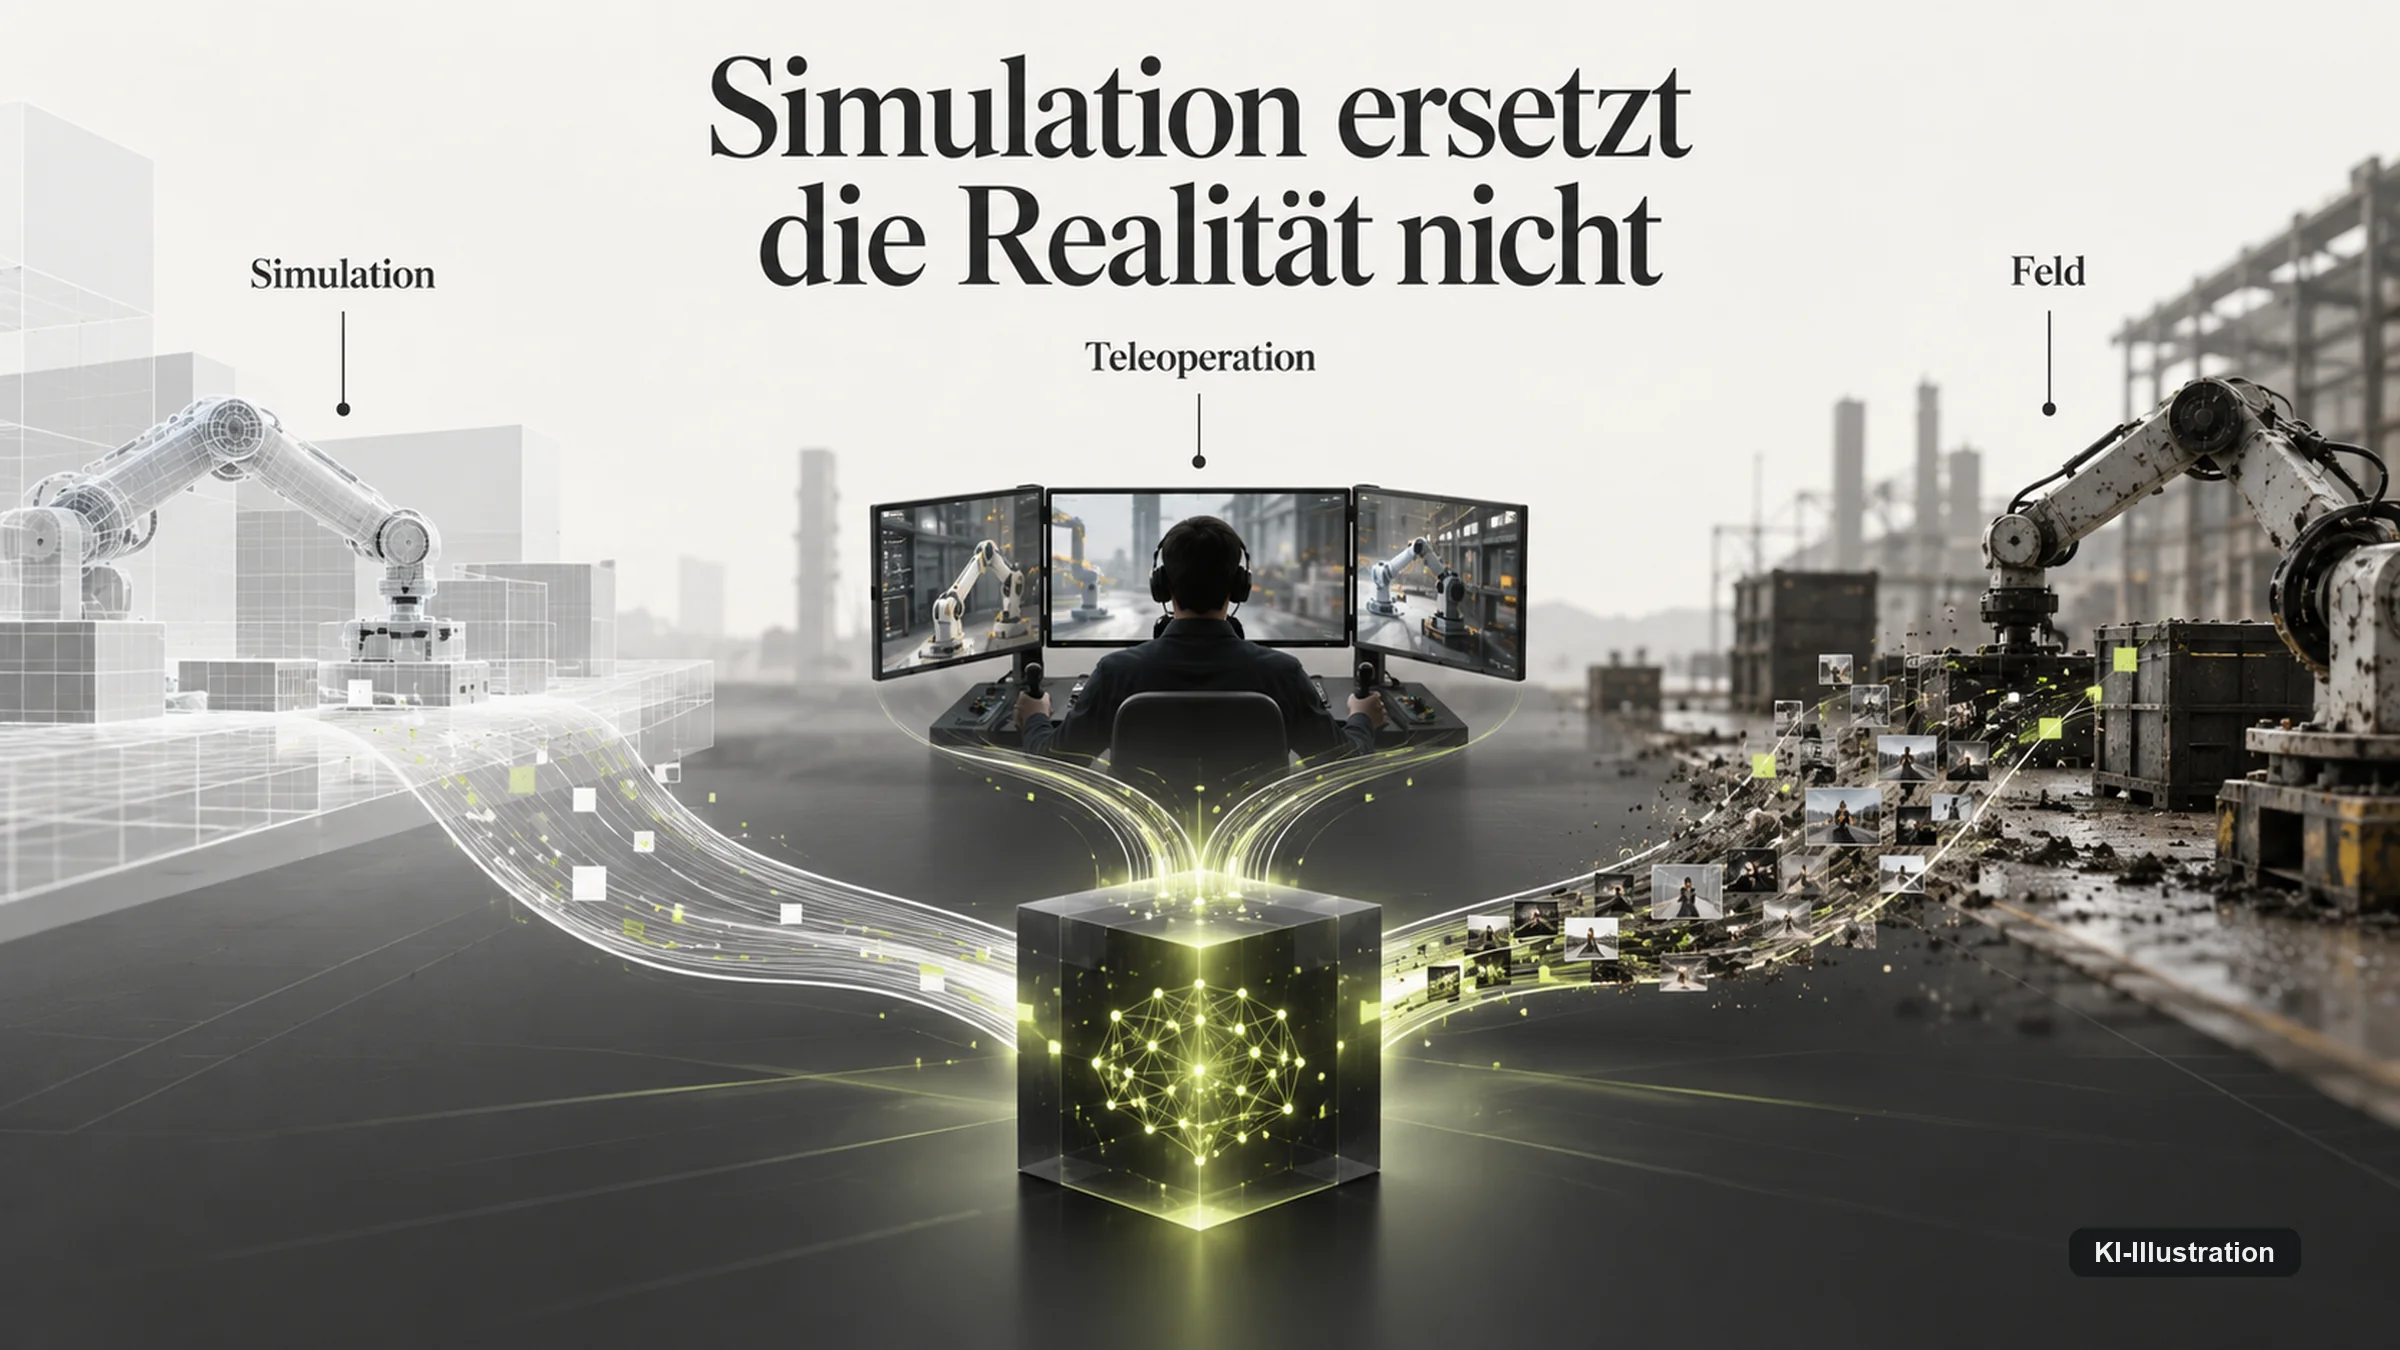
Den radikalsten Gegenentwurf zur realen Datenfabrik liefert Galbots Modellstapel. Das gemeinsam mit Forschern entwickelte GraspVLA wurde auf SynGrasp-1B vortrainiert, einem Datensatz mit einer Milliarde synthetisch erzeugten Frames für Greifaufgaben, mehr als 10.000 Objekten aus 240 Kategorien und umfangreicher Domain Randomization bei Material, Licht, Kameraperspektive und Objektposition.
Das Ziel ist eindeutig: Eine breite Basiskompetenz soll in Simulation entstehen und anschließend mit möglichst wenig realen Daten auf die physische Welt übertragen werden – ein Angriff auf genau den Kostentreiber, der jede Datenfabrik teuer macht. Eine ähnliche Wette auf synthetische Breite verfolgen amerikanische Anbieter wie Nvidia mit seinem GR00T- und Isaac-Ökosystem, nur ohne die chinesische Kombination aus staatlicher Fläche, kommunalem Kapital und Dutzenden beteiligten Herstellern in derselben Halle. GraspVLA konzentriert sich zudem auf Greifen, während ein langes, kontaktreiches Haushalts- oder Industrieproblem erheblich komplexer bleibt. Reale Daten werden dadurch nicht überflüssig, sie werden nur gezielter eingesetzt.
AgiBot setzt stärker auf eine Doppelstrategie. AgiBot World entstand als großer Realweltdatensatz; das zugehörige Colosseo-Paper beschreibt mehr als eine Million Trajektorien über 217 Aufgaben in fünf Anwendungsszenarien, erfasst über standardisierte Pipelines mit Human-in-the-loop-Qualitätssicherung. Daneben betreibt das Unternehmen mit Digital World eine Simulationsumgebung aus 3D-Assets, Physiksimulation und automatisierter Szenengenerierung. 2026 sammeln die neuen AgiBot-World-Themen bewusst jene Realweltdaten, die Simulation besonders schlecht approximiert: Kontakt, Materialverhalten, Kraft, Störungen und Fehler. Simulation liefert die Breite, die reale Welt liefert die Korrektur.
Vom Hersteller zum Infrastrukturanbieter: UBTECH, Unitree und LimX
UBTECH verfolgt einen dritten Schwerpunkt und entwickelt seine Datenstrategie eng an industriellen Anwendungen wie Fahrzeugfertigung, Sortierung und Montage. Das Unternehmen beschreibt eine Pipeline aus Erfassung, Annotation und Verarbeitung und spricht von sehr großen industriellen Trainingsbeständen – eine Größenangabe, die extern nicht im Detail prüfbar ist. Interessanter als diese Zahl ist die organisatorische Position: UBTECH ist Mitinitiator der chinesischen Norm für den Aufbau von Humanoid-Robot-Data-Training-Grounds, gemeinsam mit dem Beijing Humanoid Robot Innovation Center, Xiaomi und weiteren Akteuren. Das spricht für ein Modell, bei dem Trainingsfelder langfristig näher an reale Produktionsstandorte rücken, weil ein Automobilwerk eigene Teile, Toleranzen und Sicherheitsregeln besitzt, die sich in einem künstlichen Supermarkt kaum abbilden lassen.
Unitree zeigt, dass der Markt nicht nur aus Datenlieferanten und Modellunternehmen besteht. Mit G1-D bietet das Unternehmen inzwischen eine komplette Data-and-Training-Plattform an, die Roboterhardware, Datenerfassung, Annotation, Review, verteiltes Modelltraining, Simulation und Deployment umfasst – aufbauend auf der Hardwarelinie des bekannten Unitree G1. Für die Teleoperation wirbt Unitree mit einer Architektur, die Datenströme von Hunderten Robotern gleichzeitig verarbeiten können soll; konkrete Latenz- oder Abtastwerte ließen sich an der Herstellerseite dagegen nicht bestätigen und bleiben deshalb hier unbenannt. Strategisch ist die Richtung trotzdem klar: Der Hersteller verkauft nicht mehr nur einen Roboter, sondern eine Produktionsanlage für Roboterdaten.
Bei LimX‘ vertikaler Datenpipeline verschiebt sich der Schwerpunkt am weitesten von der Demonstration zur selbst erzeugten Erfahrung. Das Unternehmen kombiniert Teleoperation, autonome Rollouts und Real-Robot-Reinforcement-Learning und berichtet für eine Aufräumaufgabe einen Anstieg der Erfolgsquote von 18,01 auf 74 Prozent nach dem Real-Robot-RL-Prozess, über drei untersuchte Aufgaben eine gesunkene Fehlerquote von 39,65 auf 11,33 Prozent – Resultate eines technischen Unternehmensberichts, nicht einer unabhängigen Benchmark-Replikation. Sobald Roboter ausreichend kompetent sind, wird ihre eigene Nutzung selbst zur Datenquelle: Der Roboter arbeitet, gerät in Schwierigkeiten, ein Mensch korrigiert, und beim nächsten Durchgang braucht die Maschine den Menschen idealerweise nicht mehr.
Die sechs vorgestellten Unternehmen setzen an unterschiedlichen Stellen an – bei der Fläche, beim Modell oder beim Werkzeug:
| Unternehmen | Strategieschwerpunkt | Zentrale Kennzahl (Herstellerangabe) | Einordnung |
|---|---|---|---|
| X-Humanoid | vertikale Integration: Hardware, Daten, Standards | RoboMIND-Datensatz, 180.000 Datenstunden/Jahr Basiskapazität | Infrastrukturbetreiber |
| AgiBot | reale Breite plus Simulation | >1 Mio. Trajektorien (Colosseo), 11.430 Trajektorien/14 Aufgaben (Theme 3) | Doppelstrategie |
| Galbot | synthetisches Vortraining | SynGrasp-1B: 1 Mrd. Frames, >10.000 Objekte/240 Kategorien | Simulationswette |
| UBTECH | Training in realen Industrieumgebungen | Mitinitiator der nationalen Norm für Data Training Grounds | Industrienähe |
| Unitree | Verkauf von Dateninfrastruktur statt nur Hardware | G1-D „Data & Training“-Plattform | Werkzeuglieferant |
| LimX Dynamics | autonome Rollouts plus menschliche Korrektur | Erfolgsquote laut Unternehmensbericht von 18,01 auf 74 % (COSA 0.5) | Selbstlern-Kreislauf |
Warum sich Datenstunden nicht einfach vergleichen lassen
Inzwischen werden beinahe wöchentlich neue Rekorde gemeldet: 100.000 Stunden, eine Million Trajektorien, eine Milliarde Frames, 20 Millionen Datenpunkte. Diese Zahlen wirken vergleichbar, sind es aber nicht, weil hinter derselben Einheit völlig unterschiedliche Inhalte stehen können.
Eine Stunde Teleoperation eines humanoiden Roboters kann mehrere synchronisierte Kamerastreams, Gelenkpositionen, Drehmomente und ein klar definiertes Ergebnis enthalten. Eine Stunde Ego-Video besitzt möglicherweise keinen einzigen Roboterzustand, eine Stunde Motion Capture erfasst menschliche Bewegung, aber noch keine direkte Roboteraktion, und eine Stunde autonomer Rollout kann besonders wertvoll sein, wenn sie einen seltenen Fehler enthält. Selbst die Shijingshan-Zahl aus 20 Millionen Dateneinheiten lässt sich mit den 180.000 Stunden der X-Humanoid-Basis nicht direkt verrechnen, weil beide Betreiber schlicht unterschiedliche Einheiten zählen.
Die einfache Kennzahl Datenstunden ist deshalb langfristig unzureichend, und China scheint dieses Problem inzwischen selbst erkannt zu haben – die weiter unten beschriebene Standardisierung ist die direkte Antwort darauf. Wer Kapazitätszahlen aus verschiedenen Städten nebeneinanderlegt, sollte deshalb weniger auf die absolute Zahl schauen als darauf, welche Sensorik, welcher Erfolgsstatus und welche Aufgabenvielfalt tatsächlich dahinterstehen.
Was eine Roboterstunde kostet – und warum das kaum jemand offenlegt
Zu dieser eigentlich entscheidenden Frage gibt es erstaunlich wenige belastbare öffentliche Werte. Man findet Investitionsrunden, Hallengrößen und Kapazitätsziele, aber kaum ein Betreiber veröffentlicht offen seine Vollkosten je akzeptierter Trainingsstunde.
Ein Referenzpunkt stammt aus Guangzhou: Für ein Embodied-Robot-Training-Ground-Projekt eines technischen Colleges wurde 2026 ein Budget von rund 3,9 Millionen RMB ausgeschrieben, darin unter anderem mehrere Robotersysteme, ein Rechenserver, fünf VR-Teleoperationssysteme und eine Datenplattform. Das ist keine industrielle Datenfabrik, zeigt aber, dass bereits eine vergleichsweise kleine Trainingsumgebung erhebliche Investitionen benötigt, bevor die erste produktive Datenstunde entsteht.
Hinzu kommen Löhne. Ein Pekinger Bericht nennt bei einem Anbieter 70 RMB Vergütung je effektiver Erfassungsstunde, für direkte Tagesjobs werden 200 bis 300 RMB genannt, während über Vermittler arbeitende Personen deutlich weniger berichten – Beispiele aus einem jungen Arbeitsmarkt, kein landesweiter Tarif. Die Person vor dem Roboter ist dabei ohnehin nicht der größte Kostenblock: Roboter müssen beschafft, gewartet und nach Stürzen repariert werden, Szenarien müssen aufgebaut und Sensoren kalibriert werden, und ein erheblicher Teil der aufgezeichneten Daten wird nach der Qualitätskontrolle wieder verworfen.
Die eigentlich interessante Einheit ist deshalb nicht RMB je aufgezeichneter Stunde, sondern RMB je Trainingsstunde, die nach Qualitätskontrolle einen messbaren Modellnutzen erzeugt. Wuxis grobe Rechnung von rund 200 RMB je verkaufter Datenstunde zeigt allenfalls, wie ein Betreiber intern denkt – einen belastbaren Branchenbenchmark für die zweite, wichtigere Zahl gibt es bislang nicht.
Standardisierung: YD/T 6771 und die neue Qualitätsordnung
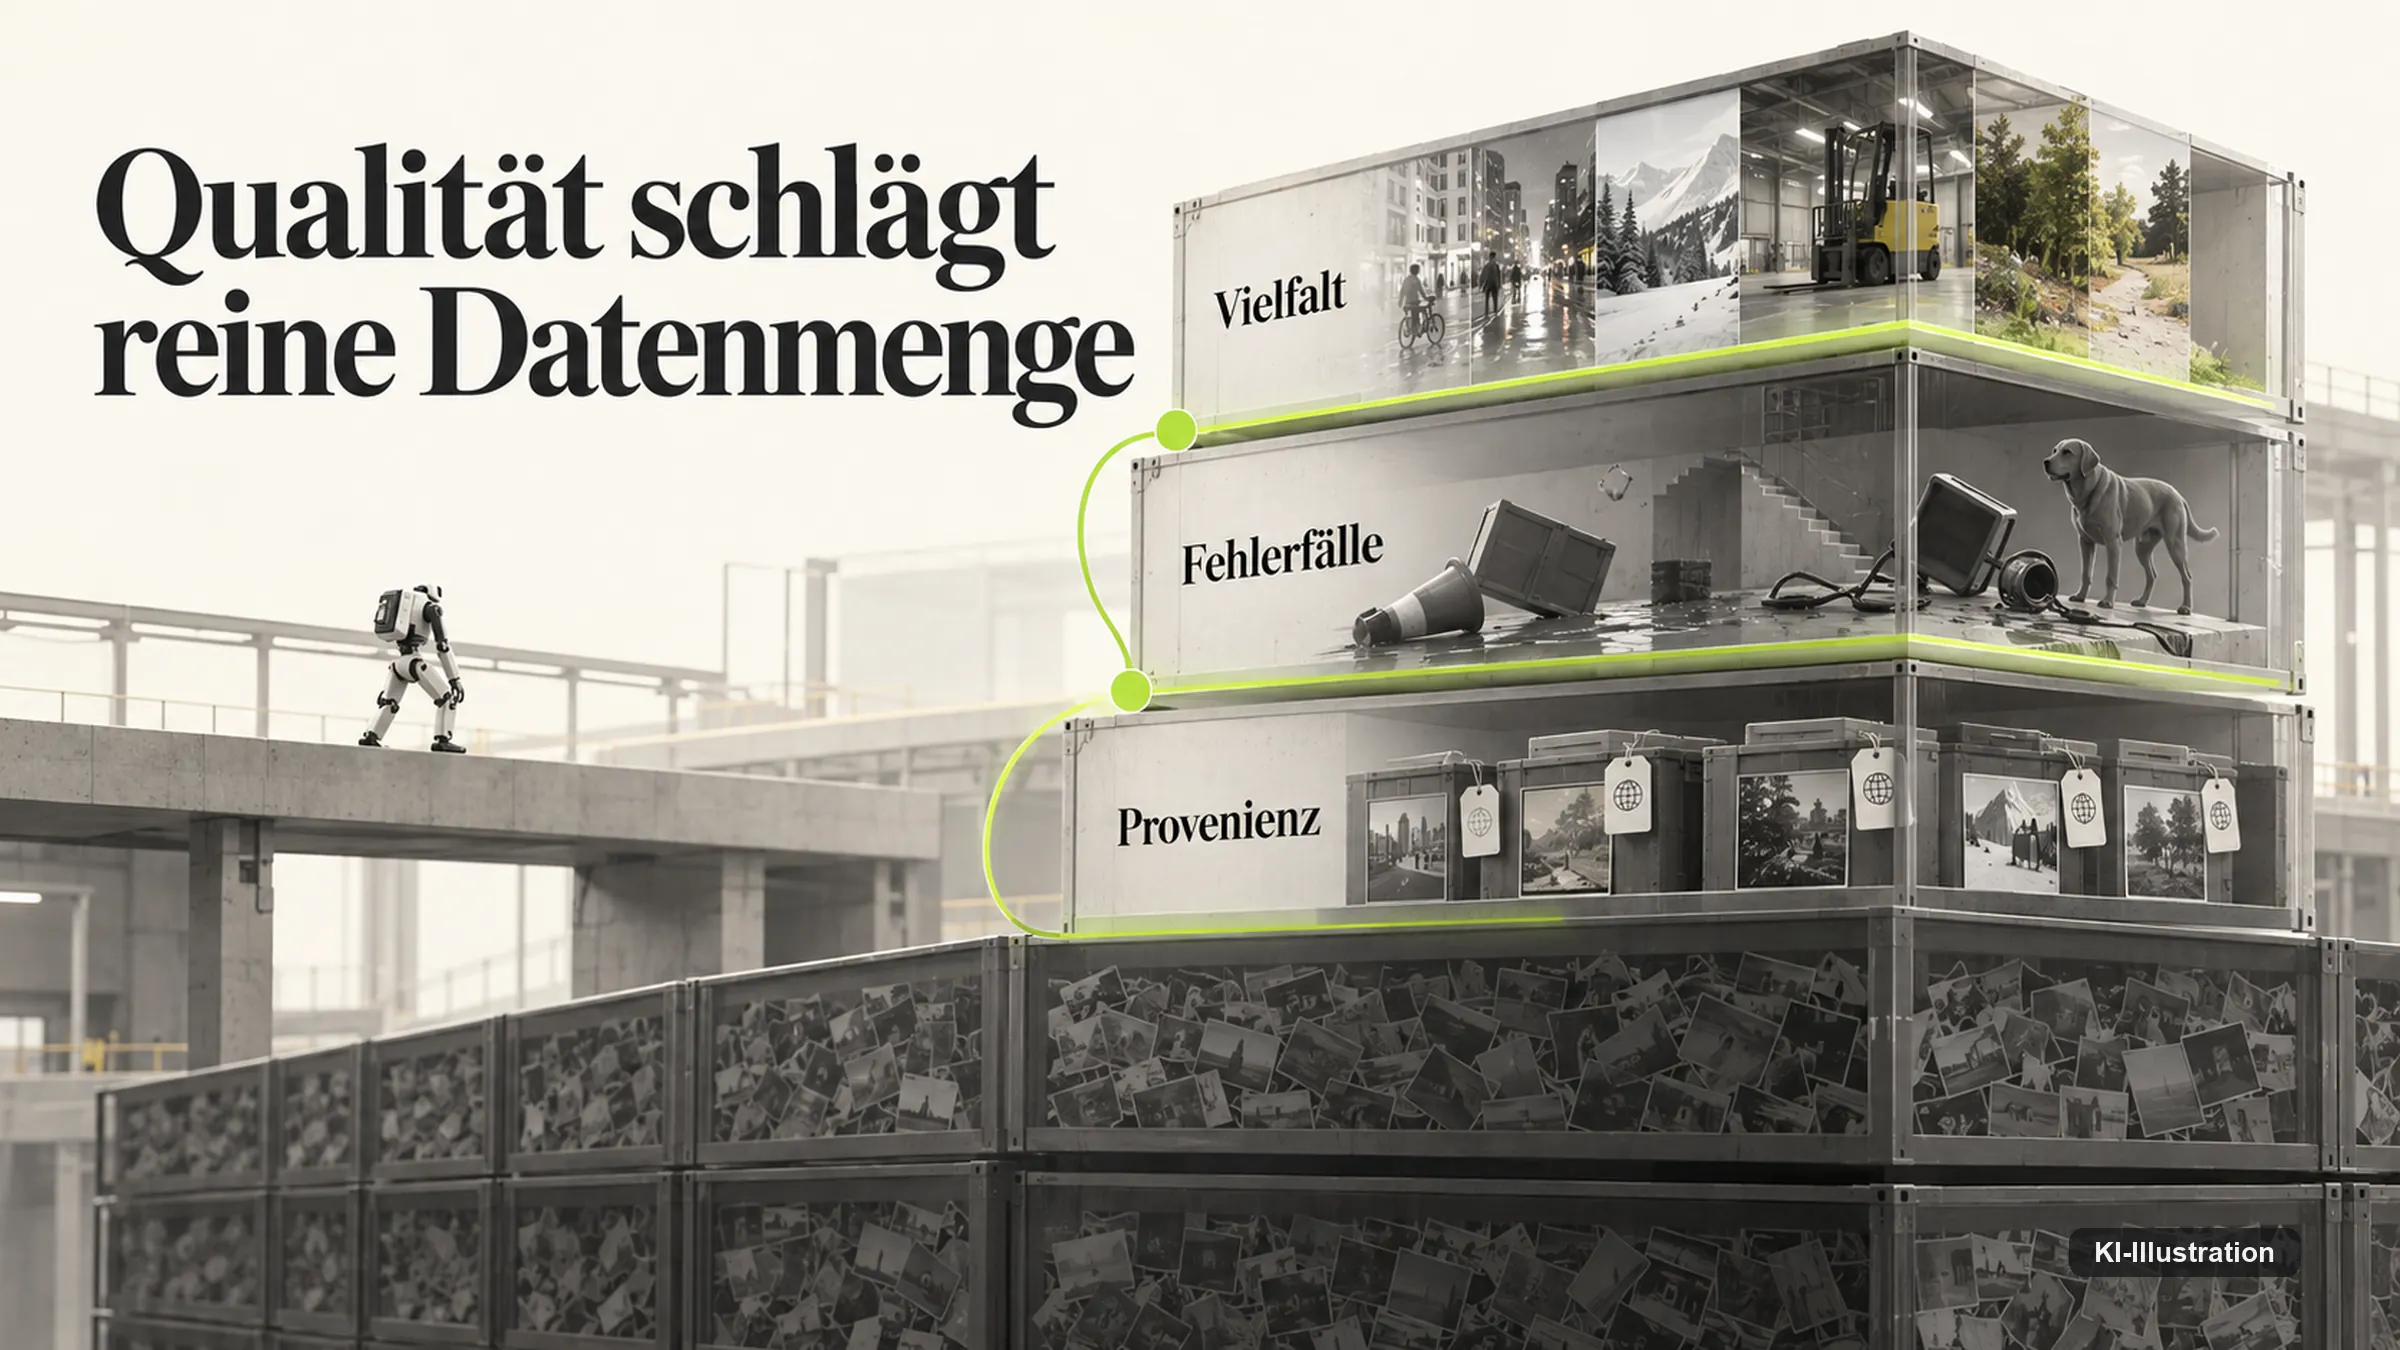
Im Sommer 2026 hat China mit YD/T 6771-2026 einen eigenen Branchenstandard für die Qualität von Embodied-AI-Datensätzen veröffentlicht – am 15. Juli 2026, mit Inkrafttreten zum 1. November 2026. Die Bewertung stützt sich laut öffentlich einsehbarem Geltungsbereich auf drei Oberkategorien: Datenproduktionsvorschriften, organisatorische Sicherungsmechanismen und Qualitätsbewertungsindikatoren.
Am 27. August folgten zwei ergänzende nationale technische Leitdokumente: GB/Z 218.1-2026 zur Qualität realer Embodied-AI-Daten und GB/Z 220-2026 zu den technischen Anforderungen an Plattformen, die solche Daten erzeugen. Parallel befindet sich eine nationale Spezifikation für Humanoid-Robot-Data-Training-Grounds in Ausarbeitung, mit Anforderungen an Funktionszonen, Robotik- und Simulationshardware, Datenmanagement und Betriebssicherheit.
Das klingt trocken, dürfte aber der strategisch wichtigste Teil der ganzen Entwicklung sein, denn Fabriken skalieren erst dann wirklich, wenn Zulieferteile austauschbar werden. Synchronisiert jedes Unternehmen seine Kameras anders, speichert Aktionen anders und annotiert Fehler anders, entsteht kein gemeinsamer Datenmarkt. Standardisierung entscheidet deshalb darüber, ob Daten zwischen Unternehmen und Standorten künftig tatsächlich zirkulieren können.
Für Unternehmen außerhalb Chinas ändert dieser Standard zunächst wenig, weil er ausschließlich den chinesischen Markt regelt. Eine chinesische Qualitätsnorm ersetzt keine Konformität nach der aktuell geltenden Maschinenrichtlinie 2006/42/EG beziehungsweise nach der ab dem 20. Januar 2027 an ihre Stelle tretenden EU-Maschinenverordnung und begründet für sich genommen auch keine Erfüllung der Datengovernance-Pflichten aus Artikel 10 des EU AI Act, die ab Dezember 2027 beziehungsweise August 2028 für Hochrisiko-KI-Systeme gelten. Wer chinesische Trainingsdaten in ein Hochrisiko-KI-System einbaut, das in der EU angeboten wird, bleibt an die eigenen europäischen Pflichten gebunden, unabhängig davon, welche chinesische Norm die Rohdaten erfüllt haben.
Chinas struktureller Vorteil – und seine offenen Fragen
Die entscheidende Stärke Chinas liegt möglicherweise nicht in einem einzelnen humanoiden Roboter, sondern in der Fähigkeit, mehrere industrielle Ebenen gleichzeitig zu koordinieren: große Robotikhersteller, eine enorme Fertigungsbasis, Städte, die reale Industrie- und Serviceszenarien öffnen, öffentliche Finanzierung neben privaten Investoren, Arbeitskräfte für die Datenerfassung und ein Staat, der parallel Standards baut, mit denen diese Teile kompatibler werden.
Im Juni 2026 starteten das chinesische Industrieministerium und die staatliche Vermögensaufsicht eine landesweite Real-Scenario-Training-Initiative, in der Provinzen und zentrale Staatsunternehmen Schwerpunktszenarien für Produktion, Service und Spezialanwendungen mit echter Datenerfassung und anschließender dauerhafter Roboternutzung auswählen sollen. Das verbindet Datenproduktion direkt mit Markteinführung: Ein Automobilwerk wird damit nicht nur Kunde eines Roboters, sondern kann gleichzeitig Trainingsort sein, sodass der spätere Absatzmarkt die Daten liefert, die für seine eigene Erschließung nötig sind.
Allerdings wäre es verfrüht, bereits von einem chinesischen Sieg im Datenrennen zu sprechen. Ein großer Teil der veröffentlichten Zahlen stammt von Betreibern oder lokalen Behörden selbst und ist nicht unabhängig geprüft; ob 180.000, 500.000 oder eine Million Stunden tatsächlich in hoher Qualität produziert, verkauft und nachweislich genutzt werden, ist eine andere Frage als die reine Kapazitätsmeldung. Daten unterschiedlicher Roboter bleiben zudem nur begrenzt kompatibel, weil ein Zweiarm-Radroboter sich anders bewegt als ein zweibeiniger Humanoid, eine Datenmenge löst keine schlechte Modellarchitektur, und die Sim-to-Real-Lücke bleibt bestehen, solange niemand verlässlich weiß, wie schnell der Grenznutzen zusätzlicher Demonstrationen sinkt.
Langfristig dürfte deshalb weniger die gesammelte Menge entscheiden als die Fähigkeit, aus dem Versagen eines eingesetzten Roboters automatisch einen neuen, gezielten Produktionsauftrag abzuleiten – welche Objektarten unterrepräsentiert sind, bei welchem Licht die Wahrnehmung zusammenbricht, welche Fehler zu spät erkannt werden. Ob diese Wette aufgeht, entscheidet sich nicht daran, wie viele Stunden ein Zentrum sammeln kann, sondern daran, ob dieselben Roboter nach jeder neuen Datencharge messbar zuverlässiger werden.
Was heißt das für Sie: die Wettbewerbsfrage für europäische Entscheider
Für einen Automatisierungs- oder Robotik-Verantwortlichen in einem deutschen oder europäischen Industrieunternehmen ist die eigentliche Frage weniger, welche chinesische Zahl am größten ist, sondern ob die eigene Wettbewerbsposition dadurch wirklich unter Druck gerät. Ein Vergleichspunkt hilft dabei: In den USA verfolgen Anbieter wie das oben genannte Nvidia-Ökosystem eine ähnliche Wette auf synthetisches Vortraining, während Ansätze wie Google DeepMinds Gemini Robotics stärker auf reale Demonstrationen und ein einzelnes, breit einsetzbares Modell setzen. Beide Wege sind real, aber keiner verbindet staatliche Fläche, kommunales Kapital und Dutzende Hersteller in derselben Halle so eng wie die chinesischen Zentren – eine vergleichbare öffentlich-private Dateninfrastruktur existiert in Europa bislang nicht.
Zugang ist damit nicht automatisch eine Frage der Erlaubnis, sondern der Folgepflichten. RoboMIND ist als offene Datenfamilie beschrieben und technisch abrufbar. Wer solche Daten aber in ein Hochrisiko-KI-System im Sinn des EU AI Act einbaut, das in der EU angeboten wird, übernimmt damit die eigenen Governance-Pflichten aus Artikel 10: Herkunft, Repräsentativität und mögliche Verzerrungen der Trainingsdaten müssen ab Dezember 2027 beziehungsweise August 2028 dokumentiert werden, unabhängig davon, ob die Rohdaten aus Peking, Kalifornien oder dem eigenen Werk stammen. Das ist keine Rechtsberatung, sondern der Hinweis, dass die chinesische Herkunft einer Zahl die eigene Prüfpflicht nicht ersetzt. Welche Zugangsrechte für die eigenen Roboterdaten der EU Data Act daneben vorsieht — eine von Artikel 10 des EU AI Act getrennte Frage — ordnet ein eigener Beitrag zum Data Act ein.
Zwei grobe Richtungen zeichnen sich für den eigenen Betrieb ab. Für breite, generalisierbare Fähigkeiten – etwa Greifen oder Navigation in Standardumgebungen – kann die Prüfung offener Datensätze oder eine Kooperation mit spezialisierten Datenanbietern günstiger sein als der Aufbau einer eigenen Halle, sofern die Herkunfts- und Governance-Fragen vorab geklärt sind. Für hochspezifische Fertigungsschritte mit sensiblen Werkstücken oder Geschäftsgeheimnissen spricht dagegen mehr für eine kleinere, eigene Erfassung nach dem Vorbild von UBTECHs Ansatz, Training näher an die reale Produktionsumgebung zu holen, statt auf fremde, in einem anderen Rechtsraum entstandene Trainingsdaten zu vertrauen.
Welche Richtung passt, hängt vom einzelnen Anwendungsfall ab und lässt sich nicht pauschal entscheiden. Beobachten lässt sich die Verschiebung trotzdem konkret: Sobald ein chinesischer Anbieter nicht mehr nur Kapazität, sondern nachweisbare Verbesserungen bei realen Kundenrobotern nach jeder neuen Datencharge meldet, ist der Übergang von der Datenfabrik zum funktionierenden Lernkreislauf vollzogen. Genau das, nicht die nächste Rekordmeldung in Stunden oder Trajektorien, wäre der Moment, den ein europäischer Wettbewerber ernst nehmen müsste.
Sind die veröffentlichten Kapazitätszahlen der chinesischen Trainingszentren unabhängig geprüft?
Nein. Nahezu alle Werte – von den 180.000 Datenstunden in Beijing bis zu der mehr als einer Million Stunden im Shanghaier Netzwerk – stammen von Betreibern oder lokalen Behörden selbst. Unabhängige Prüfungen von Auslastung, Qualität oder tatsächlichem Modellnutzen liegen öffentlich nicht vor, was einen realen Ausbau nicht ausschließt, aber bei jedem Zahlenvergleich zur Zurückhaltung mahnt.
Kann synthetische Simulation die reale Datenerfassung für Physical AI vollständig ersetzen?
Nach heutigem Stand nicht. Galbots SynGrasp-1B zeigt, dass eine Milliarde synthetische Frames eine Basiskompetenz im Greifen aufbauen kann, doch komplexe Kontaktvorgänge wie ein verrutschendes Werkzeug bleiben eine Domäne realer Daten. Die meisten chinesischen Anbieter kombinieren deshalb beide Wege, statt sich auf einen festzulegen.
Welche Rolle spielt Teleoperation, wenn Roboter zunehmend autonom Daten sammeln?
Teleoperation bleibt die Grundlage, verändert aber ihre Funktion. Bei Ansätzen wie LimX Dynamics‘ COSA 0.5 oder AgiBots Theme 3 läuft der Roboter zunächst selbstständig, während ein Mensch nur bei kritischen Fehlern eingreift – der Operator wird so vom Steuernden zum Korrigierenden, was den Lernwert je Eingriff laut Unternehmensangaben erhöht.
Was ändert sich für Unternehmen außerhalb Chinas durch den Standard YD/T 6771-2026?
Der Standard regelt zunächst nur den chinesischen Markt und ersetzt keine EU-Anforderungen. Wer Trainingsdaten aus China für ein Hochrisiko-KI-System einsetzt, das in der EU angeboten wird, bleibt an die Datengovernance-Pflichten aus Artikel 10 des EU AI Act gebunden, die ab Dezember 2027 beziehungsweise August 2028 anwendbar werden – unabhängig davon, welche chinesische Norm die Daten ursprünglich erfüllt haben.
Unterscheidet sich der Zugang zu offenen Datensätzen wie RoboMIND von kommerziellen Angeboten wie in Wuxi?
Ja, grundlegend. RoboMIND ist als offene Datenfamilie beschrieben und ohne kommerziellen Vertrag einsehbar, während Wuxis Kaipuyun-Modell Trainingsdaten ausdrücklich als bezahltes Produkt mit Kundenauftrag anbietet. Wer offene Daten nutzt, übernimmt trotzdem die eigenen Governance-Pflichten für das fertige System – der Zugang ist kostenlos, die rechtliche Verantwortung dafür nicht.
Was unterscheidet das Beijing-Modell von Shanghais 1+N-Netzwerk?
Beijing konzentriert Fläche, Roboter und Datenverarbeitung an wenigen großen Standorten wie der X-Humanoid-Basis und Shijingshan. Shanghai verteilt die Erfassung dagegen auf einen Kernstandort in Zhangjiang und mehrere angeschlossene Regionalfelder, die nach gemeinsamen Standards liefern – die eine Struktur setzt auf Konzentration, die andere auf Netzwerkbreite.
Warum lassen sich Datenstunden verschiedener Anbieter nicht direkt vergleichen?
Weil hinter derselben Einheit völlig unterschiedliche Inhalte stehen können. Eine Stunde Teleoperation eines Humanoiden enthält synchronisierte Kamerabilder, Gelenkdaten und Kräfte, eine Stunde Ego-Video oft keinen einzigen Roboterzustand. Erst wenn eine Zahl sagt, welche Sensorik und welcher Erfolgsstatus enthalten sind, wird sie wirklich vergleichbar.
Lohnt sich für ein deutsches Industrieunternehmen eine eigene Datenerfassung statt des Zukaufs chinesischer Trainingsdaten?
Das hängt vom Anwendungsfall ab. Für breite, generalisierbare Fähigkeiten sprechen Kosten und Volumen eher für Zukauf oder Kooperation, für hochspezifische Fertigungsschritte mit sensiblen Werkstücken oder Geschäftsgeheimnissen eher für eine eigene, kleinere Erfassung – eine pauschale Antwort verbietet sich, weil beide Wege unterschiedliche Abhängigkeiten erzeugen.
Was haben die World Humanoid Robot Games in Peking mit den Datenfabriken zu tun?
Wenig direkt. Die Wettkämpfe selbst mit ihren Rekorden und Randgeschichten sind in der Auswertung zu den Pekinger Trainingsdaten dokumentiert. Für die hier beschriebene Infrastruktur zählt nur, dass Beijing und Shijingshan als Trainingsstandorte auch nach dem Ende der Spiele weiterarbeiten.
Quellen & Stand: Angaben der Stadt- und Bezirksregierungen Beijing, Shijingshan, Shanghai, Shenzhen, Longhua, Wuxi und Guangzhou (Kapazitäten, Flächen, Finanzierung, Löhne, Beschaffung); arXiv 2412.13877 (RoboMIND), arxiv.org/abs/2503.06669 (AgiBot World / Colosseo-Paper) und arxiv.org/abs/2505.03233 (SynGrasp-1B) als wissenschaftliche Primärquellen; Unternehmensangaben von X-Humanoid, AgiBot, Galbot, UBTECH (ubtrobot.com), Unitree (unitree.com/G1-D) und LimX Dynamics; SAMR-Standarddokumente zu YD/T 6771-2026, GB/Z 218.1-2026 und GB/Z 220-2026; Bekanntmachung von MIIT und SASAC zur Real-Scenario-Training-Initiative (Juni 2026). Kapazitäts-, Umsatz- und Erfolgsquotenangaben sind, soweit nicht anders vermerkt, Betreiber- oder Herstellerangaben ohne unabhängige Prüfung. Diese Einordnung ist redaktionell und keine Rechts- oder Anlageberatung. Stand: 19. September 2026.