Physical AI & Robotik-KI · Technik erklärt
Vision-Language-Action-Modelle — wie Roboter aus Sehen und Sprache Handeln lernen
Kurz gesagt: Ein Vision-Language-Action-Modell (VLA) nimmt ein Kamerabild und einen Sprachbefehl und erzeugt daraus direkt Bewegungsbefehle für einen Roboter. Sehen, Verstehen und Handeln stecken in einem Modell. Der Begriff entstand 2023 mit Googles RT-2. Die größte Hürde ist nicht die Idee, sondern die Datenknappheit: Anders als Text-KI müssen Bewegungsdaten teuer erzeugt werden. Entsprechend früh steht die Technik im echten Alltag.
Was ein VLA-Modell ist
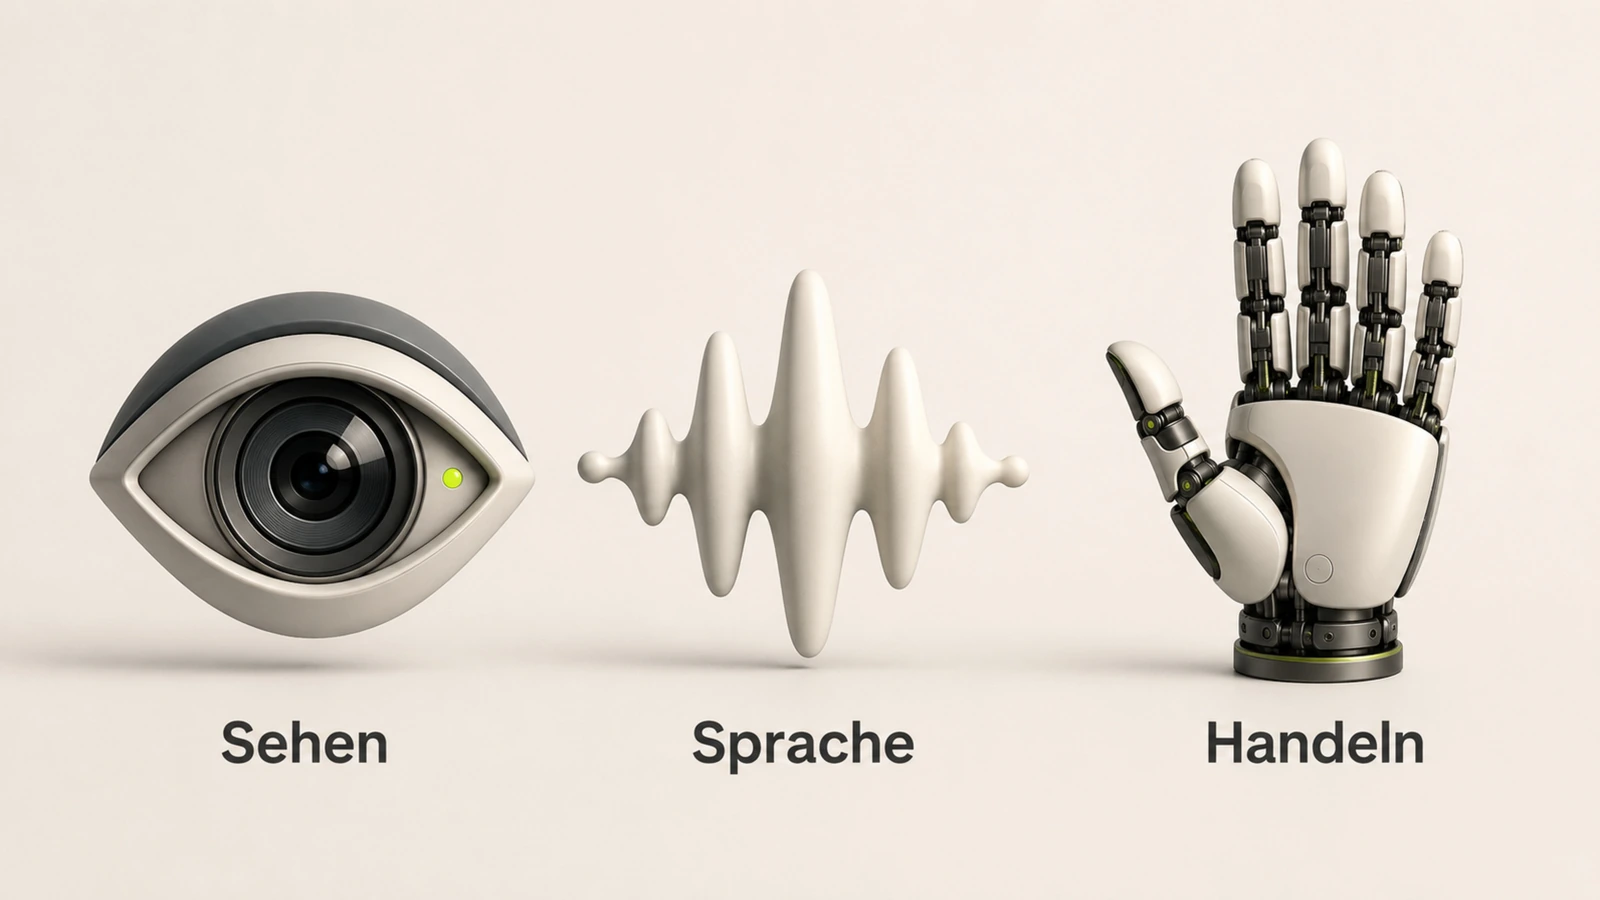
Wenn Sie in Roboter-Ankündigungen über das Kürzel VLA stolpern und wissen wollen, was dahintersteckt und wie weit die Technik wirklich ist, beginnt die Antwort beim Namen. Er steht für Vision, Language und Action, also Sehen, Sprache und Handlung. Ein solches Modell ist das Herzstück moderner Roboter-KI. Es schaut durch eine Kamera, hört einen Befehl in Alltagssprache und erzeugt daraus unmittelbar die passenden Bewegungen.
Damit verbunden ist die Frage, was Sicherheit bedeutet, sobald ein Modell einen Körper steuert.
Früher brauchte ein Roboter getrennte Programme für Bilderkennung, Planung und Steuerung, jeweils mühsam von Hand geschrieben. Ein VLA bündelt sie zu einem einzigen gelernten Modell und ersetzt damit die ganze Kette. So ordnet sich die Technik in das größere Feld der Physical AI ein.
Das klingt simpel, ist aber der Grund, warum Roboter plötzlich so viel flexibler wirken. Ein VLA muss nicht für jede neue Aufgabe umprogrammiert werden. Es überträgt Gelerntes auf neue Situationen, ähnlich wie ein Mensch. Damit verschiebt sich die Arbeit vom Programmieren zum Trainieren, und das verändert die ganze Branche.
Der Unterschied zwischen LLM, VLM und VLA
Am einfachsten verstehen Sie ein VLA im Vergleich zu bekannter KI. Ein großes Sprachmodell, wie es hinter Chatbots steckt, verarbeitet nur Text und gibt Text aus. Es kann schreiben, aber nichts sehen und nichts bewegen.
Ein Vision-Language-Modell, kurz VLM, kann zusätzlich Bilder verstehen. Es beschreibt, was auf einem Foto zu sehen ist, gibt aber weiterhin nur Text zurück. Es bleibt ein Beobachter ohne Hände.
Das VLA fügt die Handlung als dritte Stufe hinzu. Google beschreibt sein System Gemini Robotics ausdrücklich als Vision-Language-Modell, das physische Aktionen als neue Ausgabeform gelernt hat. Aus dem Beobachter wird ein Akteur.
Wie ein VLA funktioniert
Der Trick der ersten großen VLAs war verblüffend einfach. Googles RT-2 behandelt Bewegungen wie Wörter. Positionen, Drehungen und der Zustand des Greifers werden in kleine Bausteine zerlegt, sogenannte Token, genau wie Text in einem Sprachmodell.
Dadurch wird Robotersteuerung zur Vorhersage der nächsten Bausteine. Das Modell fragt sich fortlaufend, welcher Bewegungsbaustein als Nächstes kommt, so wie ein Chatbot das nächste Wort vorhersagt. Dieselbe bewährte Mechanik treibt also plötzlich einen Roboterarm an. Weil diese Methode auf der Technik der Sprachmodelle aufsetzt, konnte die Robotik enorm vom KI-Boom profitieren. Fortschritte bei Chatbots übertragen sich teilweise direkt auf Roboter. Das erklärt das hohe Tempo der letzten Jahre.
Warum Internet-Wissen hilft
Ein VLA lernt nicht nur aus Roboterdaten. RT-2 wurde gemeinsam mit Bild-Text-Daten aus dem Internet trainiert. Dadurch versteht das Modell Dinge, die es nie als Roboterbeispiel gesehen hat.
Weiß das Modell aus dem Web, wie eine Banane aussieht, kann es sie greifen, auch ohne je an einer Banane geübt zu haben. Dieses Allgemeinwissen ist der Hebel für die Verallgemeinerung. Es macht den Unterschied zwischen einem starren Automaten und einem flexiblen Helfer.
Der konzeptionelle Durchbruch steckt genau darin, dass Roboter das Weltwissen der Sprach- und Bildmodelle erben. Sie starten nicht mehr bei null, sondern bringen ein grobes Verständnis der Welt schon mit.
Dieses geerbte Wissen hat aber auch Grenzen. Zu wissen, wie eine Banane aussieht, heißt nicht, sie sicher greifen zu können. Das Modell muss die Handlung trotzdem üben, denn Anfassen ist etwas anderes als Erkennen. Internet-Wissen liefert also den Startvorsprung, nicht die fertige Fähigkeit.
Das Dual-System: langsam denken, schnell handeln
Ein großes KI-Modell ist klug, aber langsam, und Motorik braucht Tempo. Deshalb nutzen moderne VLAs oft zwei Systeme. Ein großes Modell denkt und plant mit niedriger Taktrate, ein kleines Modell steuert die Bewegung blitzschnell.
Figures VLA namens Helix macht das anschaulich. Nach Figure-Angaben arbeitet das denkende System 2 mit rund 7 Mrd. Parametern nur einige Male pro Sekunde. Das ausführende System 1 mit rund 80 Mio. Parametern steuert die Motoren dagegen extrem schnell und flüssig.
Diese Arbeitsteilung ist der aktuelle Standardtrick, um Denken und Handeln zu verbinden. Sie ähnelt dem Menschen, der über eine Handlung nachdenkt und sie zugleich reflexartig ausführt. Der Ansatz löst zugleich ein handfestes Tempoproblem. Ein großes Modell braucht für jede Entscheidung Zeit, doch ein Greifer, der zu spät reagiert, lässt das Glas fallen. Das schnelle System überbrückt diese Lücke und hält die Bewegung stabil, während das langsame System die nächste Teilaufgabe plant.
Wie ein VLA trainiert wird
VLAs lernen überwiegend durch Nachahmung. Ein Mensch führt den Roboter per Fernsteuerung durch eine Aufgabe, das sogenannte Teleoperieren, und das Modell ahmt diese Vorführungen nach. Je mehr saubere Vorführungen, desto besser das Ergebnis.
Das offene Modell OpenVLA etwa wurde auf 970.000 echten Roboter-Vorführungen trainiert und umfasst rund 7 Mrd. Parameter. An dieser Zahl hängt der ganze Aufwand, denn jede einzelne Vorführung musste physisch erzeugt werden, in Echtzeit, mit echter Hardware.
Ergänzend trainieren viele Systeme in Simulation. Dort lassen sich Millionen Versuche günstig durchspielen. Doch die Simulation ist nur eine Näherung der Wirklichkeit, weshalb der Schritt zurück in die echte Welt oft schwierig bleibt.
Wie viel Aufwand darin steckt, zeigt der Vorläufer RT-1. Seine Trainingsdaten wurden mit 13 Robotern über 17 Monate in einer echten Büroküche gesammelt. Bewegungsdaten sind deshalb so kostbar, weil sie in Echtzeit entstehen, Aufgabe für Aufgabe, mit echter Hardware und echten Menschen.
Das Datenproblem der Robotik
Hier liegt der eigentliche Engpass des ganzen Feldes. Ein Sprachmodell lernt aus dem halben Internet, doch für Roboterbewegungen gibt es keine vergleichbaren Mengen. Bewegungsdaten sind teuer, langsam und rar.
Die Zahlen belegen das Missverhältnis deutlich. Weltweit arbeiten über 3,9 Mio. Industrieroboter, aber der größte offene Datensatz für Manipulation umfasst nur rund 1 Mio. Beispielabläufe. Ein geübter Bediener erzeugt pro Stunde nur wenige Abläufe, und die Qualität sinkt mit der Ermüdung.
Genau dieser Datenhunger entscheidet über das Tempo der Branche. Er erklärt auch, warum viele scheinbar autonome Roboter in Wahrheit noch teilweise ferngesteuert werden.
Open X-Embodiment und geteilte Daten
Weil einzelne Firmen die Datenlücke kaum allein schließen, entstand ein gemeinsamer Ansatz. Das Projekt Open X-Embodiment bündelt Roboterdaten von vielen Laboren, über 22 Roboterplattformen und 34 Institutionen hinweg. Alle profitieren vom Datenschatz der anderen.
Dieser geteilte Datensatz diente unter anderem als Grundlage für OpenVLA. Der Gedanke dabei ist, dass ein Modell besser verallgemeinert, wenn es Daten verschiedener Roboterkörper gesehen hat. Es lernt nicht nur einen Roboter, sondern das Prinzip des Greifens und Bewegens.
Solche Gemeinschaftsprojekte sind ein Gegenmittel zur Datenknappheit. Sie zeigen, dass die Robotik-KI neben der Konkurrenz auch von offener Zusammenarbeit lebt.
Physical Intelligence geht mit seinem Modell π0 einen ähnlichen Weg. Es ist als Generalist über verschiedene Roboterkörper angelegt und teils offen verfügbar. Die Nachfolge π0.5 zielt ausdrücklich darauf, auch in zuvor ungesehenen Wohnungen zurechtzukommen. Ob das im Alltag hält, muss sich erst zeigen, doch die Richtung führt weg vom Einzelroboter und hin zum breit einsetzbaren Modell.
Die wichtigsten VLA-Systeme
Inzwischen gibt es eine ganze Familie von VLA-Modellen. Den Anfang machte Googles RT-2, gefolgt vom quelloffenen OpenVLA aus der akademischen Forschung. Beide legten die technischen Grundlagen, auf denen bis heute andere Modelle aufbauen. Im industriellen Greifen setzt das Pick-Modell Cortex von Sereact dieselbe Modellklasse ein, ergänzt um ein World Model.
Heute prägen mehrere Systeme das Feld, jedes mit eigenem Schwerpunkt.
| System | Anbieter | Besonderheit | Offen? |
|---|---|---|---|
| RT-2 | Google DeepMind | prägte den Begriff VLA (2023) | nein |
| OpenVLA | Forschung (Stanford u. a.) | 7 Mrd. Parameter, quelloffen | ja |
| π0 / π0.5 | Physical Intelligence | Generalist, teils offen | teils |
| GR00T N1 | Nvidia | Grundmodell für Humanoide | teils |
| Gemini Robotics | Google DeepMind | auf Gemini aufgebaut | nein |
| Helix | Figure | Dual-System, läuft an Bord | nein |
Mehr zu einzelnen Systemen steht im Beitrag zu Nvidia GR00T. Den Google-Ansatz prüft der Gemini-Robotics-Faktencheck, und die Modelle im direkten Vergleich der KI-Gehirne ordnet ein eigener Beitrag ein.
Wo VLAs an Grenzen stoßen
So beeindruckend die Technik ist, ihre Grenzen sind real. Außerhalb der geübten Situationen wird ein VLA schnell unzuverlässig. Kleine Änderungen in Licht, Anordnung oder Aufgabe können es aus dem Tritt bringen.
Nach dem unabhängigen Stanford AI Index 2026 gelingen echte Aufgaben im Alltag nur in rund 12 % der Fälle, also mit etwa 88 % Fehlerquote. Die vollständigen Zahlen und ihre Einordnung stehen im Überblick zu Physical AI. Hinzu kommt die Latenz, denn große Modelle sind für flüssige Motorik oft zu langsam, weshalb der Dual-System-Trick nötig ist.
Für Herstellerangaben brauchen Sie dabei einen eigenen Maßstab. Aussagen wie „handhabt Objekte ohne vorheriges Üben“ stammen meist aus Firmen-Demos, nicht aus neutralen Tests. Sie sind interessant, aber kein Beleg für den Alltag.
Auch die Verallgemeinerung über Roboterkörper hinweg macht Probleme. Ein VLA, das auf einem bestimmten Arm trainiert wurde, funktioniert auf einer anderen Bauform oft schlechter. Genau daran arbeiten die neuesten Modelle, doch gelöst ist es noch nicht. Bis dahin bleibt jeder Wechsel der Hardware eine echte Hürde.
Vom Labor zum ersten Einsatz
Trotz aller Grenzen verlassen erste VLAs das Labor. Figure etwa testet seinen Humanoiden mit dem Modell Helix in einem Pilot-Projekt beim Autobauer BMW im Werk Spartanburg. Dort übernimmt der Roboter einfache, wiederkehrende Logistikschritte in einer kontrollierten Umgebung.
Die meisten VLA-Systeme sind noch Prototyp oder laufen in eng begrenzten Pilot-Projekten, und das ist bezeichnend für den aktuellen Stand. Der breite Serieneinsatz ist eher angekündigt als Realität. Fabrik und Lager gehen voran, weil die Umgebung dort vorhersehbar und immer gleich aufgebaut ist.
Der Grund für diese Reihenfolge ist dieselbe Datenfrage wie zuvor. In einer kontrollierten Halle sind die Aufgaben eng und wiederholbar, das VLA muss weniger verallgemeinern. Im offenen Alltag dagegen ist jede Situation neu. Genau deshalb sehen Sie Roboter zuerst in der Industrie und erst viel später im Wohnzimmer.
Warum das für Sie zählt
Auch wenn Sie kein Modell trainieren, betrifft Sie die VLA-Technik, denn sie entscheidet, was ein Roboter wirklich kann. Zwei Maschinen mit gleicher Hardware können je nach VLA völlig verschieden fähig sein.
Beim Blick auf einen neuen Roboter lohnt darum die Frage nach dem Modell dahinter. Läuft es an Bord oder in der Cloud? Ist es offen oder geschlossen? Wurde die Vorführung im Labor oder im echten Alltag gefilmt?
Mit diesen Fragen durchschauen Sie Marketing schneller. Das VLA ist das Gehirn, und das Gehirn bestimmt den Nutzen. Für den Kauf eines Roboters heißt das ganz praktisch, dass ein günstiger Körper mit schwachem Modell wenig nützt und ein teurer mit starkem Modell viel. In den nächsten Jahren dürfte sich der Wettbewerb genau hier entscheiden.
Fazit
VLA-Modelle sind der Grund, warum Roboter gerade so viel flexibler werden. Sie verbinden Sehen, Sprache und Handlung in einem gelernten Modell und erben Weltwissen aus dem Internet. Damit lösen sie sich vom starren Programmieren früherer Roboter.
Zugleich bremst der Datenmangel das Feld, und die Zuverlässigkeit im Alltag ist noch gering. Die Technik ist ein echter Durchbruch, aber einer mitten in der Entwicklung. Verstehen Sie sie, ordnen Sie die nächsten Roboter-Neuheiten deutlich klarer ein.
Was ist ein VLA-Modell einfach erklärt?
Ein Vision-Language-Action-Modell nimmt ein Kamerabild und einen Sprachbefehl und erzeugt daraus direkt Bewegungsbefehle für einen Roboter. Sehen, Verstehen und Handeln stecken in einem einzigen gelernten Modell, statt in getrennt programmierten Bausteinen.
Was ist der Unterschied zwischen VLA, VLM und LLM?
Ein LLM (Sprachmodell) verarbeitet nur Text. Ein VLM versteht zusätzlich Bilder, gibt aber weiter nur Text aus. Ein VLA fügt die Handlung als dritte Stufe hinzu und steuert damit einen echten Roboter. Aus dem Beobachter wird ein Akteur.
Woher kommt der Begriff Vision-Language-Action?
Von Googles RT-2, vorgestellt 2023 als erstes großes Modell, das Sehen und Sprache direkt in Roboteraktionen übersetzt. RT-2 behandelt Bewegungen wie Wörter und sagt den nächsten Bewegungsbaustein vorher, ganz ähnlich wie ein Chatbot das nächste Wort.
Wie lernt ein VLA das Handeln?
Überwiegend durch Nachahmung: Ein Mensch führt den Roboter per Fernsteuerung (Teleoperation) durch eine Aufgabe, das Modell ahmt die Vorführungen nach. OpenVLA etwa wurde auf 970.000 solcher Vorführungen trainiert. Dazu kommt Training in Simulation.
Warum sind Roboter-KIs schwerer zu trainieren als Chatbots?
Weil es kaum fertige Trainingsdaten gibt. Ein Chatbot lernt aus dem halben Internet, für Roboterbewegungen fehlen solche Mengen. Der größte offene Datensatz umfasst nur rund 1 Mio. Abläufe, und jede Bewegung muss teuer und langsam physisch erzeugt werden.
Wie zuverlässig sind VLA-Roboter heute?
Im Alltag noch begrenzt. Laut Stanford AI Index 2026 gelingen echte Aufgaben nur in rund 12 % der Fälle, also mit etwa 88 % Fehlerquote. Außerhalb geübter Situationen werden VLAs schnell unzuverlässig. Herstellerdemos zeigen den besten Fall, nicht den Alltag.
Welche VLA-Systeme sind wichtig?
Googles RT-2 und Gemini Robotics, das quelloffene OpenVLA, Physical Intelligence π0, Nvidia GR00T und Figure Helix. Jedes hat einen eigenen Schwerpunkt, manche sind offen, andere geschlossen. Details stehen im Vergleich der KI-Gehirne der Roboter.
Läuft ein VLA auf dem Roboter oder in der Cloud?
Beides ist möglich. Systeme wie Figure Helix laufen bewusst an Bord, ohne Cloud, damit die Steuerung schnell und unabhängig bleibt. Andere nutzen die Cloud fürs Denken. Der lokale Betrieb ist für Tempo und Datenschutz meist vorteilhafter.
Ist OpenVLA wirklich Open Source?
Ja, OpenVLA ist quelloffen und frei verfügbar, mit rund 7 Mrd. Parametern. Es gibt Gewichte und Code öffentlich heraus, sodass Forscher und Entwickler darauf aufbauen können. Bei anderen Modellen ist „offen“ gestaffelt und sollte im Einzelfall geprüft werden.
Quellen & Stand: Google DeepMind (RT-2, Gemini Robotics), Figure AI (Helix, Dual-System), OpenVLA-Paper (Stanford/UC Berkeley/TRI/Google DeepMind/MIT), Open X-Embodiment / RT-X, Nvidia (GR00T N1), Physical Intelligence (π0), Stanford HAI AI Index 2026 (AI Index 2026, Kapitel Technical Performance), The Robot Report / CMU (Datenengpass). Herstellerangaben (z. B. Helix-Fähigkeiten) sind keine unabhängigen Messungen und als solche gekennzeichnet. Der Forschungsstand ändert sich schnell; Datumsstand beachten. Stand: 31. Juli 2026.