News & Markt · Analyse
KI-Agenten skalieren: was sich technisch ändern muss, wenn aus der Vorführung ein Regelbetrieb wird
Kurz gesagt: Skalierung ist selten eine Frage des Modells. Sie entscheidet sich an Orchestrierung, eigener Identität, eng geschnittenen Rechten, Kontext, Abnahmeprüfung, Protokollierung, Rückfallwegen und Kostenkontrolle — an acht Dingen also, die in einer Vorführung nicht vorkommen. Eine Messung von Sierra AI und der Princeton University zeigt, warum das zählt: Führende Agenten mit Werkzeugzugriff lösen unter 50 Prozent der gestellten Aufgaben, und verlangt man acht gelungene Durchläufe derselben Aufgabe hintereinander, bleibt im Handelsszenario weniger als ein Viertel übrig.
Achtmal dieselbe Aufgabe
Ein Agent, der eine Bestellung storniert, muss das jedes Mal richtig machen. Gelingt es in sieben von acht Fällen, dann ist der achte kein Rundungsfehler, sondern ein Kunde mit einem Anspruch und eine Kollegin, die aufräumt.
Genau diese Frage stellt eine Arbeit von Sierra AI und der Princeton University. Geprüft werden Agenten mit Werkzeugzugriff in zwei nachgebauten Anwendungsfeldern, gegen simulierte Nutzer und gegen ein hinterlegtes Regelwerk. Führende Systeme lösen dort unter 50 Prozent der gestellten Aufgaben. Lässt man dieselbe Aufgabe achtmal laufen und verlangt, dass jeder einzelne Durchlauf gelingt, fällt die Quote im Handelsszenario unter 25 Prozent. Der Modellstand dieser Messung liegt bei Mitte 2024, die Nutzer waren simuliert, und zwei Anwendungsfelder sind noch keine Branche.
Der Abstand zwischen beiden Werten trennt zwei Fragen, die im Gespräch über KI meist zusammenfallen. Die erste lautet, ob ein System eine Aufgabe lösen kann. Die zweite, ob es sie verlässlich löst. Eine Vorführung beantwortet immer nur die erste.
Wie jung dieser Anspruch ist, zeigt der Ausgangspunkt. Bei 466 Fragen, die Werkzeugnutzung und Websuche verlangen, erreichten Menschen Ende 2023 rund 92 Prozent, GPT-4 mit Erweiterungen 15 Prozent. Der Wert ist überholt und taugt nur als historische Marke — er zeigt aber, wie wenige Jahre alt die Fähigkeit überhaupt ist, Werkzeuge zu bedienen.
Eine begutachtete Untersuchung der Carnegie Mellon University und der Duke University kommt mit 175 realitätsnahen Büroaufgaben auf ein ähnliches Bild: 30,3 Prozent erledigte das beste System eigenständig, und am schlechtesten schnitt es bei der Bedienung von Büro-Oberflächen und in Gesprächen mit simulierten Kolleginnen ab. Wer einen Agenten produktiv setzen will, plant deshalb nicht für den Erfolgsfall, sondern für dessen Ausbleiben.
Warum Skalierung mit Größe korreliert und nicht mit Modellzugang
Die leistungsfähigsten Modelle stehen jedem offen, der eine Kreditkarte und eine Programmierschnittstelle hat. Gemessen an dieser Gleichverteilung müsste die Nutzung ungefähr gleich verteilt sein. Sie ist es nicht.
Nach der Befragung von McKinsey vom 25. August 2026 berichten 40 Prozent der Großunternehmen mit mehr als einer Milliarde US-Dollar Umsatz, dass sie KI-Agenten skalieren; im Jahr davor waren es 27 Prozent. Bei kleineren Organisationen liegt derselbe Wert unverändert bei 22 Prozent. Das sind Selbstauskünfte, und was ein Haus unter Skalieren versteht, legt es selbst fest. Die Spreizung bleibt bemerkenswert, denn der Zuwachs eines ganzen Jahres fällt fast vollständig in der oberen Größenklasse an.
Die europäische Statistik zeichnet dieselbe Stufe. Nach Eurostat setzten 2025 rund 17 Prozent der kleinen Unternehmen KI-Technologien ein, 30,36 Prozent der mittleren und 55,03 Prozent der großen; über alle Größenklassen hinweg waren es 19,95 Prozent nach 13,48 Prozent im Vorjahr.
Wenn alle dieselben Modelle kaufen können und trotzdem nur die Großen skalieren, liegt der Unterschied nicht im Modell. Er liegt in dem, was ein Modell umgibt: Rechteverwaltung, Protokollierung, Abnahmeverfahren, Bereitschaftsdienst, jemand, der den Fehlerfall bearbeitet. Das ist teuer in der Anschaffung und billig in der Wiederholung, was große Organisationen strukturell begünstigt.
Die Hinderungsgründe, die Eurostat erhebt, passen dazu: fehlendes Fachwissen mit 70,89 Prozent, Unklarheit über Rechtsfolgen mit 52,52 Prozent, Datenschutzbedenken mit 48,83 Prozent. Kosten führt die Statistik dort nicht auf, obwohl 20 Prozent der von McKinsey Befragten angeben, dass laufende Betriebskosten einschließlich der verarbeiteten Token ihren Einsatz begrenzt haben. Der Widerspruch löst sich über die befragten Gruppen auf, denn wer noch nicht angefangen hat, kennt die Betriebskosten nicht.
Sieben Schichten, die ein Agent im Betrieb braucht
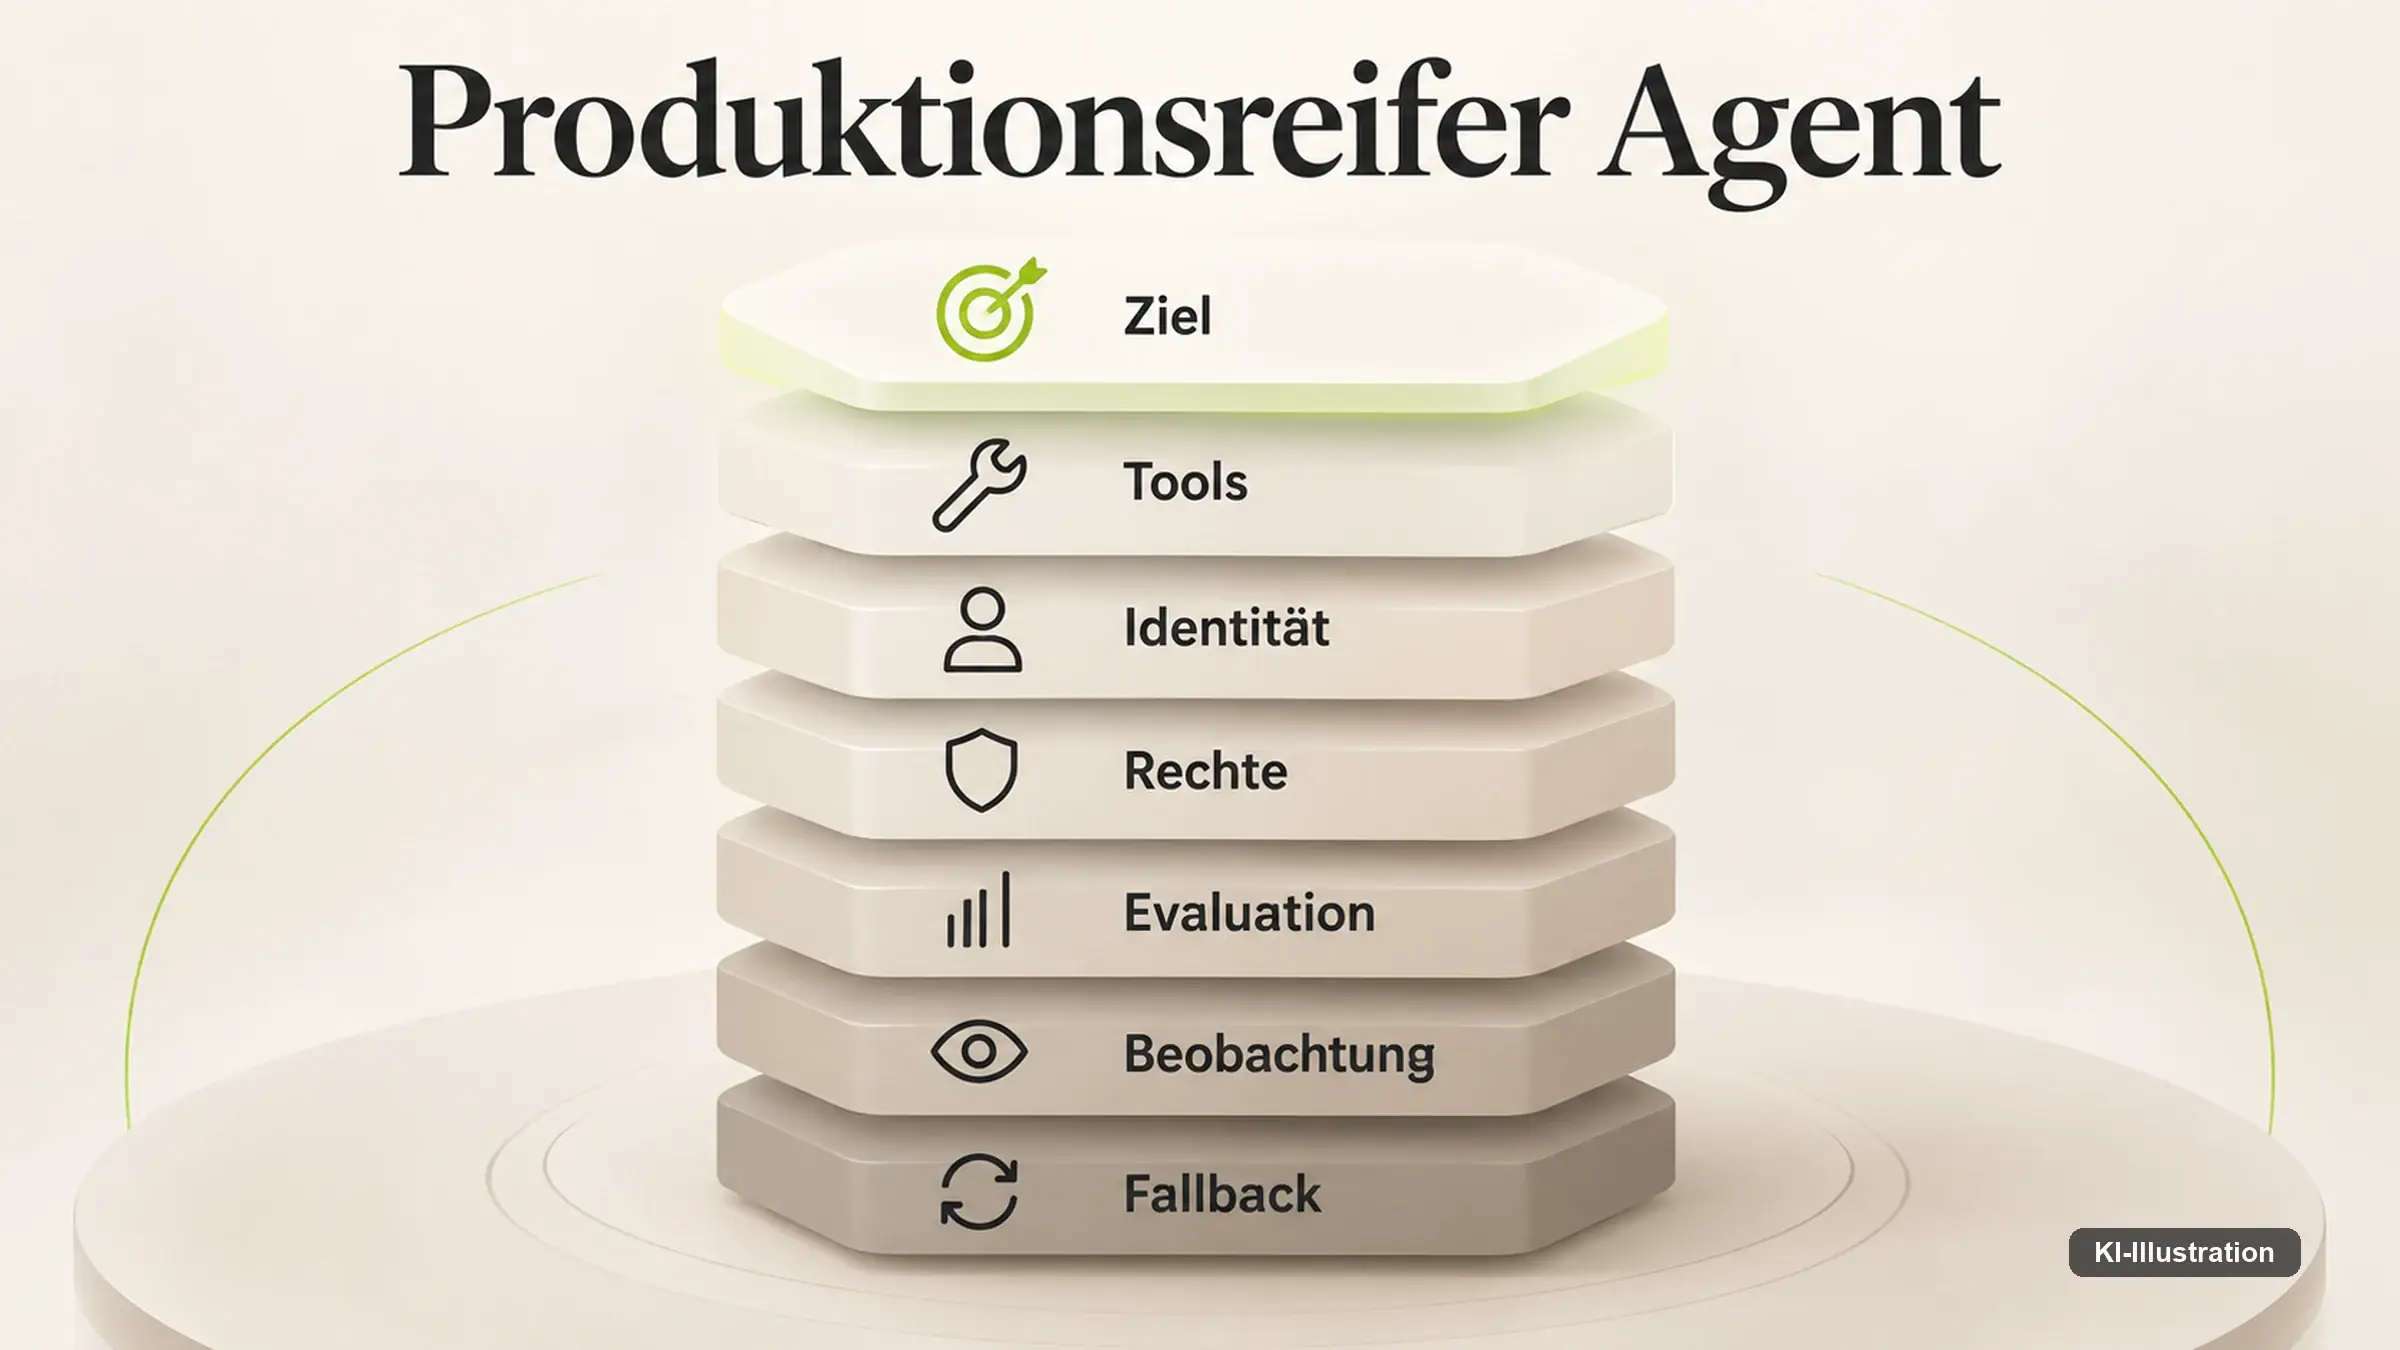
Was aus einem funktionierenden Prototyp einen betreibbaren Agenten macht, lässt sich als Abfolge von Schichten beschreiben. Die folgende Einteilung ist unsere eigene und kein Branchenmodell; sie ordnet Anforderungen, die in den zitierten Arbeiten und Empfehlungen einzeln vorkommen.
Die erste Schicht ist das Ziel. Ein Agent braucht eine Aufgabe mit einem prüfbaren Abschlusskriterium, sonst ist gar nicht entscheidbar, ob ein Durchlauf gelungen ist. „Rückerstattung klären“ ist kein solches Kriterium, „Betrag erstattet, Vorgang geschlossen, Kunde benachrichtigt“ schon.
Die zweite Schicht sind die Werkzeuge. Ohne Zugriff auf Datenbanken und Fachanwendungen bleibt jeder Agent ein Textgenerator, mit zu weit geschnittenem Zugriff wird er zum Risiko. Die dritte Schicht ist die Identität: Handelt der Agent unter dem Konto eines Menschen, ist im Nachhinein nicht mehr trennbar, wer was getan hat.
Die vierte Schicht sind die Rechte, und für sie gibt es als einzige eine ausdrückliche behördliche Empfehlung. Das Bundesamt für Sicherheit in der Informationstechnik nennt auf seiner Themenseite zu KI-Agenten minimale Berechtigungen, eine Bestätigungspflicht für wichtige Aktionen und die Prüfung der Protokolle. Die Seite weist keinen Stand aus; die Empfehlungen selbst sind gleichwohl konkret.
Die fünfte Schicht ist die Prüfung vor der Freischaltung, die sechste die Beobachtung im laufenden Betrieb, die siebte der Rückfallweg. Diese drei bilden zusammen die Frage, die über Skalierung entscheidet: Was passiert, wenn das System falsch liegt, und wer merkt es wann? Ein Agent ohne Rückfallweg ist kein schnellerer Mitarbeiter, sondern ein Vorgang ohne Ende.
Drei Bauformen und der Preis der Koordination
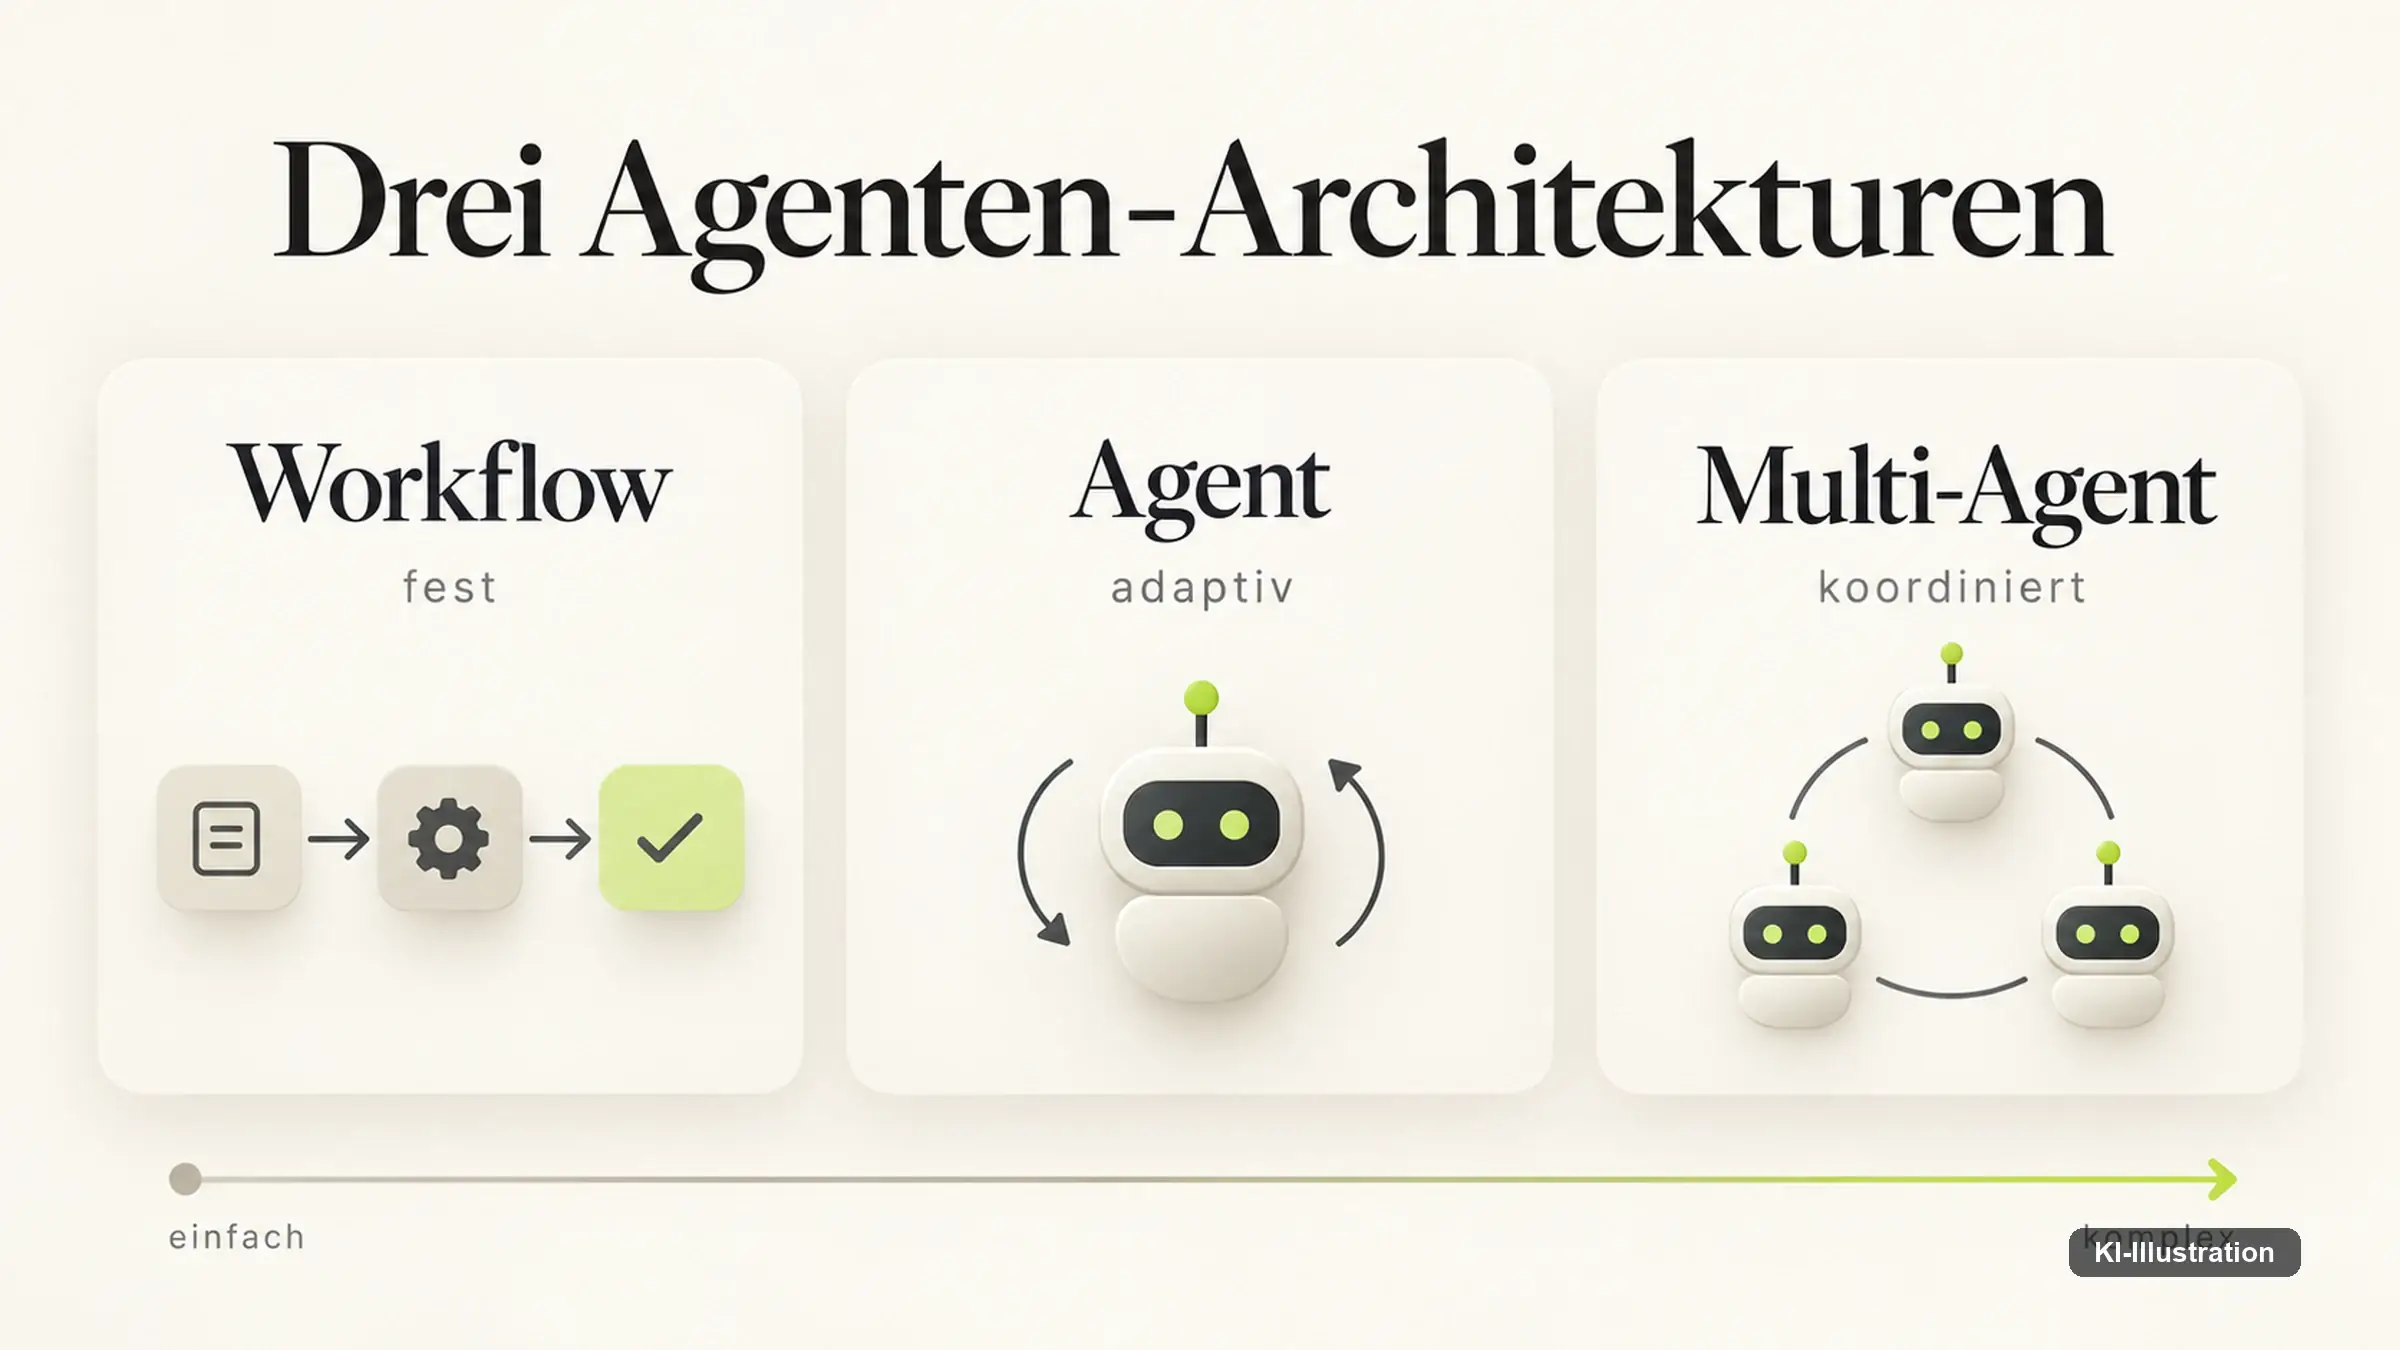
Zwischen einem festen Ablauf und einem Verbund selbständiger Agenten liegen Größenordnungen an Komplexität, und die Begriffe werden im Markt häufig vermischt.
Die einfachste Form ist der feste Arbeitsablauf: Ein Modell übernimmt einzelne Schritte, die Reihenfolge steht fest, Verzweigungen sind programmiert. Diese Bauform ist langweilig und in der Abnahme unschlagbar, weil sich jeder Pfad einzeln prüfen lässt.
Die zweite Form ist der adaptive Agent. Er entscheidet selbst, welches Werkzeug er als nächstes aufruft, und wiederholt diesen Zyklus, bis das Abschlusskriterium erfüllt ist. In der Untersuchung mit 175 Büroaufgaben brauchte das beste System dafür im Mittel 27,2 Schritte je Versuch. Jeder Schritt ist eine Gelegenheit, vom Weg abzukommen, und die Fehler multiplizieren sich über die Kette, statt sich auszugleichen.
Die dritte Form ist das koordinierte Mehr-Agenten-System, in dem spezialisierte Agenten Aufgaben untereinander weiterreichen. Genau diese Bauform hat eine Gruppe des Sky Computing Lab der UC Berkeley auseinandergenommen: Aus über 1.600 annotierten Ausführungsspuren über sieben verbreitete Rahmenwerke leiten die Autoren 14 Fehlermodi in drei Kategorien ab, bei einer Annotatorenübereinstimmung von Kappa 0,88.
Diese Arbeit ist eine Fehlertaxonomie und keine Messung von Fehlerraten — sie sagt, was schiefgeht, nicht wie oft. Als Ordnung ist sie trotzdem nützlich, weil ein erheblicher Teil der Fehler zwischen den Agenten entsteht und nicht in ihnen. Wer verteilt baut, kauft sich also eine Fehlerklasse hinzu, die es im festen Ablauf nicht gibt; das BSI benennt dieselbe Gefahr als Kettenreaktion bei vernetzten Agenten.
Daraus folgt keine Empfehlung gegen Mehr-Agenten-Systeme, wohl aber eine Reihenfolge. Prüfen Sie zuerst, ob ein fester Ablauf die Aufgabe abdeckt, denn er ist billiger zu betreiben und leichter abzunehmen. Die adaptive Form lohnt, wo die Schrittfolge im Voraus unbekannt ist, die verteilte, wenn Zuständigkeiten fachlich getrennt sind — nicht, weil sie moderner klingt.
Rechte vor Prompt
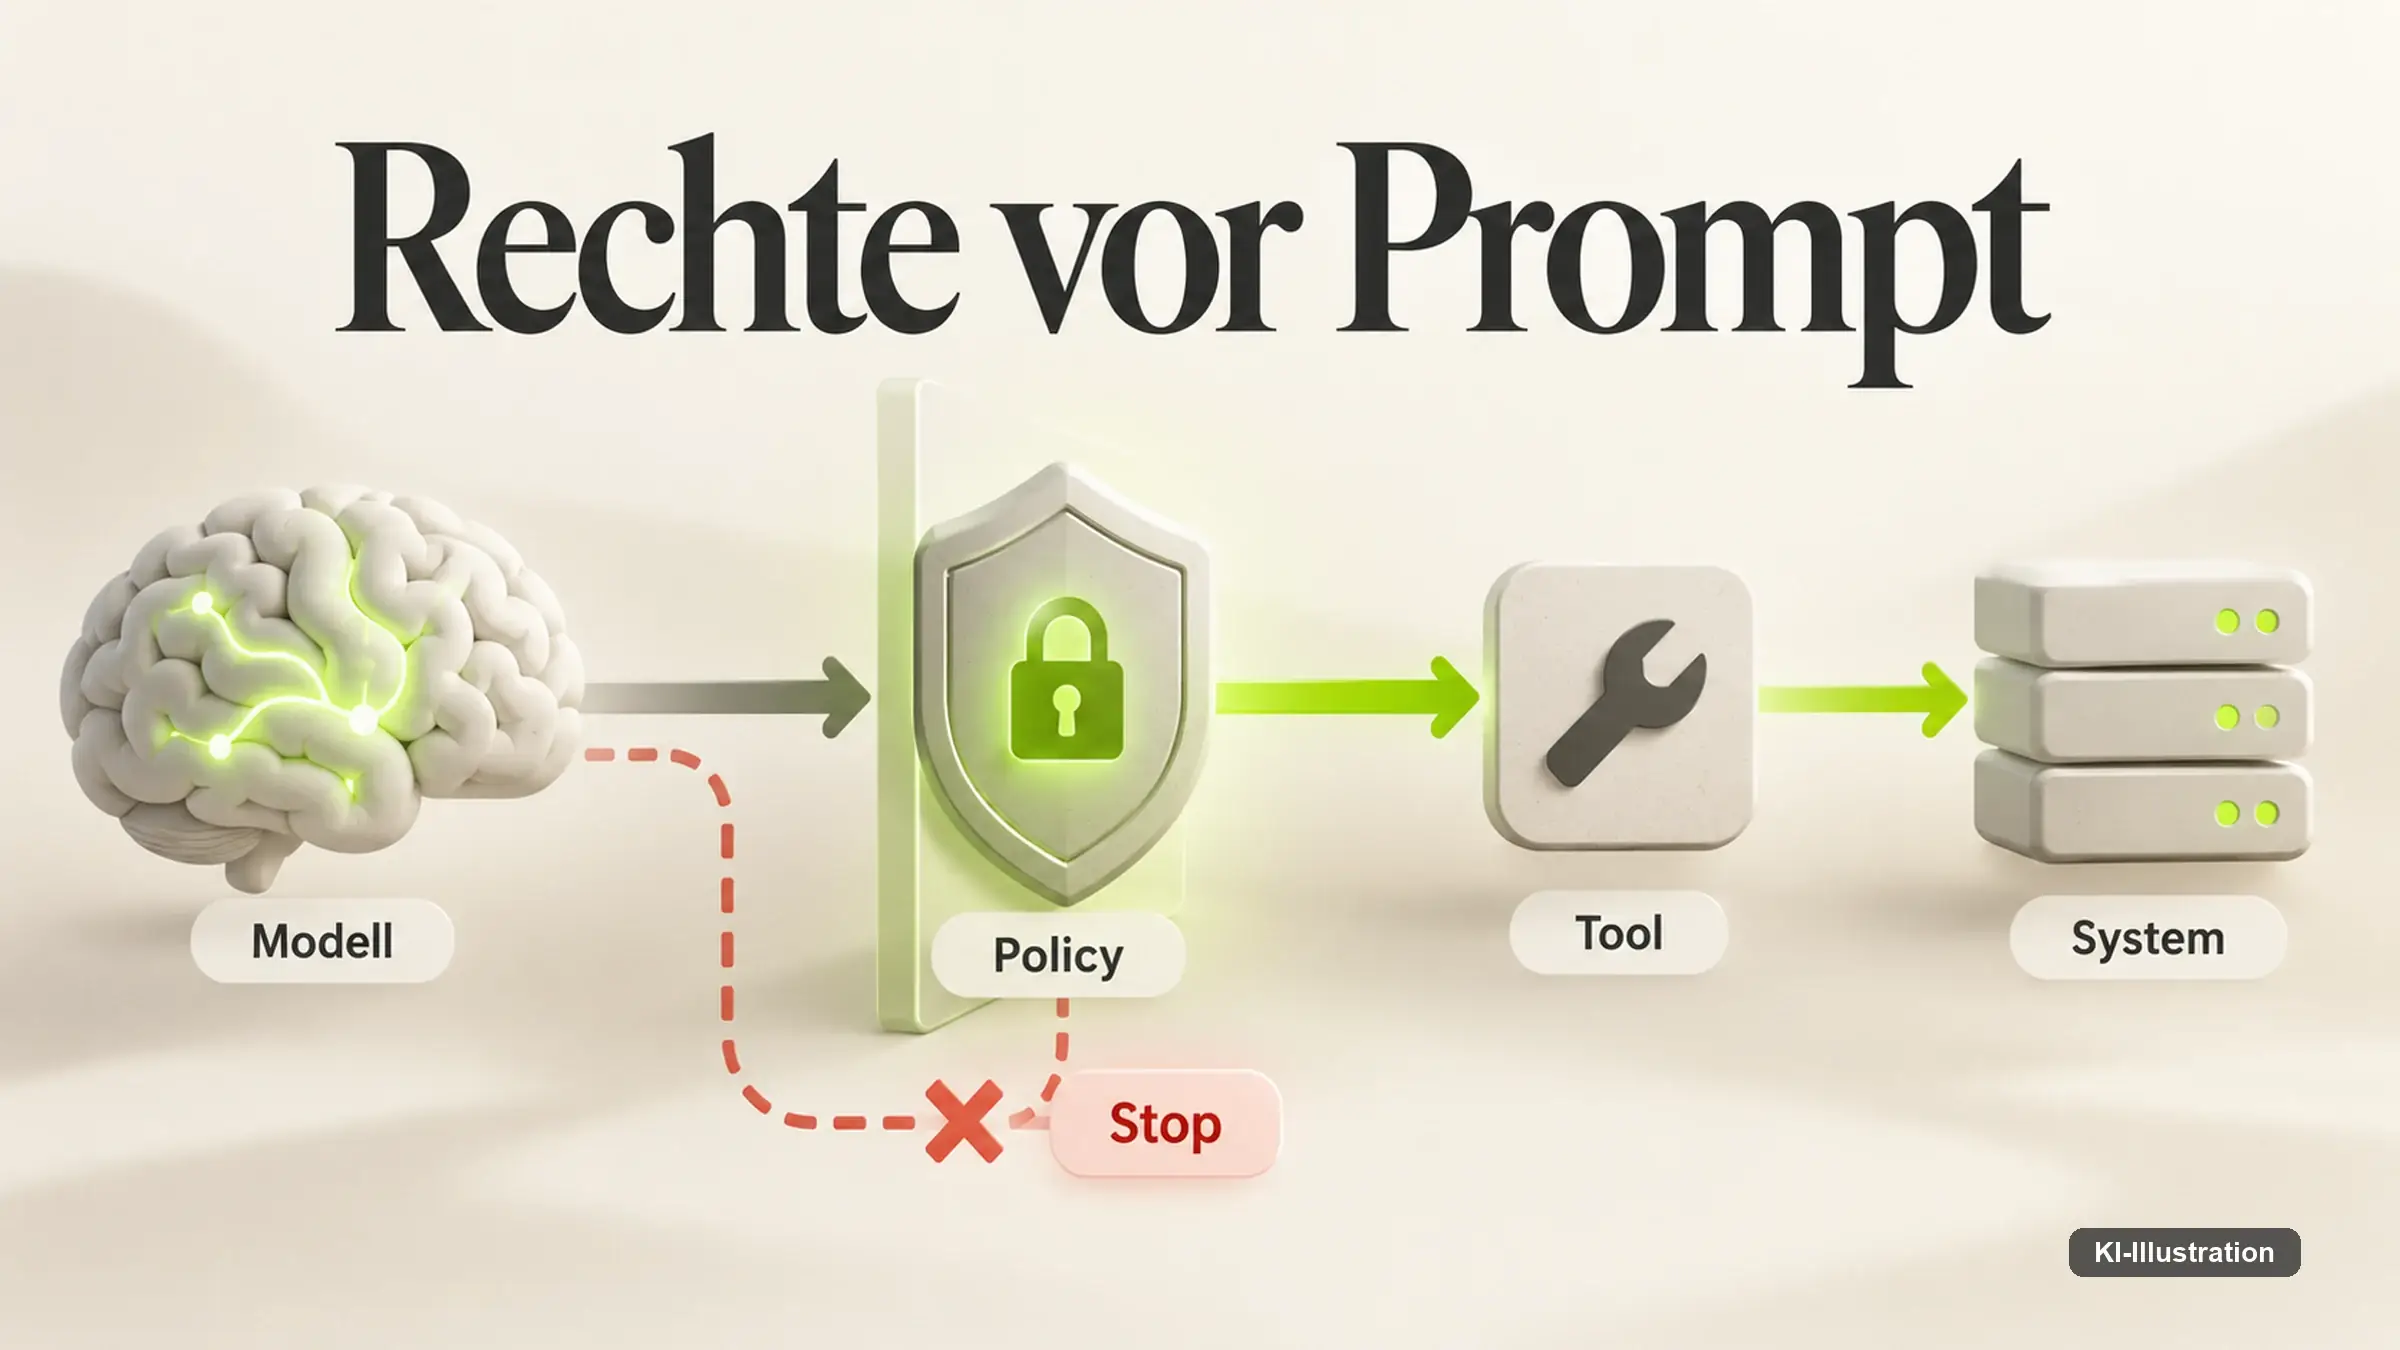
In vielen Projekten wird zuerst die Aufgabenbeschreibung für das Modell geschrieben und danach geklärt, worauf der Agent zugreifen darf. Diese Reihenfolge ist verkehrt herum, und das lässt sich technisch begründen.
Eine Aufgabenbeschreibung ist Text, und Text lässt sich überschreiben. Das BSI benennt Prompt Injection über Webseiten und E-Mails ausdrücklich als Angriffsweg: Ein Agent, der eine fremde Seite liest oder eine eingehende Nachricht verarbeitet, nimmt Inhalte auf, die er von seinen eigenen Anweisungen nicht unterscheiden kann. Die Anweisung des Betreibers und die des Angreifers erreichen dasselbe Modell über denselben Kanal.
Was trägt, sind Rechte, die außerhalb des Modells durchgesetzt werden. Ein Agent ohne Zahlungsfreigabe löst auch dann keine aus, wenn ihn jemand erfolgreich dazu überredet. Daraus folgt eine Reihenfolge der Kontrollpunkte: Das Modell schlägt eine Handlung vor, eine Regelprüfung entscheidet über ihre Zulässigkeit, erst dann wird ein Werkzeug aufgerufen, und erst danach ändert sich etwas im Fachsystem. An jeder dieser Stellen muss ein Abbruch möglich sein. An dieser Stelle greift eine Rechnung, die wir an anderer Stelle aufgemacht haben: warum Einzelfreigaben rechnerisch nicht skalieren.
Dazu kommt die Identität. Solange Agenten unter Sammelkonten laufen, ist die vom BSI empfohlene Protokollprüfung wenig wert, weil sich Handlungen keinem Akteur zuordnen lassen. Nach einem Bericht von connect vom 3. März 2026 hat die Deutsche Telekom angekündigt, ihr Produktportfolio schrittweise auf Agenten auszurichten und KI-Instanzen dabei als eigenständige Akteure mit digitalen Identitäten zu behandeln — eine Ankündigung, kein Betriebsnachweis.
Für die Frage, welche Handlungen ein Agent allein ausführen darf, gibt es kein allgemeines Maß, aber ein brauchbares Kriterium. Das BSI empfiehlt eine Bestätigungspflicht für wichtige Aktionen, und wichtig ist in der Praxis alles, was sich nicht ohne Weiteres zurücknehmen lässt. Eine versandte E-Mail, eine ausgelöste Zahlung und ein gelöschter Datensatz gehören dazu, eine Recherche im Archiv nicht.
Wenn eine erfundene Angabe nicht ausgegeben, sondern ausgeführt wird
Die Datenschicht verdient eine eigene Betrachtung. Ein Punkt gehört jedoch hierher, weil er den Unterschied zwischen einem Assistenten und einem Agenten ausmacht.
Das US-amerikanische National Institute of Standards and Technology führt in seinem Profil für generative KI zwölf Risiken auf, die für diese Technik neu oder verschärft sind; an zweiter Stelle steht die Konfabulation, also die überzeugend formulierte falsche Angabe. Dieselbe Veröffentlichung nennt in Maßnahme MS-2.3-001 das Heranziehen abgerufener Dokumente als etwas, das gegen Informationssicherheit und gegen Konfabulation zu bewerten ist. Die Datenschicht steht dort also zugleich als Gegenmittel und als eigene Risikoquelle.
Bei einem Chat-Assistenten endet eine erfundene Angabe auf dem Bildschirm, wo ein Mensch sie prüfen kann. Bei einem Agenten mit Werkzeugzugriff wird sie zum Parameter eines Aufrufs. Eine erfundene Kundennummer führt dann nicht zu einer falschen Antwort, sondern zu einer Buchung auf einem fremden Konto.
Dass die Branche selbst noch sortiert, lässt sich am Programm der HumanX Europe 2026 ablesen: Ein Roundtable am 24. September von 13:15 bis 14:00 Uhr trägt den Titel „WTF is the context layer?“, unter Beteiligung von Prukalpa Sankar. Eine Frage in dieser Form stellt man nicht, wenn die Sache geklärt ist.
Was eine Abnahme leisten muss
Benchmarks sind für die Einordnung eines Marktes unverzichtbar. Für die Abnahme eines Systems im eigenen Haus taugen sie nicht, denn sie messen andere Aufgaben an anderen Daten mit anderen Erfolgskriterien.
Übertragbar ist die Methode. Aus der Arbeit von Sierra AI und Princeton lässt sich das Verfahren übernehmen, dieselbe Aufgabe mehrfach zu wiederholen und nur durchgängige Erfolge zu zählen. Wer diesen Maßstab an eigene Prüffälle anlegt — samt der Sonderfälle, nicht nur des Normalverlaufs —, bekommt eine planbare Zahl, und meist eine unbequemere, als der erste Durchlauf vermuten ließ.
Im laufenden Betrieb verschiebt sich die Frage von der Erfolgsquote zur Sichtbarkeit. Ein Agent, der 27 Schritte hintereinander ausführt, ist aus seinem Ergebnis heraus nicht mehr zu beurteilen; nachvollziehbar wird er nur über die Spur, die er hinterlässt. Damit die vom BSI empfohlene Protokollprüfung etwas hergibt, muss daraus hervorgehen, was den Lauf ausgelöst hat, welche Quellen herangezogen wurden, welche Werkzeuge mit welchen Parametern aufgerufen wurden und an welchen Punkten eine Entscheidung fiel.
Der dritte Teil ist der Rückfallweg, und er ist der am häufigsten vergessene. Ein Agent muss abbrechen können, ohne einen halb bearbeiteten Vorgang zu hinterlassen. Begonnene Schritte müssen sich zurücknehmen lassen, und der Fall muss an eine benannte Zuständigkeit gehen, mit einer Frist. Sonst entsteht die teuerste aller Fehlerarten: der Vorgang, den niemand als offen erkennt.
Vorführung und Betrieb: acht Prüffelder
Die Anforderungen aus den vorangegangenen Abschnitten lassen sich zu einem Raster zusammenziehen, das sich an jedes angebotene System anlegen lässt. Es unterscheidet nicht zwischen Anbietern, sondern zwischen zwei Betriebszuständen.
| Prüffeld | Was die Vorführung zeigt | Was der Betrieb verlangt |
|---|---|---|
| Aufgabe | ein ausgewählter, gut umrissener Fall | den vollen Fallbestand mit Sonderfällen, Altlasten und Abbrüchen |
| Autonomiegrad | durchgehend selbständiger Ablauf | festgelegte Grenze zwischen dem, was der Agent allein entscheidet, und dem, was er vorlegt |
| Werkzeugzugriff | alle benötigten Werkzeuge offen verfügbar | engster nötiger Satz an Werkzeugen, je Aufgabe getrennt vergeben |
| Identität und Rechte | ein geteiltes Konto mit weiten Rechten | eigene technische Identität je Agent, Rechte einzeln vergeben und einzeln entziehbar |
| Prüfung vor Betrieb | ein gelungener Durchlauf, oft ein Benchmark-Wert | Wiederholungsläufe an eigenen Fällen, bei denen nur durchgängige Erfolge zählen |
| Protokollierung | das Ergebnis | vollständige Spur: Auslöser, Quellen, Werkzeugaufrufe mit Parametern, Entscheidungspunkte |
| Fehlerbehandlung | nicht vorgesehen | definierter Abbruch, Rücknahme begonnener Schritte, benannte Zuständigkeit mit Frist |
| Wirtschaftlichkeit | Preis je Modellabfrage | Kosten je erledigtem Vorgang, mit Fehlversuchen, Aufsicht und Nacharbeit |
Keine Zeile dieses Rasters verlangt ein besseres Modell. Alle acht verlangen Arbeit an der Umgebung, in der ein Modell läuft — und deshalb schlägt ein Anbieter mit belastbaren Angaben zur rechten Spalte einen mit der eindrucksvolleren Vorführung.
Woran die Anschlussfähigkeit hängt
Wer Agenten über mehrere Fachsysteme hinweg betreibt, bindet sich an Schnittstellen. Wie stabil diese Bindung ist, wird selten gefragt und entscheidet über die Wechselkosten der kommenden Jahre.
Am weitesten verbreitet ist derzeit das Model Context Protocol, über das Modelle Werkzeuge und Datenquellen ansprechen. Seit der Übertragung an LF Projects, LLC ist es nicht mehr an einen einzelnen Hersteller gebunden, steht unter der Apache-Lizenz 2.0, und die Mitgliedschaft in seinen Gremien hängt an Personen statt an Unternehmen.
Ein Normungsverfahren ist es dennoch nicht. Das Leitungsmodell sieht zwei Lead Maintainers als letzte Instanz vor, womit genau das Konsensverfahren fehlt, das eine Norm nach dem Muster von ISO oder W3C ausmacht. Die Schnittstelle ist offen einsehbar und frei verwendbar, ihre Weiterentwicklung liegt aber bei wenigen Personen.
Beim W3C gibt es seit dem 8. Mai 2025 eine Community Group zu Agentenprotokollen, die fünf Arbeitsfelder benennt, darunter standardisierte Metadatenformate. Eine Community Group ist allerdings kein Standardisierungsgremium, ihre Ergebnisse binden niemanden, und ein Termin für die Überführung in ein formales Verfahren ist damit nicht gesetzt.
Parallel entsteht eine Sicherheitssicht auf dieselbe Architektur: Die OWASP-Initiative führt seit 2026 eine eigene Zusammenstellung der zehn wichtigsten Schwachstellen agentischer Anwendungen. Dass eine solche Liste getrennt geführt wird, ist selbst ein Hinweis auf den Reifegrad, denn Sicherheitskataloge entstehen dort, wo genug gleichartige Fehler beobachtet wurden.
Was daraus für die nächsten Monate folgt
Die nüchternste Einschätzung stammt von einer Behörde. Das BSI stuft KI-Agenten technologisch als noch in einem frühen Stadium ein und benennt den Kontrollverlust durch Autonomie als eigenes Risiko. Die Seite trägt keine Datumsangabe, was ihre Aktualität offenlässt; im Ton unterscheidet sie sich deutlich von der Produktkommunikation vieler Anbieter.
Auf der Marktseite steht eine Prognose von Gartner vom 25. Juni 2025 daneben: Mehr als 40 Prozent der agentischen KI-Projekte würden bis Ende 2027 abgebrochen, wegen steigender Kosten, unklaren Geschäftswerts oder unzureichender Risikokontrolle. Dasselbe Haus schätzt, dass von mehreren Tausend Anbietern mit agentischem Anspruch nur rund 130 tatsächlich agentische Fähigkeiten liefern. Das ist eine Prognose, keine Messung, und ihr Horizont liegt noch vor uns.
Wie sehr die Frage die Branche beschäftigt, zeigt das Programm der HumanX Europe 2026, die vom 22. bis 24. September im RAI Amsterdam läuft. Am 24. September von 13:15 bis 14:00 Uhr ist ein Roundtable mit dem Titel „Beyond the Pilot: What It Really Takes to Scale Agentic AI“ angesetzt, mit 19 Plätzen, moderiert von Luca Dell’Orletta, Global Head of Tech Innovation und Enterprise Architecture bei Nestlé. Zeitgleich fragt ein Programmpunkt von 13:35 bis 13:55 Uhr unter dem Titel „Past the Demo: Deploying AI Agents at Enterprise Scale“ nach demselben Übergang; angekündigt sind Ashwin Sreenivas von Decagon, Kartik Sheth von der Deutschen Telekom und Hugh Langley von Business Insider.
Hinzu kommen ein Vortrag „From Models to Agents at Scale“ von 10:25 bis 10:45 Uhr mit Swami Sivasubramanian von Amazon Web Services und ein Programmpunkt „Rewriting the Operating Model for the AI Era“ am 24. September von 13:55 bis 14:15 Uhr. Vier Titel, die denselben Übergang benennen, sind ein Indiz dafür, dass er noch nicht gelöst ist.
Für die eigene Planung heißt das weniger, als es klingt, und zugleich mehr. Weniger, weil keine Prognose beantwortet, ob ein bestimmter Agent in einem bestimmten Haus trägt. Mehr, weil die Prüffelder feststehen und sich abarbeiten lassen, bevor ein Euro in Lizenzen fließt: eine Aufgabe mit prüfbarem Abschluss, eine eigene Identität, eng geschnittene Rechte, Wiederholungsläufe an eigenen Fällen, eine auswertbare Spur und ein Rückfallweg mit Zuständigkeit.
Quellen. Alle Adressen wurden am 13. September 2026 geprüft. Wo eine Seite automatisierte Abrufe abweist, wurde sie im Browser geöffnet und der Inhalt gegen die Nennung abgeglichen.
- Yao et al., τ-bench: A Benchmark for Tool-Agent-User Interaction in Real-World Domains, Sierra AI und Princeton University.
- Cemri et al., Why Do Multi-Agent LLM Systems Fail?, Sky Computing Lab, UC Berkeley; Fehlertaxonomie aus über 1.600 Ausführungsspuren.
- Mialon et al., GAIA: A Benchmark for General AI Assistants, Meta AI und Hugging Face; Stand Ende 2023.
- Xu et al., TheAgentCompany, Carnegie Mellon University und Duke University, NeurIPS 2025.
- NIST, AI 600-1: Generative Artificial Intelligence Profile, Juli 2024; freiwilliges Rahmenwerk ohne Rechtsverbindlichkeit.
- Bundesamt für Sicherheit in der Informationstechnik, KI-Agenten; ohne ausgewiesenen Stand.
- OWASP, Top 10 for Agentic Applications 2026.
- Model Context Protocol, Governance; W3C, AI Agent Protocol Community Group.
- McKinsey & Company, The state of AI in 2026, 25. August 2026; Befragung.
- Gartner, Over 40% of Agentic AI Projects Will Be Canceled by End of 2027, 25. Juni 2025; Prognose.
- Eurostat, Use of artificial intelligence in enterprises, Datenstand Dezember 2025.
- connect, Deutsche Telekom: KI-Agenten im Unternehmen, 3. März 2026; Unternehmensankündigung.
- HumanX Europe 2026, Agenda sowie „Beyond the Pilot“ und „Past the Demo“.
Die Angaben zur Rechtslage sind eine redaktionelle Einordnung und keine Rechtsberatung.
Warum zählt Wiederholbarkeit mehr als eine hohe Erfolgsquote im Einzelfall?
Weil ein Betrieb denselben Vorgang tausendfach ausführt. In der Untersuchung von Sierra AI und der Princeton University lösen führende Agenten unter 50 Prozent der Aufgaben, und bei acht Wiederholungen derselben Aufgabe bleiben im Handelsszenario weniger als 25 Prozent durchgängige Erfolge übrig. Eine Quote über Einzelversuche verdeckt also, wie stark ein Ergebnis schwankt. Die Werte stammen aus zwei nachgebauten Anwendungsfeldern mit simulierten Nutzern, Modellstand Mitte 2024.
Ist ein Mehr-Agenten-System zuverlässiger als ein einzelner Agent?
Dafür gibt es keinen Beleg, wohl aber einen Hinweis auf zusätzliche Fehlerquellen. Eine Arbeit des Sky Computing Lab der UC Berkeley leitet aus über 1.600 annotierten Ausführungsspuren über sieben Rahmenwerke 14 Fehlermodi in drei Kategorien ab; ein erheblicher Teil davon entsteht zwischen den Agenten und nicht in ihnen. Es handelt sich um eine Fehlertaxonomie, nicht um eine Messung von Fehlerraten.
Warum ist Prompt Injection bei einem Agenten gefährlicher als bei einem Chatbot?
Weil der Agent handeln kann. Das BSI benennt Prompt Injection über Webseiten und E-Mails als Angriffsweg: Eingelesene Inhalte erreichen das Modell über denselben Kanal wie die Anweisungen des Betreibers und lassen sich davon nicht sicher unterscheiden. Bei einem Chatbot endet das Ergebnis auf dem Bildschirm, bei einem Agenten wird es zum Parameter eines Werkzeugaufrufs. Schutz bietet deshalb nur eine Rechteprüfung außerhalb des Modells.
Welche Handlungen sollte ein Agent nicht allein ausführen dürfen?
Das BSI empfiehlt eine Bestätigungspflicht für wichtige Aktionen, ohne sie im Einzelnen aufzuzählen. Als praktisches Kriterium eignet sich die Umkehrbarkeit: Was sich nicht ohne Weiteres zurücknehmen lässt, gehört vor der Ausführung einem Menschen vorgelegt. Eine versandte Nachricht, eine ausgelöste Zahlung und ein gelöschter Datensatz fallen darunter, eine Recherche im Archiv nicht. Diese Zuordnung ist eine redaktionelle Ableitung, keine Vorgabe der Behörde.
Reicht ein gutes Benchmark-Ergebnis als Abnahme vor dem Produktivbetrieb?
Nein, denn ein Benchmark misst andere Aufgaben an anderen Daten mit anderen Erfolgskriterien. Übertragbar ist die Methode, nicht der Wert: eigene Prüffälle einschließlich der Sonderfälle, mehrfache Wiederholung desselben Falls und eine Zählung, bei der nur durchgängige Erfolge gelten. Das Ergebnis fällt regelmäßig niedriger aus, als der erste gelungene Durchlauf vermuten lässt.
Ist das Model Context Protocol ein offener Standard?
Offen ja, Standard im Sinne eines Normungsverfahrens nein. Seit der Übertragung an LF Projects, LLC ist das Protokoll nicht mehr herstellergebunden, steht unter der Apache-Lizenz 2.0, und die Gremienmitgliedschaft hängt an Personen statt an Unternehmen. Das Leitungsmodell sieht jedoch zwei Lead Maintainers als letzte Instanz vor, womit das Konsensverfahren fehlt, das eine Norm nach dem Muster von ISO oder W3C ausmacht.
Sind die Empfehlungen von NIST und BSI rechtlich verbindlich?
Nein. Das Profil AI 600-1 des NIST vom Juli 2024 ist ein freiwilliges Rahmenwerk ohne Rechtsverbindlichkeit und enthält keine Messwerte, sondern zwölf benannte Risiken und zugehörige Maßnahmen. Die Themenseite des BSI zu KI-Agenten ist eine Empfehlung und weist keinen Stand aus. Beide taugen als Prüfraster für die eigene Architektur, ersetzen aber keine rechtliche Prüfung des konkreten Einsatzes.
Woran erkennt man einen Anbieter, der nur agentisch draufschreibt?
Gartner schätzt, dass von mehreren Tausend Anbietern mit agentischem Anspruch nur rund 130 tatsächlich agentische Fähigkeiten liefern, und erwartet, dass über 40 Prozent der agentischen Projekte bis Ende 2027 abgebrochen werden. Beides ist die Prognose eines kommerziellen Analystenhauses, keine Messung. Aussagekräftiger als jedes Etikett ist die Frage, ob ein Anbieter Angaben zu Rechteverwaltung, Protokollierung, Fehlerbehandlung und Kosten je erledigtem Vorgang machen kann.