News & Markt · Analyse
Context Layer für KI-Agenten: Warum zusätzlicher Kontext Systeme vor allem zuversichtlicher macht
Kurz gesagt: Eine Kontextschicht entscheidet, welche Information ein KI-Agent im Moment der Anfrage sieht — und sie verändert dabei mehr als das Wissen des Systems. In einer begutachteten Untersuchung fiel die Enthaltungsquote eines Modells mit beigegebenem Kontext von 100 auf 18,6 Prozent, bei einem anderen von 84,1 auf 52 Prozent, obwohl der Kontext in 55,4 Prozent der geprüften Instanzen zur Beantwortung gar nicht ausreichte. Wer diese Schicht einzieht, verschiebt also das Risikoverhalten seines Systems. Und er baut eine zweite Angriffsfläche: Das Bundesamt für Sicherheit in der Informationstechnik führt dieselbe Technik als Gegenmaßnahme und als eigenes Risiko.
Das Modell, das aufhörte zu schweigen
In einem Versuchsaufbau bekam ein Sprachmodell Fragen gestellt, die es aus eigenem Wissen nicht beantworten konnte. Es enthielt sich in 100 Prozent der Fälle. Dann legten die Forschenden Dokumente bei — und die Enthaltung fiel auf 18,6 Prozent.
Auf den ersten Blick ist das genau der erwünschte Effekt. Ein System mit Zugriff auf die passenden Unterlagen soll antworten können, sonst braucht man die Unterlagen nicht. Nur reichten die beigegebenen Dokumente in mehr als der Hälfte der geprüften Fälle gar nicht aus, um die jeweilige Frage zu beantworten. Das Modell antwortete also nicht nur häufiger, weil es mehr wusste, sondern auch dort, wo das Material seine Antwort nicht deckte.
Enthaltung ist im Fachbetrieb keine Schwäche. Sie ist die einzige Reaktion, die einen unklaren Fall sichtbar macht, bevor er weiterläuft. Wer eine Datenschicht vor sein Modell setzt, handelt diese Reaktion mit ein, ohne dass sie in irgendeinem Anforderungskatalog auftaucht.
Damit ist die Frage gestellt, um die es hier geht. Sie lautet nicht, wie ein Agent an mehr Information kommt — das ist inzwischen Handwerk. Sie lautet, welche Information er zum richtigen Zeitpunkt sieht, wer das festgelegt hat und ob er merkt, wenn etwas fehlt.
Auf der HumanX Europe 2026 im RAI Amsterdam ist dazu ein Roundtable angekündigt, der am 24. September von 13:15 bis 14:00 Uhr läuft und den Titel „WTF is the context layer?“ trägt. Beteiligt ist Prukalpa Sankar vom Anbieter Atlan. Dieser Beitrag entstand vor Beginn der Veranstaltung und referiert deshalb nichts von dort; ausgewertet sind das veröffentlichte Programm und Arbeiten, die von der Konferenz unabhängig sind.
Warum ein Roundtable fragt, was diese Schicht überhaupt ist
Ein Konferenzformat, das eine Definitionsfrage mit einer Abkürzung aus der Umgangssprache stellt, sagt etwas über den Klärungsstand. Man fragt nicht öffentlich, was eine Sache ist, wenn die Antwort in einer Norm steht.
Eine neutrale Beschreibung gibt es bislang nicht. Was es gibt, sind Anbietertexte: Atlan führt eine eigene Seite zum Kontextlayer für KI und eine Hilfeseite dazu für die eigenen Agenten, Anthropic veröffentlicht unter dem Stichwort Kontext-Engineering für KI-Agenten. Beide Unternehmen verkaufen Produkte in diesem Feld, und beide prägen damit die Begriffe, in denen anschließend eingekauft wird.
Für diesen Beitrag verwenden wir eine eigene Arbeitsbeschreibung, und sie ist ausdrücklich unsere und keine etablierte: Kontextschicht heißt alles, was zwischen den Datenquellen eines Hauses und dem Moment des Modellaufrufs passiert. Also die Auswahl der Quellen, die Beschreibung dessen, was sie enthalten, die Prüfung, wer das sehen darf, die Frage nach dem Stand, die Zerlegung in Abschnitte und die Aufzeichnung, worauf eine Antwort später beruhte.
Dass sich ein Begriff etabliert, bevor seine Grenzen feststehen, ist im Markt für Agentensoftware kein Einzelfall. Gartner schätzte im Juni 2025, dass von mehreren Tausend Anbietern, die sich agentisch nennen, nur rund 130 tatsächlich agentische Fähigkeiten liefern — eine Einschätzung eines kommerziellen Analystenhauses, keine Messung. Ein Etikett ohne geprüfte Bedeutung ist bequem, solange niemand nachfragt, was darunter liegt. Messen lässt sich dagegen, was passiert, wenn die Schicht fehlt oder schlecht gebaut ist.
In mehr als der Hälfte der Fälle trägt der Kontext die Antwort nicht
Die Arbeit, aus der die Zahlen vom Anfang stammen, erschien 2025 auf der ICLR-Konferenz; beteiligt waren die University of California in San Diego, die Duke University und Google Research. Untersucht wurde nicht, ob Modelle richtig antworten, sondern etwas Vorgelagertes: ob das mitgelieferte Material die gestellte Frage überhaupt beantwortbar macht.
In 55,4 Prozent der geprüften Instanzen gängiger Datensätze war das nicht der Fall. Der Kontext war vorhanden, er sah aus wie eine Grundlage, und er trug die Antwort nicht.
Diese Zahl gehört mit ihren Grenzen gelesen. Geprüft wurden Datensätze aus Frage-Antwort-Aufgaben mit je 500 Beispielen, keine Unternehmensablagen und keine Fachdokumentation. Die Einstufung, ob ein Kontext ausreicht, traf ein automatischer Bewerter mit rund 93 Prozent Genauigkeit — der Maßstab ist also selbst fehlerbehaftet.
Trotzdem ändert der Befund die Blickrichtung. Wer über Halluzinationen spricht, spricht meist über das Modell. Hier liegt der Fehler eine Stufe früher, nämlich in der Annahme, ein Treffer aus der Suche sei bereits eine Antwortgrundlage. Ähnlichkeit im Suchindex und Eignung für eine bestimmte Frage sind zwei verschiedene Dinge, und nur das erste wird beim Abruf gemessen.
Bemerkenswert ist außerdem, was das System in diesen Fällen nicht tut. Es meldet nicht, dass die Grundlage fehlt. Es liefert eine Antwort in derselben Form, im selben Ton und mit derselben Länge wie in den Fällen, in denen der Kontext trägt. Für eine Fachkraft, die zwanzig solcher Antworten am Tag verarbeitet, ist genau das die teure Eigenschaft: Die unsicheren Fälle sehen aus wie die sicheren.
Enthaltung ist eine Schutzfunktion — und sie wird mitverhandelt
Der zweite Befund derselben Arbeit ist der interessantere, weil ihn kaum jemand bestellt hat. Gemessen wurde, wie oft ein Modell die Antwort verweigert, wenn es Kontext bekommt, und wie oft ohne.
Claude 3.5 Sonnet enthielt sich ohne Kontext in 84,1 Prozent der Fälle, mit Kontext nur noch in 52 Prozent. Gemini 1.5 Pro fiel von 100 auf 18,6 Prozent. GPT-4o bewegte sich dagegen kaum, von 34,4 auf 31,2 Prozent. Alle drei Werte stammen aus denselben Frage-Antwort-Datensätzen mit je 500 Beispielen.
Diese Spreizung ist praktisch wichtiger als der Mittelwert. Zwei Modelle geben einen erheblichen Teil ihrer Zurückhaltung ab, sobald Dokumente im Spiel sind, eines fast nicht. Wer eine Kontextschicht baut und später das Modell wechselt, tauscht damit auch das Risikoverhalten aus — und zwar ohne dass eine Zeile der eigenen Architektur sich ändert.
In Zahlen heißt das: Ein Aufbau, der vorher in vier von fünf Zweifelsfällen geschwiegen hätte, schweigt danach nur noch in etwa jedem zweiten. Die übrigen Fälle wandern in die Antwortmenge, und ein Teil davon steht auf Material, das die Frage nicht beantwortet.
Niemand schreibt in ein Lastenheft, dass er weniger Enthaltung möchte. Man will bessere Antworten und bekommt beides in einem Paket, weil es technisch dieselbe Stellschraube ist. Deshalb gehört die Enthaltungsquote zu den wenigen Größen, die im Betrieb ohnehin mitlaufen sollten, denn sie ist der einzige leicht messbare Hinweis darauf, dass ein System seine eigenen Grenzen noch kennt. Belegt ist dabei die Richtung des Effekts an konstruierten Aufgaben, nicht seine Höhe in einem Haus mit gewachsener Ablage.
Mehr Kontext ist nicht mehr Wissen
Die naheliegende Gegenmaßnahme lautet: dann eben mehr Dokumente mitgeben. Sie funktioniert schlechter, als sie klingt, und das ist seit Jahren belegt.
Eine Arbeit aus Stanford und Berkeley, erschienen in der Fachzeitschrift TACL, hat die Position der entscheidenden Information im Kontext variiert. Bei Fragen, deren Antwort in einem von zwanzig beigegebenen Dokumenten stand, hing der Erfolg stark davon ab, wo dieses Dokument lag. Stand es in der Mitte, fiel GPT-3.5-Turbo unter den Wert, den dasselbe Modell ganz ohne Kontext erreichte — unter 56,1 Prozent. Zusätzliches Material machte das Ergebnis also nicht besser, sondern schlechter als gar keines.
Die zweite Arbeit stammt von NVIDIA und prüft die beanspruchte Kontextlänge nach. Von 17 Modellen, die sämtlich 32.000 Token oder mehr angeben, hielt nur etwa die Hälfte bei 32.000 Token noch ein zufriedenstellendes Niveau. Die Angabe auf dem Datenblatt beschreibt, was hineinpasst, nicht, was verarbeitet wird.
Beide Untersuchungen arbeiten mit konstruierten Aufgaben, die eine bekannte Lösung an einer bekannten Stelle verstecken; der Modellstand liegt bei 2023 beziehungsweise Mitte 2024. Wer daraus ableitet, heutige Modelle hätten das Problem hinter sich, setzt voraus, dass die Hersteller es gelöst und nicht nur verschoben haben — geprüft ist das in den hier ausgewerteten Arbeiten nicht.
Die Aufgabe der Kontextschicht ist damit umrissen, und sie ist eine andere als „möglichst viel bereitstellen“. Sie besteht in Auswahl, Reihenfolge und Menge. Was eine Suchmaschine zurückgibt, ist eine Rangliste nach Ähnlichkeit; was ein Modell braucht, ist eine knappe Zusammenstellung, deren Teile die Frage tatsächlich tragen.
Wer die vorliegenden Messungen nebeneinanderlegt, sieht schnell, wovon sie handeln und wovon nicht.
| Untersuchung | Gegenstand und Umfang | Geprüfte Systeme | Was daraus folgt — und was nicht |
|---|---|---|---|
| Sufficient Context, ICLR 2025 | Frage-Antwort-Datensätze, je 500 Beispiele; Einstufung durch einen automatischen Bewerter mit rund 93 Prozent Genauigkeit | Claude 3.5 Sonnet, Gemini 1.5 Pro, GPT-4o | Kontext reicht oft nicht aus und verschiebt das Antwortverhalten; keine Aussage über Fachdaten eines Unternehmens |
| Lost in the Middle, TACL | konstruierte Aufgaben mit 20 Dokumenten je Frage, Position der Lösung variiert | GPT-3.5-Turbo, Stand 2023 | Position im Kontextfenster wirkt auf das Ergebnis; kein Beleg für heutige Modellgenerationen |
| RULER, NVIDIA | 13 synthetische Aufgaben über 17 Modelle mit mindestens 32.000 Token Kontext | Modellstand Mitte 2024 | beanspruchte Länge ist nicht nutzbare Länge; keine Aussage über Fachdokumente |
| τ-bench, Sierra AI und Princeton | zwei Domänen, simulierte Nutzer, achtmalige Wiederholung derselben Aufgabe | Modellstand Mitte 2024 | Wiederholbarkeit ist ein eigenes Problem; die Ursache benennt die Arbeit nicht |
| MAST, UC Berkeley | über 1.600 annotierte Ausführungsspuren aus sieben Rahmenwerken, Übereinstimmung der Annotierenden bei Kappa 0,88 | Mehr-Agenten-Aufbauten | eine Ordnung von 14 Fehlermodi; ausdrücklich keine Fehlerraten |
| NIST AI 600-1 und BSI | Risiko- und Maßnahmenlisten, qualitativ | keine Messung | Einordnung und Empfehlung; keine Eintrittswahrscheinlichkeiten und keine Wirkungsnachweise |
Sechs Bestandteile und woran ihr Fehlen auffällt
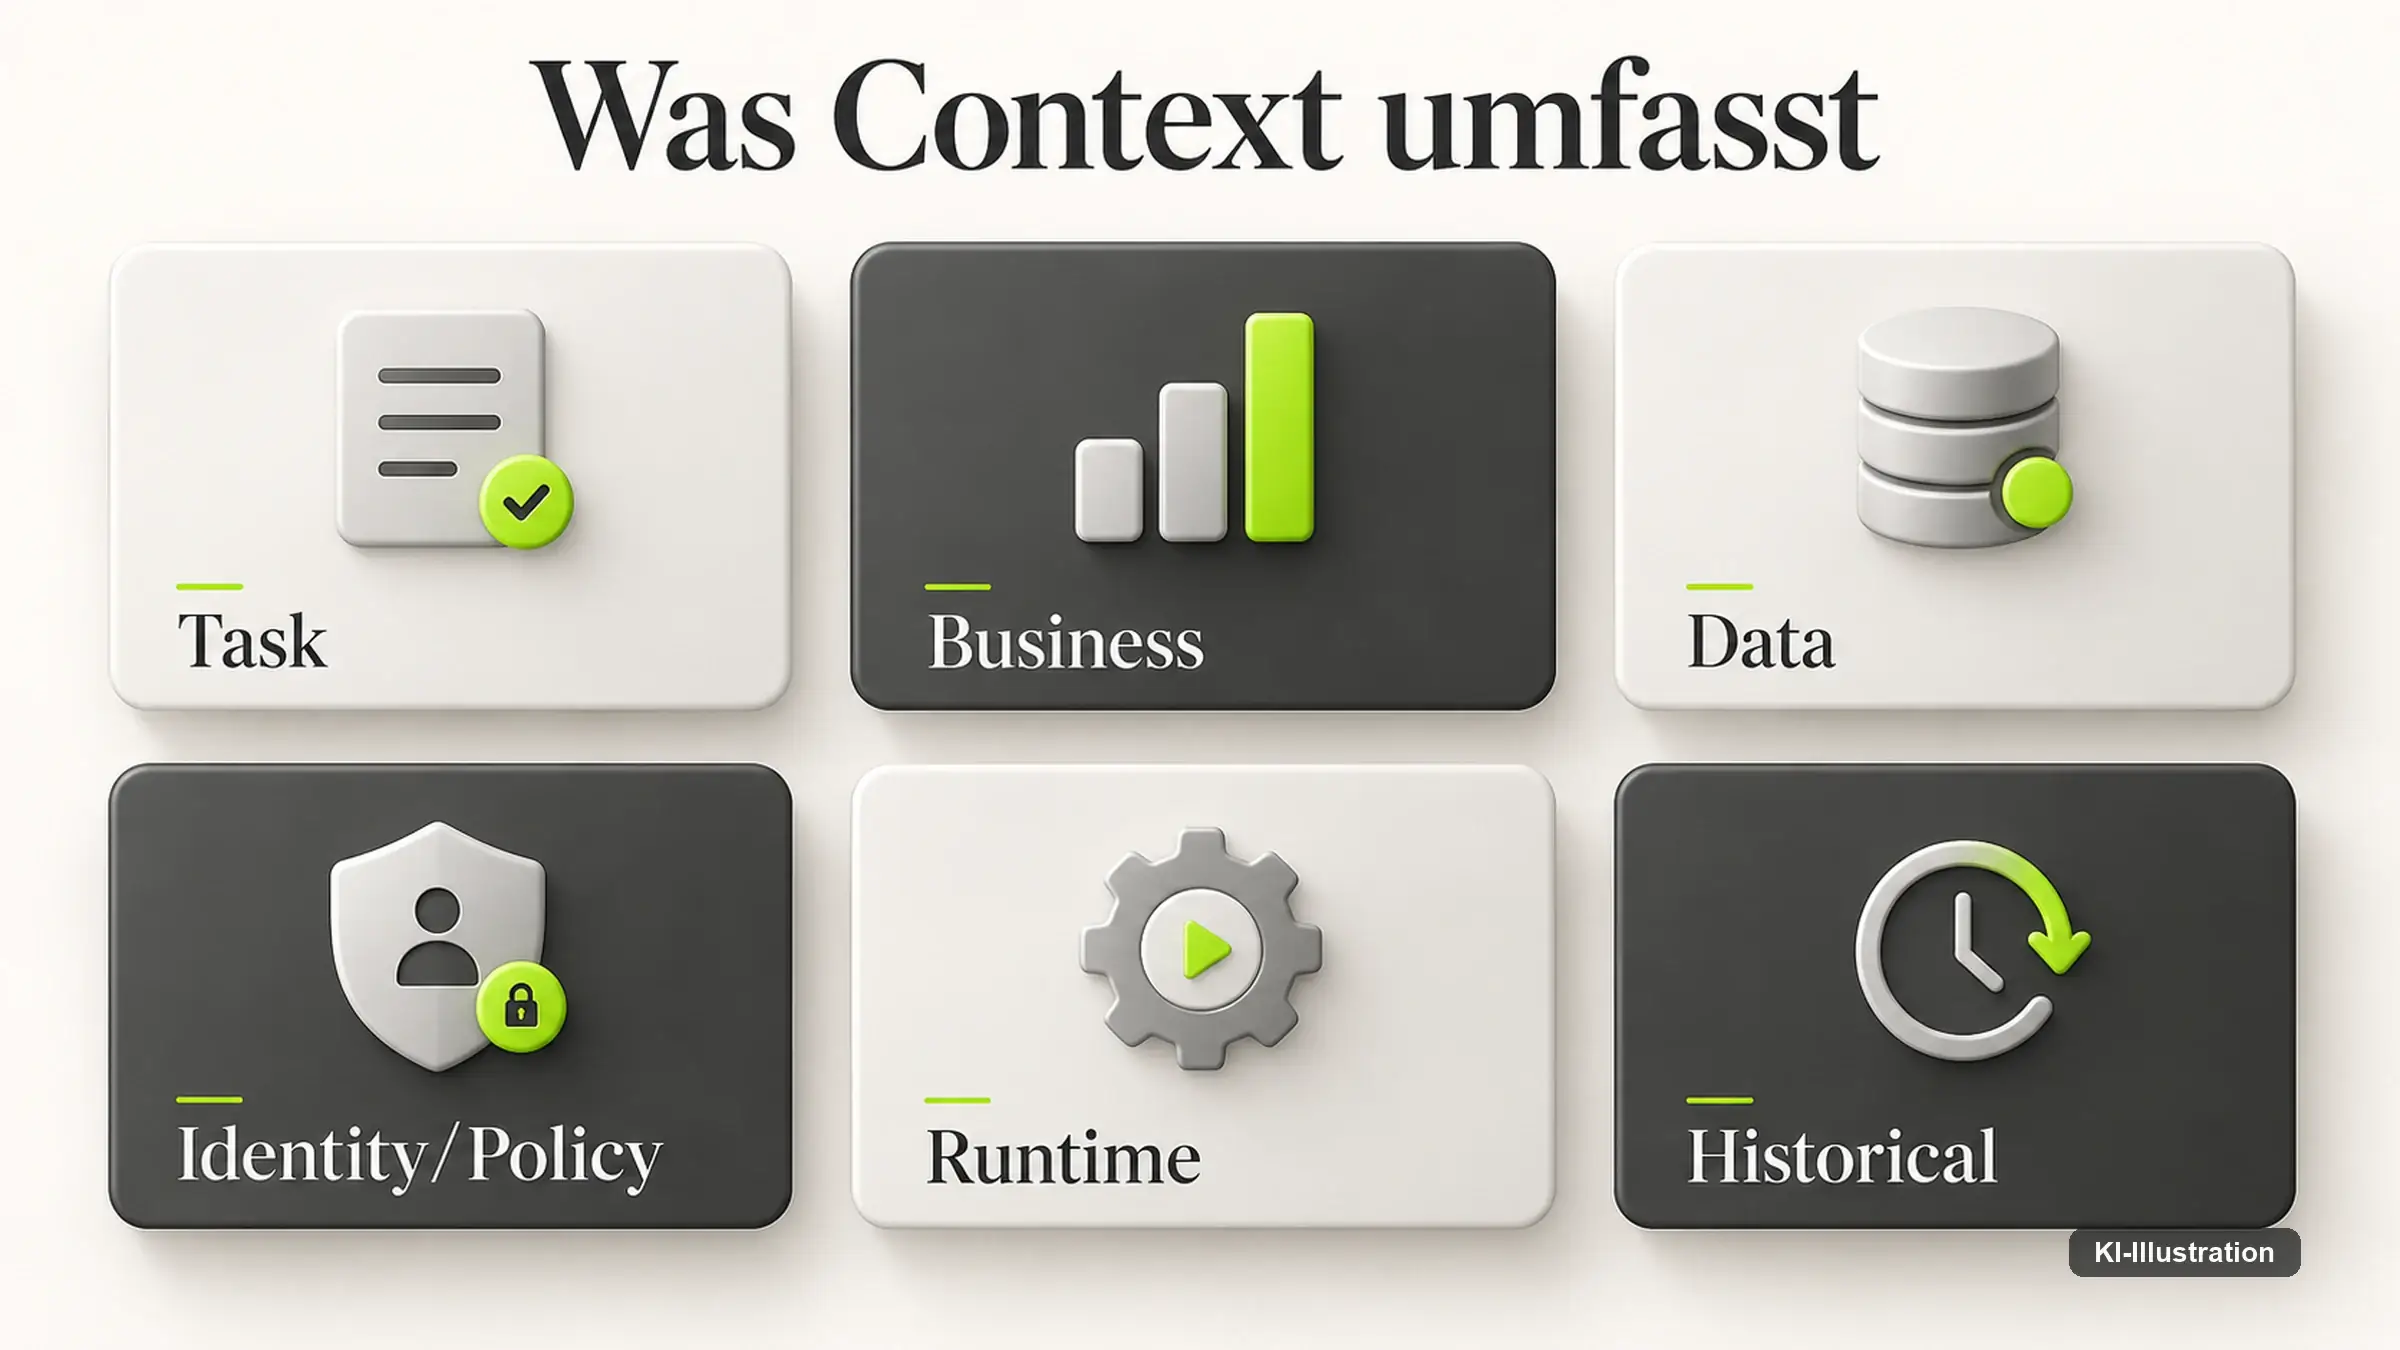
Diese Einteilung ist unsere eigene und in keiner Norm verankert. Sie hat einen praktischen Zweck: Jeder Bestandteil fällt anders auf, wenn er fehlt, und manche fallen erst nach Monaten auf.
| Bestandteil | Was fehlt, wenn er fehlt | Woran es im Betrieb auffällt |
|---|---|---|
| Quellenauswahl | Das System sieht, was der Suchindex hergibt, nicht was die Frage verlangt | Antworten stimmen im Ton und liegen im Detail daneben; eine leicht andere Formulierung der Frage führt zu einem anderen Ergebnis |
| Metadaten zu Herkunft, Gültigkeit und Vertraulichkeit | Jedes Dokument wirkt wie jedes andere | Entwürfe, abgelöste Fassungen und Werbetexte landen gleichberechtigt in derselben Antwort |
| Rechte | Der Agent sieht mehr, als die anfragende Person sehen darf | fällt oft erst auf, wenn jemand etwas zitiert bekommt, das er nicht kennen dürfte |
| Aktualität | Geantwortet wird auf dem Stand des letzten Indexlaufs | Widerspruch zu Systemen, die laufend geführt werden; Rückfragen aus dem Tagesgeschäft häufen sich |
| Aufbereitung: Zerlegung, Reihenfolge, Menge | Das Entscheidende steht an einer Stelle, an der es untergeht | Ergebnisse schwanken, obwohl sich nur die Reihenfolge der Fundstellen geändert hat |
| Rückverfolgbarkeit | Niemand kann sagen, worauf eine Antwort beruhte | ein Fehler lässt sich nicht eingrenzen; jede Prüfung beginnt bei null |
Die dritte Zeile ist die unangenehmste, weil sie leise versagt. Ein Agent hat in der Regel einen technischen Zugang mit weiten Rechten, denn sonst funktioniert die Hälfte der Anwendungsfälle nicht. Ob er im Einzelfall auch ausgeben darf, was er gefunden hat, entscheidet sich erst in der Kontextschicht — und wenn dort nichts entscheidet, entscheidet niemand.
Das Bundesamt für Sicherheit in der Informationstechnik empfiehlt für Agenten ausdrücklich minimale Berechtigungen, eine Bestätigungspflicht für wichtige Aktionen und die Prüfung von Protokollen. Die Empfehlung ist unverbindlich, und die Themenseite, auf der sie steht, weist keinen Stand aus. Bemerkenswert ist trotzdem die Einstufung daneben: Das Amt hält KI-Agenten technologisch für ein frühes Stadium.
Die letzte Zeile wiederum entscheidet darüber, ob aus einem Fehler eine Korrektur werden kann. Ohne Aufzeichnung der herangezogenen Quellen bleibt jede Fehleranalyse Vermutung, und keine Verbesserung der Schicht lässt sich gegen den vorherigen Stand prüfen.
Dieselbe Schicht schützt und öffnet
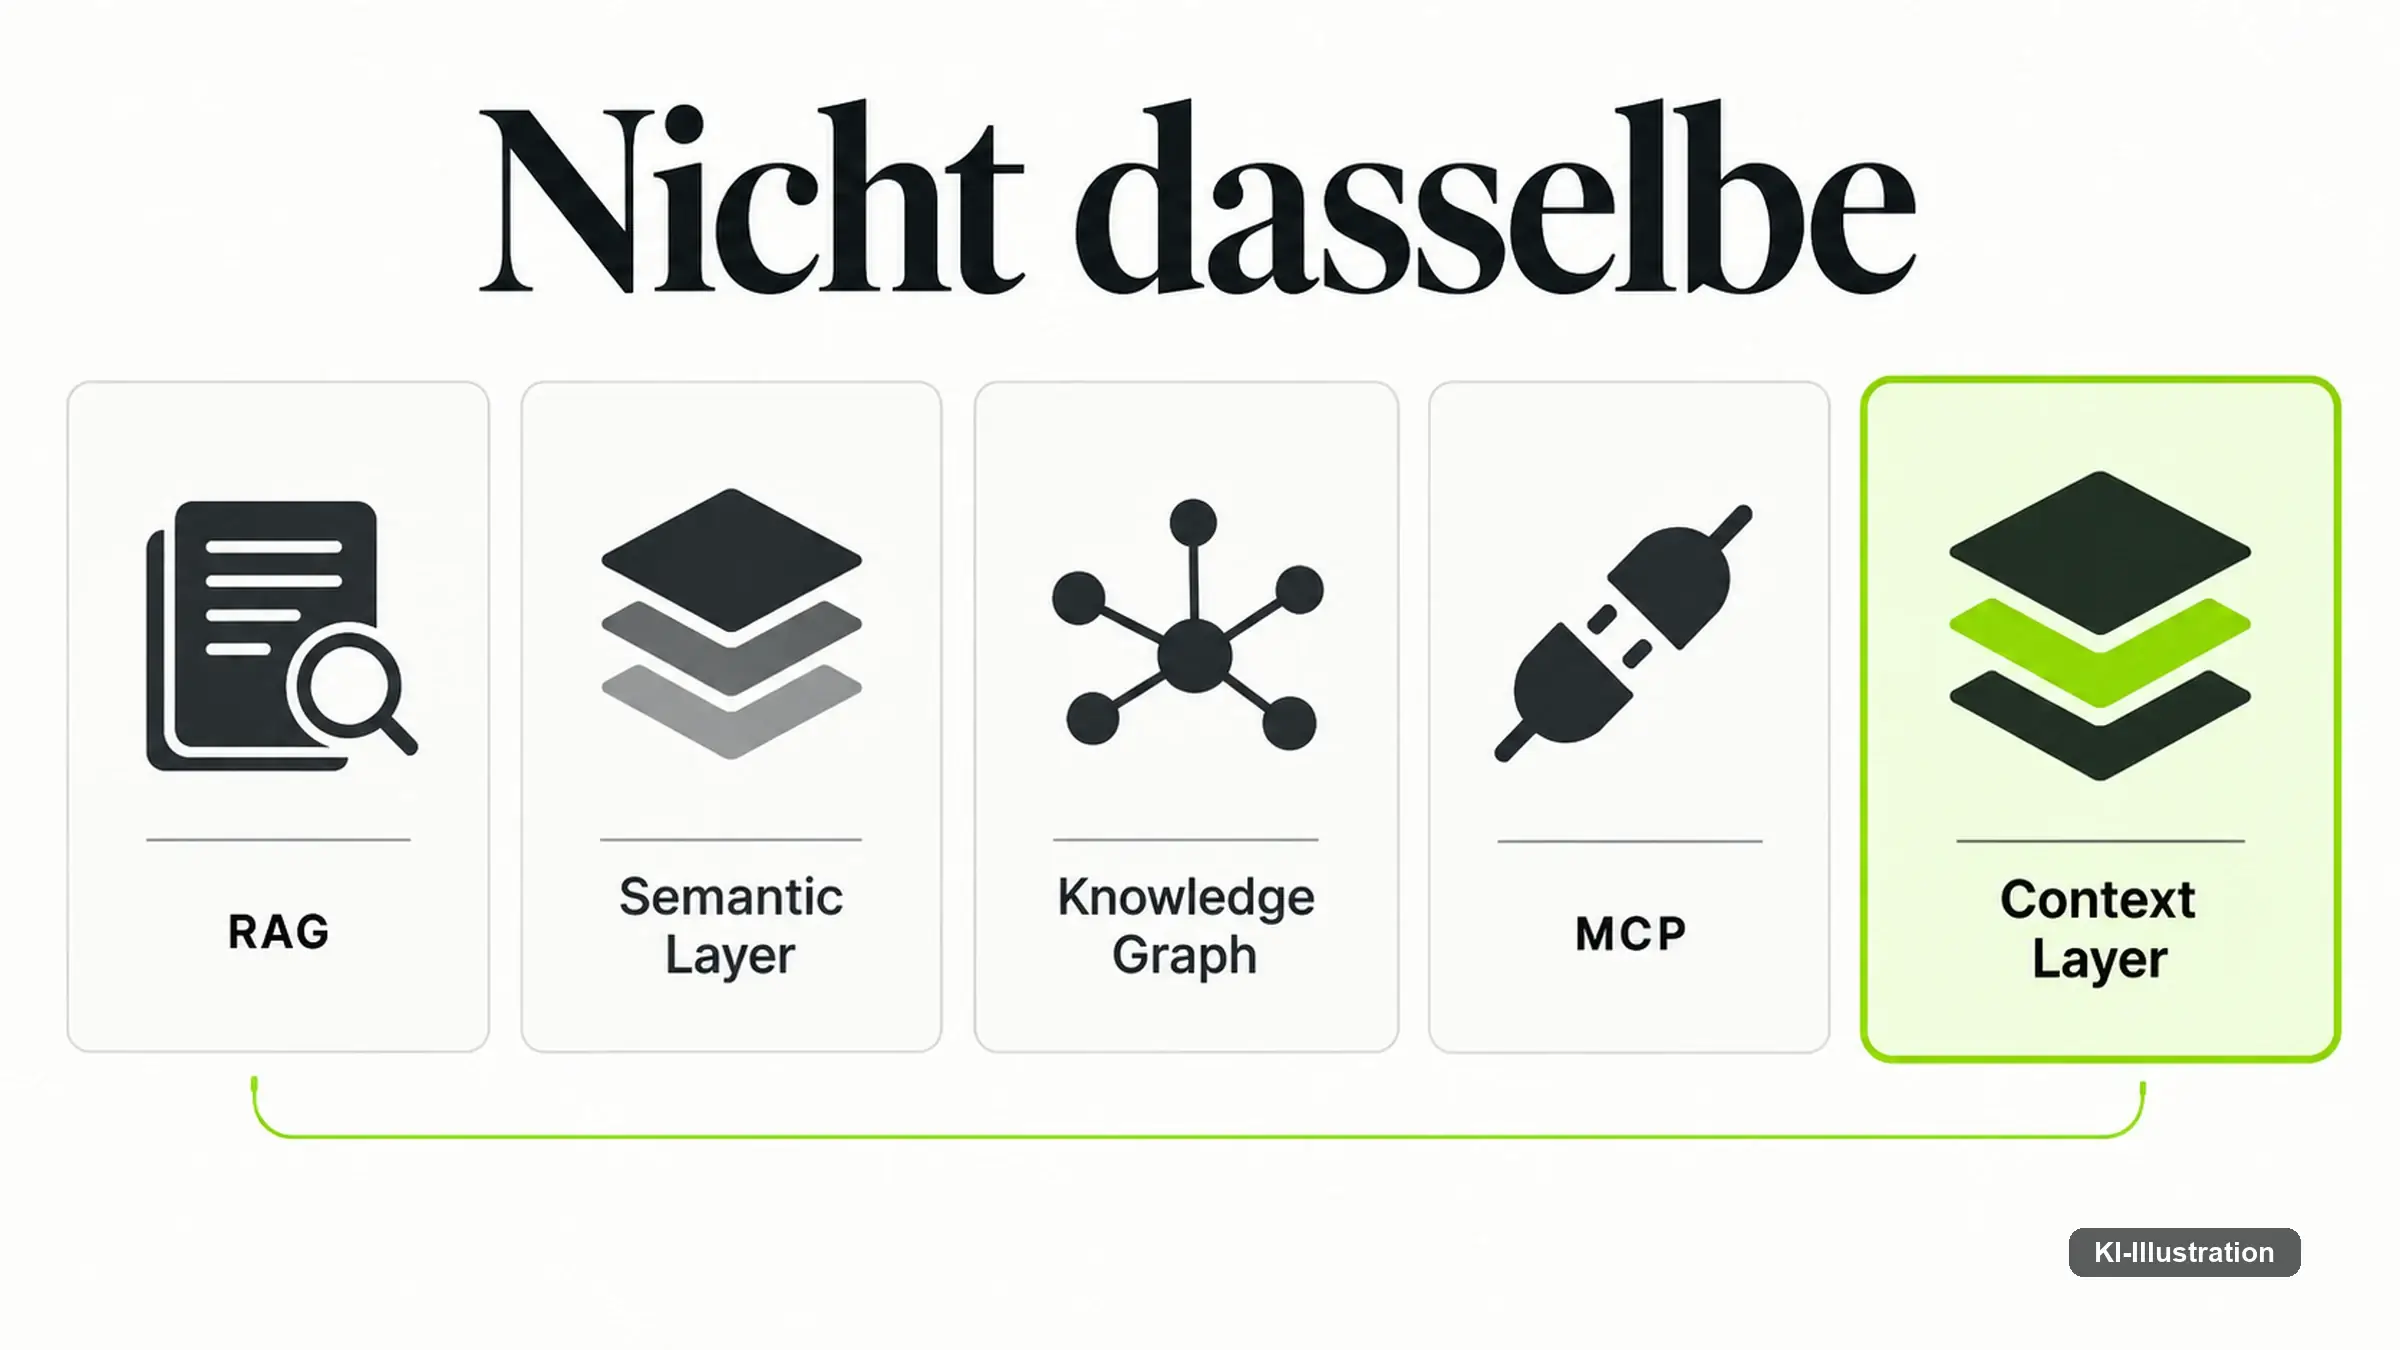
Bemerkenswert an dieser Technik ist, dass sie in staatlichen Dokumenten auf beiden Seiten der Bilanz steht. Sie gilt als Gegenmaßnahme, und sie gilt als Risiko, in denselben Papieren.
Das US-amerikanische Normungsinstitut NIST führt in seinem Rahmenwerk für generative KI vom Juli 2024 zwölf Risiken auf, die für diese Technik neu oder verschärft sind; Konfabulation steht darunter an zweiter Stelle. Die Maßnahme MS-2.3-001 nennt das Heranziehen abgerufener Dokumente ausdrücklich als etwas, das gegen Informationssicherheit und gegen Konfabulation zu bewerten ist. Das Rahmenwerk ist freiwillig, rechtlich nicht bindend und enthält keine Messwerte.
Deutlicher wird das BSI in seinem Dokument zu generativen KI-Modellen, Version 2.0 vom 17. Januar 2025. Dort erscheint der Abruf externer Dokumente als Gegenmaßnahme M14 — und die Wissensbasis zugleich als eigenes Risiko R18 unter der Bezeichnung Knowledge Poisoning. Begründet wird das damit, dass Angreifer manipulierte Inhalte einschleusen können, die bei bestimmten Eingaben vorgefertigte Ausgaben auslösen.
Das ist kein Widerspruch, sondern eine nüchterne Beschreibung. Wer einem Modell erlaubt, Inhalte von außen in seine Entscheidung zu ziehen, verlagert einen Teil der Kontrolle dorthin, wo diese Inhalte herkommen. Auf der Themenseite zu Agenten nennt dasselbe Amt Prompt Injection über Webseiten und E-Mails sowie Kettenreaktionen bei vernetzten Agenten.
Auch diese Einordnung hat Grenzen, und sie gehören dazugesagt. Die Risikoliste des BSI ist qualitativ, sie nennt keine Eintrittswahrscheinlichkeiten und betrachtet die Sache rein aus der Sicht der IT-Sicherheit. Wie häufig Knowledge Poisoning in echten Aufbauten vorkommt, steht dort nicht, weil es niemand erhoben hat.
Für die Beschaffung folgt daraus eine unbequeme Reihenfolge. Wie gut eine Kontextschicht Antworten verbessert, lässt sich in einem Testlauf beantworten. Wie gut sie gegen eingeschleuste Inhalte geschützt ist, lässt sich so nicht beantworten — denn ein Angriff, der auf bestimmte Eingaben wartet, zeigt sich in einem Testlauf gerade nicht.
Warum derselbe Auftrag zweimal verschieden ausgeht
Es gibt eine Eigenschaft von Agentensystemen, die in Vorführungen nie vorkommt und im Betrieb sofort auffällt: Dieselbe Aufgabe geht beim zweiten Mal anders aus als beim ersten.
Die Arbeit τ-bench von Sierra AI und der Princeton University hat das gemessen, indem sie dieselbe Aufgabe achtmal wiederholte. Im Handelsszenario lag die Quote der Fälle, in denen ein führender Agent alle acht Durchläufe erfolgreich abschloss, unter 25 Prozent. Geprüft wurde in zwei Domänen mit simulierten Nutzern, der Modellstand liegt bei Mitte 2024.
Für eine Fachabteilung ist das die härtere Nachricht als jede Erfolgsquote. Ein System, das 60 Prozent der Vorgänge schafft, lässt sich organisieren, sofern es dieselben 60 Prozent schafft. Ein System, dessen Treffer wandern, lässt sich nicht organisieren, weil sich keine Regel ableiten lässt, wann ein Mensch hinsehen muss.
Wo diese Schwankung herkommt, ist damit noch nicht gesagt. Eine Gruppe des Sky Computing Lab an der University of California in Berkeley hat über 1.600 annotierte Ausführungsspuren aus sieben verbreiteten Rahmenwerken durchgesehen und daraus 14 Fehlermodi in drei Kategorien abgeleitet, bei einer Übereinstimmung der Annotierenden von Kappa 0,88. Das Ergebnis ist eine Ordnung von Fehlerarten, ausdrücklich keine Messung von Häufigkeiten.
Dass die Kontextschicht an der Schwankung beteiligt ist, liegt nahe, wird aber in keiner der beiden Arbeiten behauptet — die Verbindung ziehen wir, und sie ist eine Vermutung. Plausibel ist sie, weil zwischen zwei Durchläufen derselben Aufgabe kaum etwas schwankt außer der Auswahl und Reihenfolge des Materials, das in den Aufruf geht. Belegt wäre sie erst, wenn jemand dieselbe Aufgabe bei eingefrorenem Kontext wiederholte und die Streuung dabei zurückginge.
Wer diese Schicht ordnet — und wer nicht
Wenn eine Schicht so folgenreich ist, liegt die Frage nahe, wer für sie zuständig ist. Zwei Antworten werden derzeit gehandelt, und beide tragen weniger, als ihre Namen vermuten lassen.
Das Model Context Protocol ist seit der Übertragung an LF Projects, LLC nicht mehr an ein einzelnes Unternehmen gebunden. Es steht unter der Apache-Lizenz 2.0, und die Mitgliedschaft in den Gremien hängt an Personen statt an Unternehmen. Das ist mehr Offenheit, als viele Schnittstellen dieser Art bieten.
Nur endet die Entscheidungskette bei zwei Lead Maintainers als letzter Instanz. Ein Konsensverfahren wie bei ISO oder beim W3C gibt es nicht, und damit auch keinen Weg, auf dem ein überstimmter Beteiligter formal Einspruch erheben könnte. Offene Lizenz und offene Leitung sind zwei verschiedene Eigenschaften.
Die zweite Antwort ist die AI Agent Protocol Community Group beim W3C, gegründet am 8. Mai 2025, mit fünf Arbeitsfeldern, zu denen standardisierte Metadatenformate gehören. Eine Community Group ist beim W3C allerdings kein Standardisierungsgremium. Ihre Ergebnisse binden niemanden, und sie durchlaufen nicht den Prozess, aus dem am Ende eine Empfehlung wird.
Praktisch heißt das: Was gerade nach Standardisierung aussieht, ist Abstimmung. Der Unterschied wird greifbar, sobald ein Betreiber sich auf etwas berufen will — auf eine Empfehlung kann man sich berufen, auf ein Arbeitsfeld einer Interessengruppe nicht.
Was sich daraus für den eigenen Betrieb ergibt
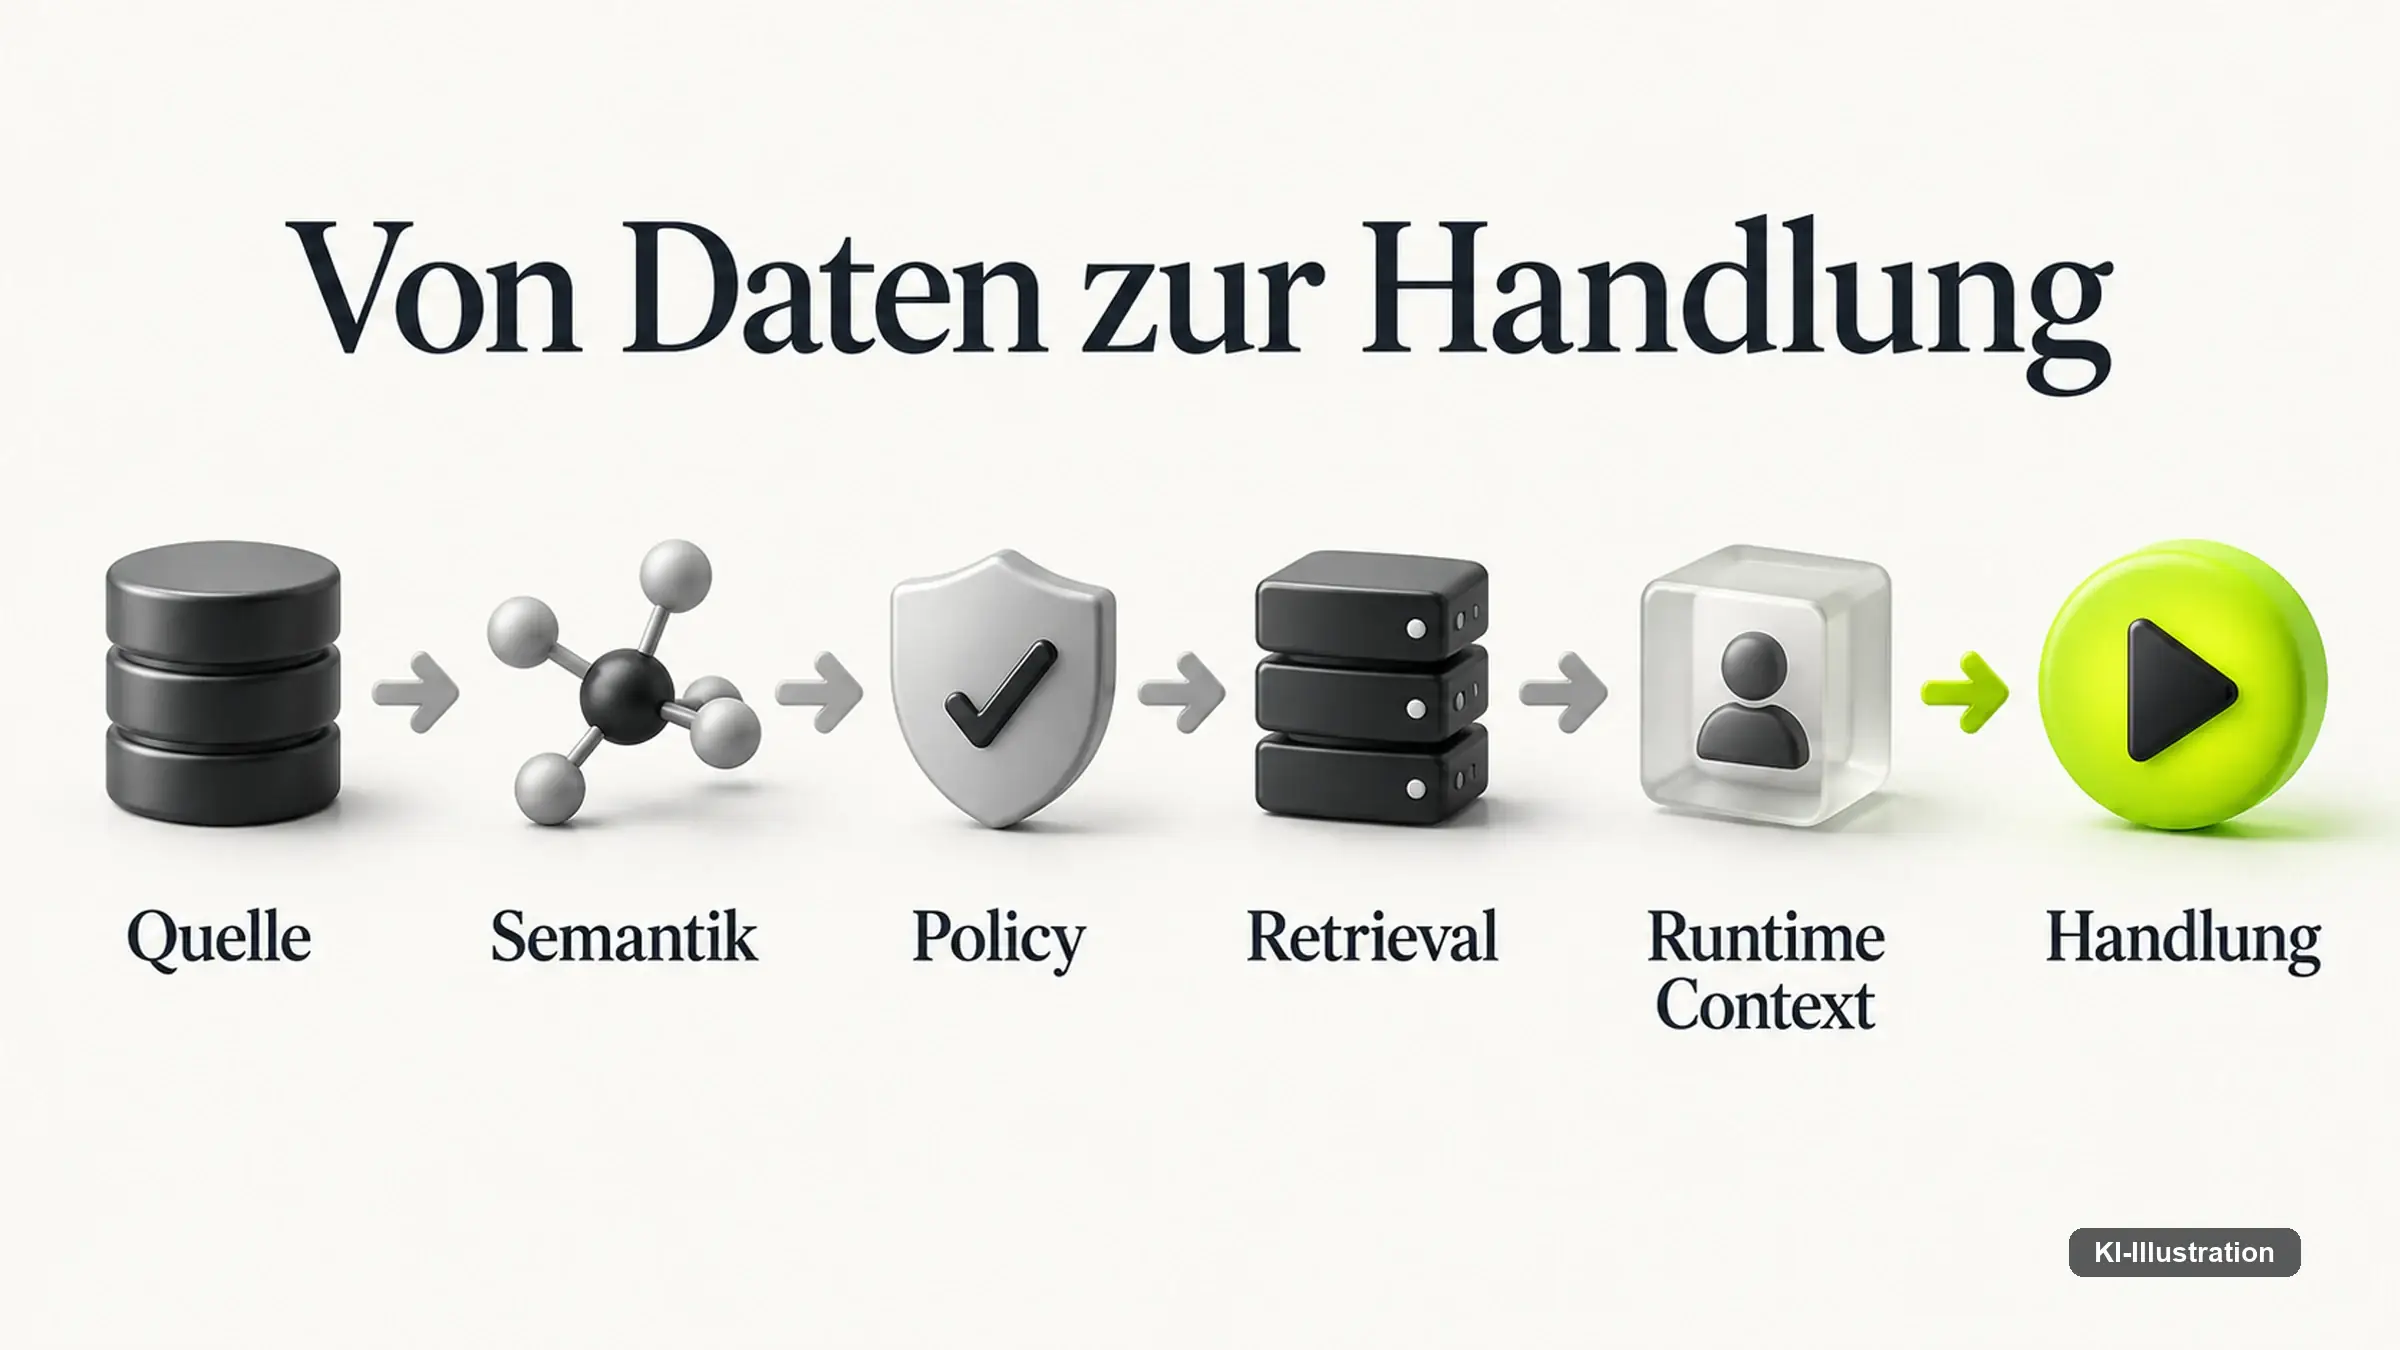
Vor jeder Übertragung steht eine Einschränkung. Sämtliche hier genannten Messwerte stammen aus konstruierten Aufgaben mit bekannten Lösungen und nicht aus Unternehmensdaten; die Rahmenwerke von NIST und BSI enthalten überhaupt keine Messungen. Was sich daraus ableiten lässt, sind Prüffragen, keine Erwartungswerte für das eigene Haus.
Die erste dieser Fragen betrifft das Verhalten bei fehlender Grundlage. Ein Anbieter, der die Enthaltungsquote seines Aufbaus nennen kann, hat sie gemessen; wer sie nicht kennt, weiß nicht, wie oft sein System auf dünnem Material antwortet. Die Methode dafür ist nicht aufwendig, denn sie besteht darin, Fragen zu stellen, deren Antwort im Bestand bewusst fehlt.
Die zweite Frage betrifft das Geld, und sie hängt enger mit der Kontextschicht zusammen, als es zunächst wirkt. Jedes Dokument, das in eine Anfrage wandert, wird als Token bezahlt, bei jedem Durchlauf neu. In der McKinsey-Befragung vom 25. August 2026 geben 20 Prozent der Unternehmen an, dass laufende KI-Betriebskosten einschließlich der Token-Kosten ihren Einsatz begrenzt haben — eine Selbstauskunft, kein geprüfter Wert. Eine Schicht, die schlecht auswählt, bezahlt man also zweimal: in der Qualität und in der Rechnung.
Die dritte Frage betrifft die Zuständigkeit. Ob ein Dokument in den Bestand eines Agenten gehört, ist selten eine technische Entscheidung, sondern eine über Vertraulichkeit, Gültigkeit und Verantwortung. Wird sie nicht getroffen, trifft sie der Suchindex.
Für Systeme, die sich in der physischen Welt bewegen, stellt sich dieselbe Grundfrage, und sie ist hier nicht beantwortet. Alle ausgewerteten Arbeiten betreffen Text. Ob Sensordaten, Karten und Zustandsmeldungen einem Modell ähnlich zu Kopf steigen wie beigelegte Dokumente, ist damit weder gezeigt noch widerlegt.
Bleibt der Befund, der am Anfang stand und der die ganze Debatte um diese Schicht trägt. Zusätzlicher Kontext macht ein System nicht nur besser informiert. Er macht es zuversichtlicher, und zwar messbar auf Kosten der Enthaltung. Wer eine Datenschicht einzieht, ändert deshalb nicht nur, was sein System weiß, sondern wie es sich verhält, wenn es etwas nicht weiß.
Quellen. Alle Adressen wurden am 13. September 2026 geprüft. Wo eine Seite automatisierte Abrufe abweist, wurde sie im Browser geöffnet und der Inhalt gegen die Nennung abgeglichen. Anbieterquellen sind als solche gekennzeichnet und tragen keine unabhängige Wirkungsaussage.
- Joren et al., Sufficient Context: A New Lens on Retrieval Augmented Generation Systems, ICLR 2025 — Anteil unzureichender Kontexte und Enthaltungsquoten.
- Liu et al., Lost in the Middle: How Language Models Use Long Contexts, Stanford University und UC Berkeley, TACL.
- Hsieh et al., RULER: What’s the Real Context Size of Your Long-Context Language Models?, NVIDIA.
- τ-bench, Sierra AI und Princeton University — Wiederholbarkeit über acht Durchläufe.
- MAST, Sky Computing Lab der University of California, Berkeley — 14 Fehlermodi aus über 1.600 Ausführungsspuren.
- NIST, AI 600-1: Generative Artificial Intelligence Profile, Juli 2024 — Maßnahme MS-2.3-001.
- Bundesamt für Sicherheit in der Informationstechnik, Generative AI Models — Opportunities and Risks, Version 2.0 vom 17. Januar 2025, Maßnahme M14 und Risiko R18.
- Bundesamt für Sicherheit in der Informationstechnik, KI-Agenten — die Seite weist keinen Stand aus.
- Model Context Protocol, Governance sowie W3C AI Agent Protocol Community Group.
- Anbieterquellen: Atlan, Context Layer for AI und Context Layer (Dokumentation); Anthropic, Effective context engineering for AI agents.
- McKinsey & Company, The state of AI in 2026, 25. August 2026 — Selbstauskünfte einer Befragung.
- Gartner, Over 40% of Agentic AI Projects Will Be Canceled by End of 2027, 25. Juni 2025 — Prognose und Schätzung.
- HumanX Europe 2026, Programm — Titel, Zeit und Beteiligte des Roundtables zur Kontextschicht.
Die Angaben zur Rechtslage und zu Rahmenwerken sind eine redaktionelle Einordnung und keine Rechtsberatung.
Lohnt es sich, auf Modelle mit sehr großem Kontextfenster zu warten?
Als Lösung für dieses Problem eher nicht. Die geprüfte Schwäche liegt in der Auswahl des Materials, nicht in seiner Menge: In 55,4 Prozent der untersuchten Fälle trug der bereitgestellte Kontext die Antwort ohnehin nicht. Ein größeres Fenster erlaubt, mehr ungeeignetes Material mitzuschicken, und die Untersuchung von NVIDIA zeigt zudem, dass beanspruchte und nutzbare Länge auseinanderfallen.
Wie lässt sich prüfen, ob die eigene Kontextschicht trägt?
Mit dem Vorgehen, das auch die ICLR-Arbeit verwendet: Fragen stellen, deren Antwort im eigenen Bestand nachweislich fehlt, und zählen, wie oft das System sich enthält statt zu antworten. Dieselbe Messung einmal ohne und einmal mit beigegebenem Kontext zeigt, wie stark die Schicht das Antwortverhalten verschiebt. Ohne diesen Vergleichswert bleibt unbekannt, wie oft auf dünnem Material geantwortet wird.
Wie belastbar sind diese Messwerte für den eigenen Betrieb?
Sie zeigen die Richtung, nicht die Höhe. Alle genannten Werte stammen aus konstruierten Aufgaben mit bekannten Lösungen — Frage-Antwort-Datensätze mit je 500 Beispielen, synthetische Aufgaben, simulierte Nutzer — und der Modellstand liegt zwischen 2023 und 2025. Eine gewachsene Unternehmensablage mit Altfassungen, Zugriffsrechten und widersprüchlichen Dokumenten ist darin nicht abgebildet.
Was kostet eine Kontextschicht?
Belastbare Vergleichszahlen dazu liegen nicht vor, und Anbieterangaben sind keine. Bekannt ist der Mechanismus: Jedes Dokument, das in eine Anfrage geht, wird bei jedem Durchlauf als Token bezahlt, gescheiterte Versuche eingeschlossen. In der McKinsey-Befragung vom 25. August 2026 nennen 20 Prozent der Unternehmen laufende KI-Betriebskosten einschließlich Token-Kosten als Begrenzung ihres Einsatzes; das ist eine Selbstauskunft.
Reicht es, die Wissensbasis einmal auf manipulierte Inhalte zu prüfen?
Das BSI beschreibt das Risiko so, dass eingeschleuste Inhalte erst bei bestimmten Eingaben eine vorgefertigte Ausgabe auslösen — eine einmalige Sichtung zeigt das also nicht zwingend. Empfohlen werden dort minimale Berechtigungen, eine Bestätigungspflicht für wichtige Aktionen und die Prüfung von Protokollen, ergänzt um den Hinweis auf Prompt Injection über Webseiten und E-Mails. Die Risikoliste ist qualitativ und nennt weder Eintrittswahrscheinlichkeiten noch Wirkungsnachweise.
Kann ich mich beim Anbieterwechsel auf das Model Context Protocol stützen?
Nur begrenzt. Das Protokoll ist seit der Übertragung an LF Projects, LLC nicht mehr herstellergebunden und steht unter der Apache-Lizenz 2.0, seine Leitung endet aber bei zwei Lead Maintainers als letzter Instanz, ohne Konsensverfahren wie bei ISO oder W3C. Es regelt zudem den Zugriff auf Werkzeuge, nicht die Frage, wem aufbereitete Daten gehören und wie lange eine Schnittstelle betrieben wird — das gehört in den Vertrag.
Gilt der Befund auch für Agenten, die Werkzeuge aufrufen statt Dokumente zu lesen?
Für diese Systeme liegen eigene Messungen vor, und sie fallen ebenfalls nüchtern aus: In der Untersuchung τ-bench von Sierra AI und der Princeton University lösen führende Agenten mit Werkzeugzugriff unter 50 Prozent der Aufgaben, geprüft in zwei Domänen mit simulierten Nutzern, Modellstand Mitte 2024. Der Kontext besteht hier aus Werkzeugergebnissen und Gesprächsverlauf statt aus Dokumenten; die Frage, ob das System die nötige Information zum richtigen Zeitpunkt sieht, bleibt dieselbe.
Was heißt das für Systeme, die in der physischen Welt arbeiten?
Aus den hier ausgewerteten Arbeiten lässt sich dazu nichts ableiten, weil sie sämtlich Text betreffen. Ob Sensordaten, Karten und Zustandsmeldungen dieselbe Wirkung auf das Antwortverhalten haben wie beigelegte Dokumente, ist damit weder belegt noch widerlegt. Übertragbar ist allein die Prüffrage, ob ein System merkt, wenn ihm eine Information fehlt.