News & Markt · Analyse
HumanX Amsterdam 2026: Woran Sie erkennen, welche KI-Systeme den Sprung in den Betrieb schaffen
Kurz gesagt: Vom 22. bis 24. September 2026 läuft im RAI Amsterdam die HumanX Europe 2026. Das veröffentlichte Programm führt 173 Punkte, darunter 20 Roundtables unter Ausschluss der Öffentlichkeit und einen eigenen Programmpunkt zu den wahren Kosten von KI. Diese Verteilung ist selbst ein Befund: Ein Feld, das über Skalierung diskutiert, hat sie noch nicht hinter sich. Die Messwerte stützen das — der beste Agent löst in einer akademischen Prüfung 30,3 Prozent realistischer Büroaufgaben allein.
Was ein Konferenzprogramm über einen Markt verrät
Wer wissen will, wie weit eine Technologie ist, sollte nicht auf die Ankündigungen der Anbieter schauen. Er sollte schauen, worüber sie sich untereinander verständigen wollen.
Denn ein Konferenzprogramm entsteht anders als eine Pressemitteilung. Es wird Monate im Voraus gebaut, aus Themenvorschlägen, aus dem, wofür sich Sprecherinnen und Sprecher melden, und aus der Einschätzung der Veranstalter, wofür Menschen ein Flugticket lösen. Eine Pressemitteilung sagt, was funktionieren soll. Ein Programm sagt, woran gerade gearbeitet wird — und damit indirekt, was noch nicht funktioniert.
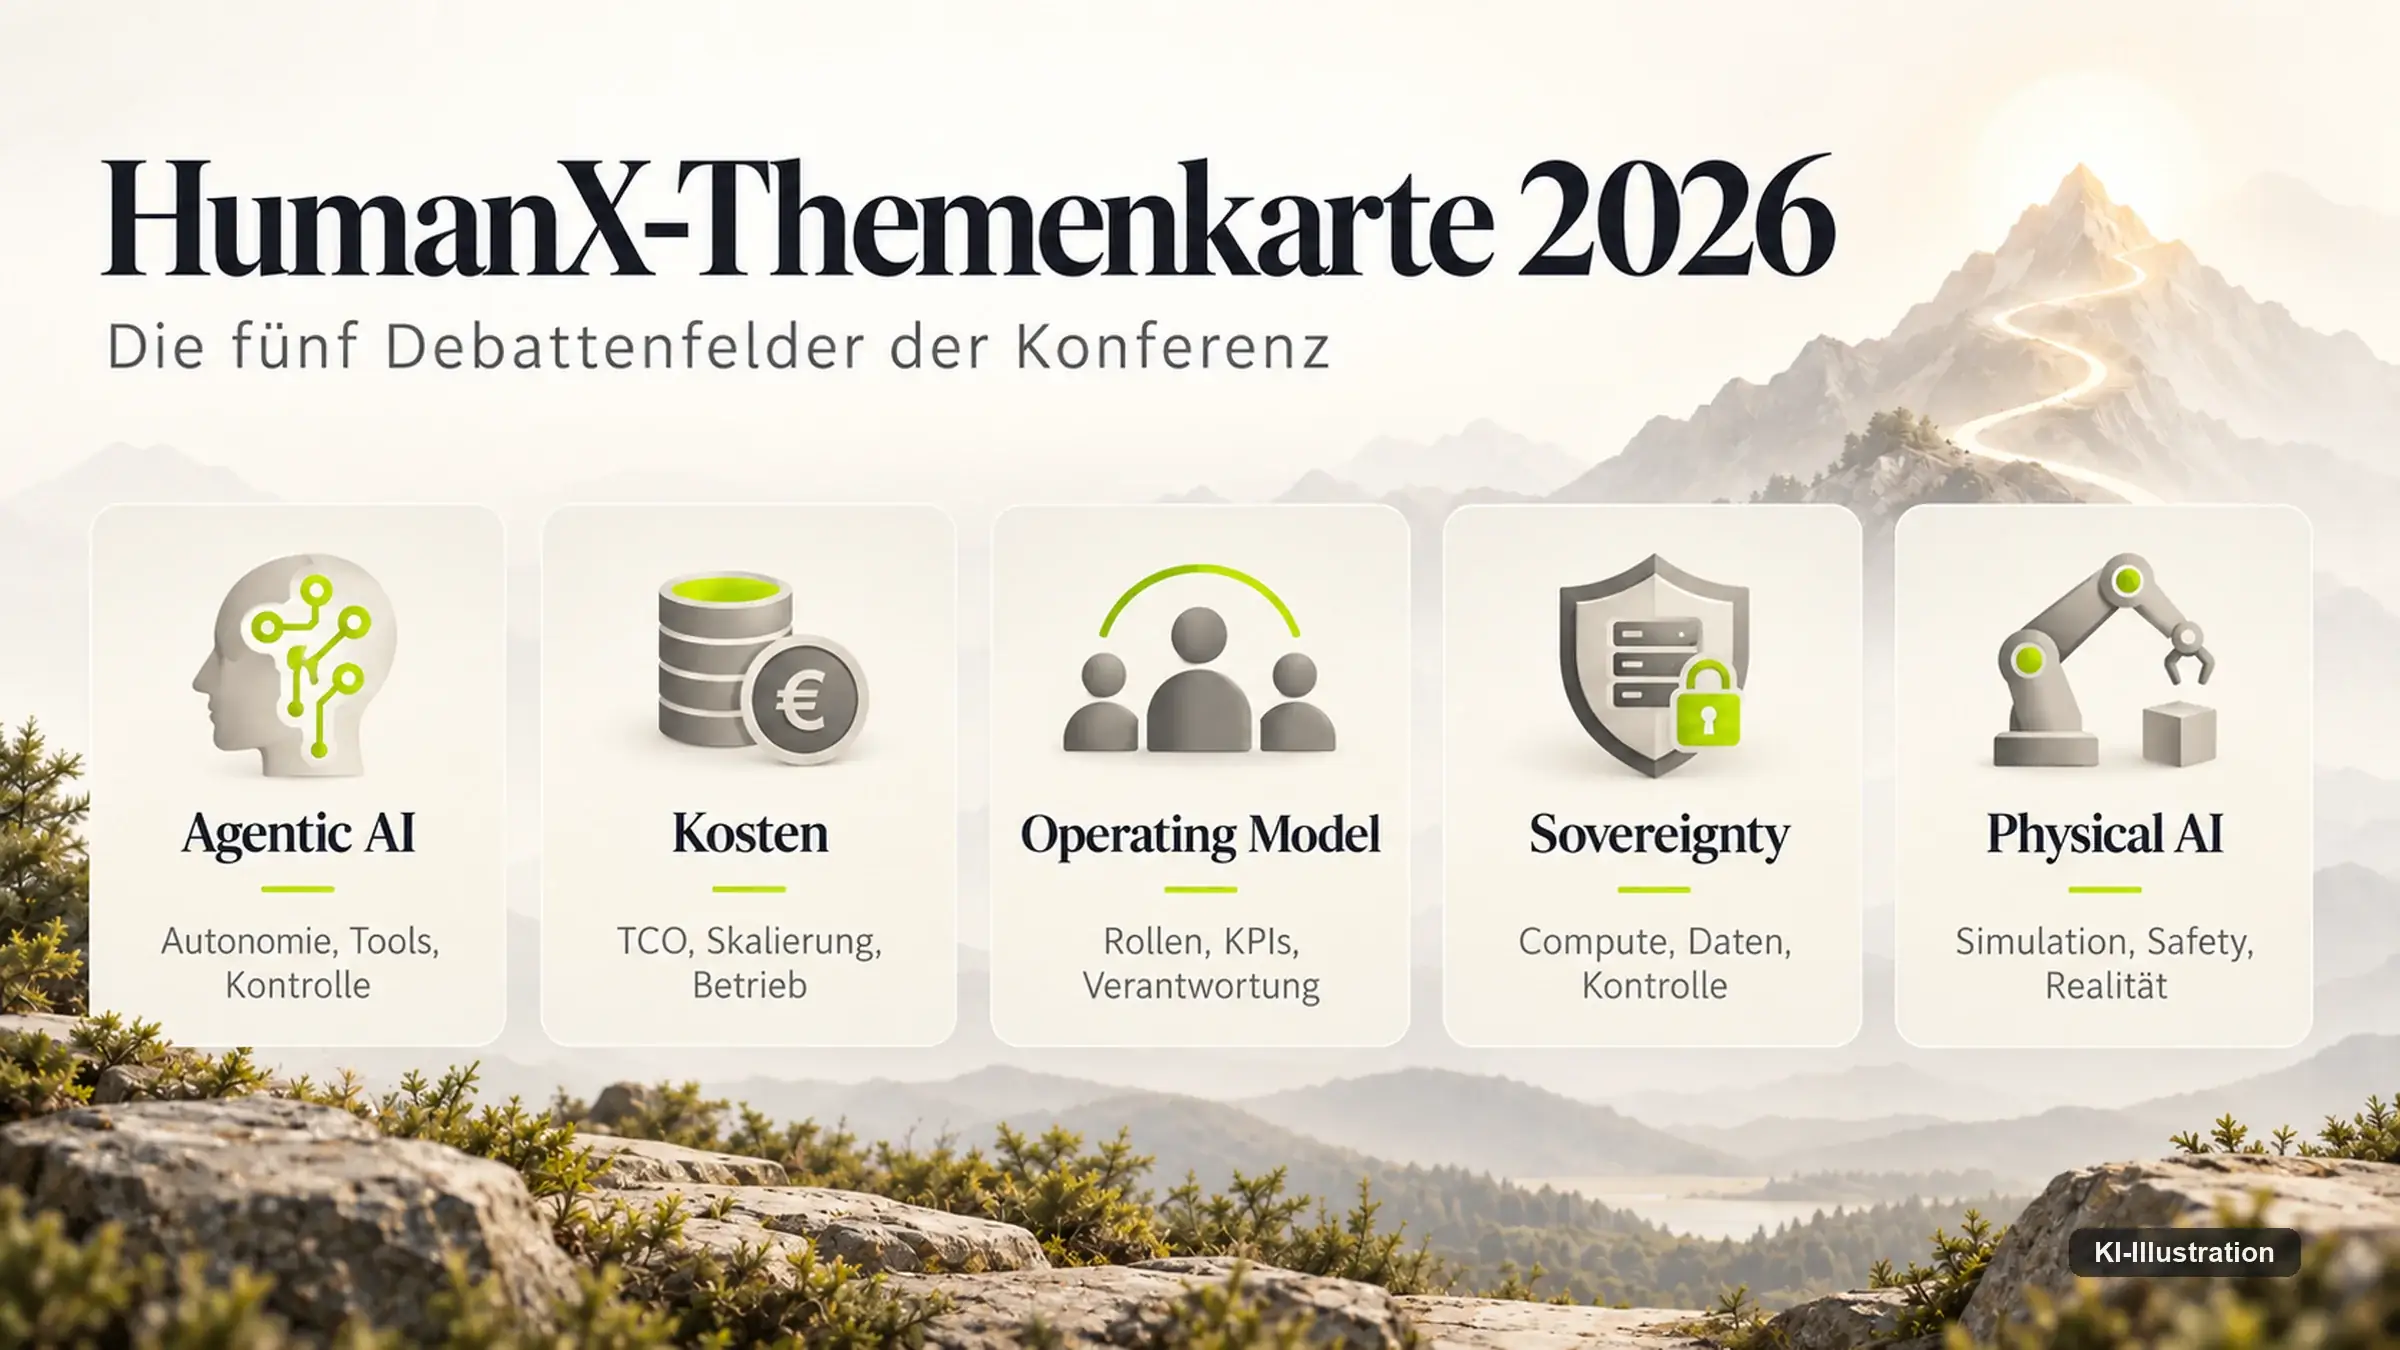
Bei der HumanX Europe 2026 lohnt dieser Blick besonders. Die Veranstaltung läuft vom 22. bis 24. September 2026 im RAI Amsterdam und gliedert sich in fünf Themenstränge, die das Programm Builders, Command Desk, Control Room, Customer Engine und Ecosystem nennt. Dazu kommen zwei eigene Ausstellungsflächen, das Dutch AI Pavilion und das Physical AI Pavilion.
Dieser Beitrag erschien vor Beginn der Veranstaltung. Er referiert deshalb keine einzige Aussage von der Bühne — die gibt es zum Redaktionsschluss schlicht nicht. Was er auswertet, ist das öffentlich einsehbare Programm: welche Fragen gestellt werden, in welchem Format, von wem, und wie oft. Diese Angaben hält der Veranstalter selbst fest, und sie sind damit belastbar.
Gegengeprüft wird das Programm dann an etwas, das von der Veranstaltung unabhängig ist: an Messungen und Erhebungen aus Forschung und Statistik. Wo beide dasselbe sagen, ist die Lage stabil. Wo sie auseinandergehen, wird es interessant.
173 Punkte, und warum ihre Verteilung zählt
Das Programm führt zum Stichtag 13. September 2026 insgesamt 173 Punkte. Davon sind 95 klassische Vorträge, 20 Roundtables, 19 Fragerunden, 19 Netzwerkformate, 11 Masterclasses, 6 Pitch-Sessions und 3 Partnerprogramme.
Die 95 Vorträge überraschen niemanden, das ist die Grundform jeder Konferenz. Bemerkenswert sind die 20 Roundtables. Ein Roundtable ist ein Gespräch unter Anwesenden, ohne Bühne und ohne Aufzeichnung, und die Plätze sind begrenzt — der Roundtable zur Skalierung agentischer KI etwa fasst 19 Personen und wird nach Reihenfolge des Erscheinens vergeben.
Dieses Format wählt man nicht, um etwas zu präsentieren. Man wählt es, wenn die Antwort noch nicht feststeht und die Beteiligten offen reden sollen, ohne dass jeder Satz zitierbar wird. Jeder neunte Programmpunkt dieser Konferenz ist so angelegt. Das ist viel für ein Feld, das sich nach außen so sicher gibt.
Aufschlussreich sind auch die Titel. Ein Programmpunkt heißt „Deploying at Scale: The True Cost of AI“ — die wahren Kosten. Ein anderer fragt „The Hard Part of AI: The Operating Model“, also nach dem schwierigen Teil. Ein Roundtable trägt den Titel „WTF is the context layer?“ und benutzt damit eine Abkürzung, die man nicht wählt, wenn die Sache geklärt ist. Ein weiterer heißt „Past the Demo“, jenseits der Demonstration.
Vier von vier dieser Titel setzen voraus, dass zwischen dem, was gezeigt wird, und dem, was läuft, eine Lücke klafft. Keiner verspricht eine Lösung. Alle benennen ein Problem.
Skalierung ist derzeit eine Sache der Großen
Halten wir das Programm gegen eine unabhängige Erhebung. Die Unternehmensberatung McKinsey hat am 25. August 2026 ihre jährliche Befragung zum Stand der KI veröffentlicht, drei Wochen vor der Konferenz.
Der zentrale Wert: 40 Prozent der befragten Großunternehmen mit mehr als einer Milliarde US-Dollar Jahresumsatz berichten, dass sie KI-Agenten skalieren. Im Vorjahr waren es 27 Prozent. Bei kleineren Organisationen liegt derselbe Wert unverändert bei 22 Prozent.
Diese Spreizung ist der eigentliche Befund. Der Fortschritt eines Jahres — dreizehn Prozentpunkte — ist fast vollständig bei den Großen angefallen, während der Rest auf der Stelle tritt. Wer daraus liest, KI-Agenten seien im Unternehmensalltag angekommen, liest nur die obere Hälfte.
Es handelt sich um eine Befragung, also um Selbstauskünfte. Was ein Unternehmen unter „skalieren“ versteht, definiert es selbst, und niemand prüft nach. Der Wert taugt für die Richtung, nicht für die absolute Höhe.
Zwei weitere Zahlen aus derselben Erhebung ordnen das Bild. 20 Prozent der Befragten geben an, dass die laufenden KI-Betriebskosten einschließlich der Kosten für verarbeitete Token ihren Einsatz begrenzt haben. Und 37 Prozent berichten einen Beitrag der KI zum operativen Ergebnis — gegenüber dem Vorjahr praktisch unverändert. Mehr Unternehmen skalieren also, ohne dass sich am gemeldeten Ergebnisbeitrag etwas bewegt.
Dazu passt eine Prognose von Gartner vom 25. Juni 2025: Mehr als 40 Prozent der agentischen KI-Projekte würden bis Ende 2027 abgebrochen, wegen steigender Kosten, unklaren Geschäftswerts oder unzureichender Risikokontrolle. Gartner schätzt zugleich, dass von mehreren Tausend Anbietern, die sich agentisch nennen, nur rund 130 tatsächlich agentische Fähigkeiten liefern. Das ist eine Prognose eines kommerziellen Analystenhauses, keine Messung, und ihr Horizont liegt noch vor uns. Woran sich das künftig bemessen lässt, haben wir gesondert beschrieben: woran sich Betriebsreife messen lassen muss.
Was Agenten wirklich schaffen: 30,3 Prozent
Erhebungen fragen Menschen, was sie glauben. Es gibt auch Arbeiten, die nachmessen.
Eine Gruppe der Carnegie Mellon University hat dafür eine vollständige Firma nachgebaut: eigene Chat-Plattform, eigene Dateiablage, eigenes Projektwerkzeug, simulierte Kolleginnen und Kollegen. Darin mussten Agenten 175 Aufgaben erledigen, wie sie in Softwareentwicklung, Projektsteuerung, Datenanalyse, Verwaltung, Personal und Finanzen anfallen. Die Arbeit erschien 2025 auf der NeurIPS-Konferenz, ist also begutachtet.
Das beste getestete System erledigte 30,3 Prozent der Aufgaben eigenständig bis zum Abschluss. Nach einer zweiten Bewertung, die Teilerfolge anrechnet, kommt es auf 39,3 Prozent. Die nächstbesten Systeme liegen bei 26,3 und 24,0 Prozent, offene Modelle deutlich darunter.
Bemerkenswert ist, wo die Agenten scheitern. Am schlechtesten schneiden sie dort ab, wo eine Büro-Oberfläche zu bedienen ist, und dort, wo sie mit simulierten Menschen sprechen müssen — also ausgerechnet bei den zwei Dingen, die Büroarbeit ausmachen. Was gut läuft, sind abgegrenzte technische Aufgaben in einem Werkzeug.
Diese Zahlen stammen aus einer nachgebauten Firma, nicht aus einem echten Betrieb. Sie lassen sich nicht eins zu eins übertragen. Als Größenordnung sind sie trotzdem unbequem: Wenn ein System sieben von zehn realistischen Aufgaben nicht allein zu Ende bringt, ist die Frage nicht, ob ein Mensch nachsieht, sondern wie der Betrieb organisiert wird, in dem er es tut.
Demonstration ist nicht Betrieb. Eine Vorführung wählt die Aufgabe, den Datenstand und den Zeitpunkt. Ein Betrieb bekommt alle drei vorgegeben. Der Unterschied ist kein gradueller — er entscheidet darüber, ob Fehler ärgerlich oder teuer sind.
Die Rechnung, die niemand gern aufmacht
Dieselbe Arbeit misst mit, was jeder Versuch kostet. Gerechnet werden die Kosten der Modellabfragen: eingehende Token mal Preis, ausgehende Token mal Preis, ohne Zwischenspeicherung.
Für das beste System kommen dabei 4,20 US-Dollar je Aufgabenversuch heraus, bei durchschnittlich 27,2 Arbeitsschritten. Ein günstigeres Modell schafft denselben Versuch für 0,60 US-Dollar — löst dafür aber nur 11,4 Prozent der Aufgaben. Und ein älteres, teureres System verbrennt 6,80 US-Dollar je Versuch bei 3,4 Prozent Erfolg.
Der Preis je Versuch ist allerdings die falsche Kennzahl, und genau hier wird es für die Planung interessant. Bezahlt werden alle Versuche, gescheiterte eingeschlossen. Wer wissen will, was eine erledigte Aufgabe kostet, muss die Erfolgsquote hineinrechnen: 4,20 US-Dollar geteilt durch 0,303 ergibt rund 13,90 US-Dollar je tatsächlich abgeschlossener Aufgabe. Diese Rechnung steht so nicht in der Studie, sie folgt aber zwingend aus deren beiden Zahlen.
Und sie ist immer noch zu günstig. Nicht enthalten sind die Infrastruktur, die Aufsicht durch Menschen, die Nacharbeit an fehlerhaften Ergebnissen und die Kosten der Fälle, in denen ein falsches Ergebnis unbemerkt weiterläuft. Die Modellpreise selbst haben sich seit dem Messzeitpunkt verändert.
Dass Modellabfragen dramatisch billiger geworden sind, steht dem nicht entgegen. Das Forschungsinstitut Epoch AI hat für ein festes Leistungsniveau nachgerechnet: Um die Qualität von GPT-3 auf einem verbreiteten Prüfsatz zu erreichen, kostete eine Million Token im November 2021 noch 60 US-Dollar, im Oktober 2024 nur noch 0,07 US-Dollar. Das Stanford-Institut für menschenzentrierte KI beziffert den Rückgang für ein GPT-3.5-Niveau auf mehr als das 280-Fache zwischen November 2022 und Oktober 2024.
Nur misst diese Zahl etwas anderes als die eigene Rechnung. Sie hält das Leistungsniveau fest und fragt, was es heute kostet. Unternehmen halten aber nicht das Niveau fest, sie nehmen das jeweils beste Modell — und zahlen dessen aktuellen Preis. Beide Aussagen stimmen gleichzeitig: Ein eingefrorenes Niveau wird rapide billiger, und der laufende Betrieb wird trotzdem nicht günstig.
Das Nadelöhr heißt Kontext, nicht Modell
Der Roundtable mit der ungehaltenen Frage nach dem Context Layer trifft einen wunden Punkt, und die Forschung stützt ihn deutlicher, als es die Formulierung vermuten lässt.
Eine Arbeit, die 2025 auf der ICLR-Konferenz erschien, hat untersucht, wie gut gängige Datensätze für Systeme sind, die vor der Antwort Dokumente heranziehen. Ergebnis: In 55,4 Prozent der Fälle reichte der bereitgestellte Kontext gar nicht aus, um die Frage zu beantworten. Mehr als die Hälfte der Aufgaben war also von vornherein unlösbar, ohne dass das System es anzeigte.
Schwerwiegender ist der zweite Befund derselben Arbeit. Bekommt ein Modell Kontext beigegeben, antwortet es häufiger, statt sich zu enthalten — auch dann, wenn der Kontext die Antwort nicht hergibt. Bei einem geprüften Modell fiel die Enthaltungsquote von 84,1 auf 52 Prozent, bei einem anderen von 100 auf 18,6 Prozent. Zusätzlicher Kontext erzeugt also Zuversicht, nicht nur Wissen.
Dazu kommt, dass mehr Kontext nicht besser ist. Eine vielzitierte Arbeit aus Stanford und Berkeley hat gezeigt, dass die Position im Kontextfenster über den Erfolg mitentscheidet: Steht das entscheidende Dokument in der Mitte eines längeren Kontexts, fällt die Trefferquote unter den Wert, den dasselbe Modell ganz ohne Kontext erreicht. Und eine Untersuchung von NVIDIA fand, dass von 17 Modellen, die alle 32.000 Token Kontext oder mehr beanspruchen, nur etwa die Hälfte diese Länge auch nutzbar füllt.
Alle drei Arbeiten prüfen an konstruierten Aufgaben, nicht an Unternehmensdaten, und ihr Modellstand liegt zwischen 2023 und 2025. Die Richtung ist trotzdem klar, und sie hat eine praktische Folge: Der Engpass sitzt selten im Modell. Er sitzt in der Frage, welche Information ein System zum richtigen Zeitpunkt sieht — und ob es merkt, wenn sie fehlt.
Dass diese Schicht zunehmend als eigenständige Aufgabe verstanden wird, zeigt sich auch außerhalb der Konferenz. Das US-Normungsinstitut NIST führt in seinem Rahmenwerk für generative KI die Anreicherung mit abgerufenen Dokumenten ausdrücklich als etwas, das gegen Sicherheits- und Fabulierungsrisiken zu bewerten ist — also als Schutz und als eigene Fehlerquelle zugleich. Das Bundesamt für Sicherheit in der Informationstechnik führt sie parallel als Gegenmaßnahme und als eigenes Risiko, weil manipulierte Inhalte in der Wissensbasis gezielte Falschausgaben auslösen können.
Physical AI: derselbe Sprung, teurer bezahlt
Mit dem Physical AI Pavilion und Programmpunkten wie „Physical AI Meets Real-World Autonomy“ und „The Race to Build Real-World Intelligence“ hat die Konferenz einen eigenen Schwerpunkt für Systeme, die nicht nur rechnen, sondern sich bewegen.
Für diese Systeme gilt alles bisher Gesagte, nur mit anderen Folgen. Ein Agent, der eine Rechnung falsch zuordnet, erzeugt Nacharbeit. Ein Fahrzeug, das eine Situation falsch einschätzt, erzeugt einen Unfall. Die Fehlerquote ist dieselbe Größe, ihr Preis ist es nicht.
Deshalb ist der Nachweis hier anders organisiert. Für automatisierte Fahrzeuge arbeitet bei der Wirtschaftskommission für Europa der Vereinten Nationen eine eigene Arbeitsgruppe an internationalen Regelungen. Zulassung heißt dort nicht, dass ein System in einer Vorführung überzeugt, sondern dass es gegen festgelegte Anforderungen geprüft wurde. Eine gefahrene Strecke ohne Zwischenfall ist kein Beleg, solange nicht feststeht, welche Situationen darin überhaupt vorkamen.
Genau das verbindet den Roboter mit dem Büroagenten. In beiden Fällen ist die interessante Frage nicht, wie oft das System richtig liegt, sondern was passiert, wenn es falsch liegt — und ob jemand es rechtzeitig merkt. Bei der Software entscheidet darüber die Protokollierung, beim Fahrzeug die Zulassungsprüfung. Die zugrunde liegende Logik ist dieselbe.
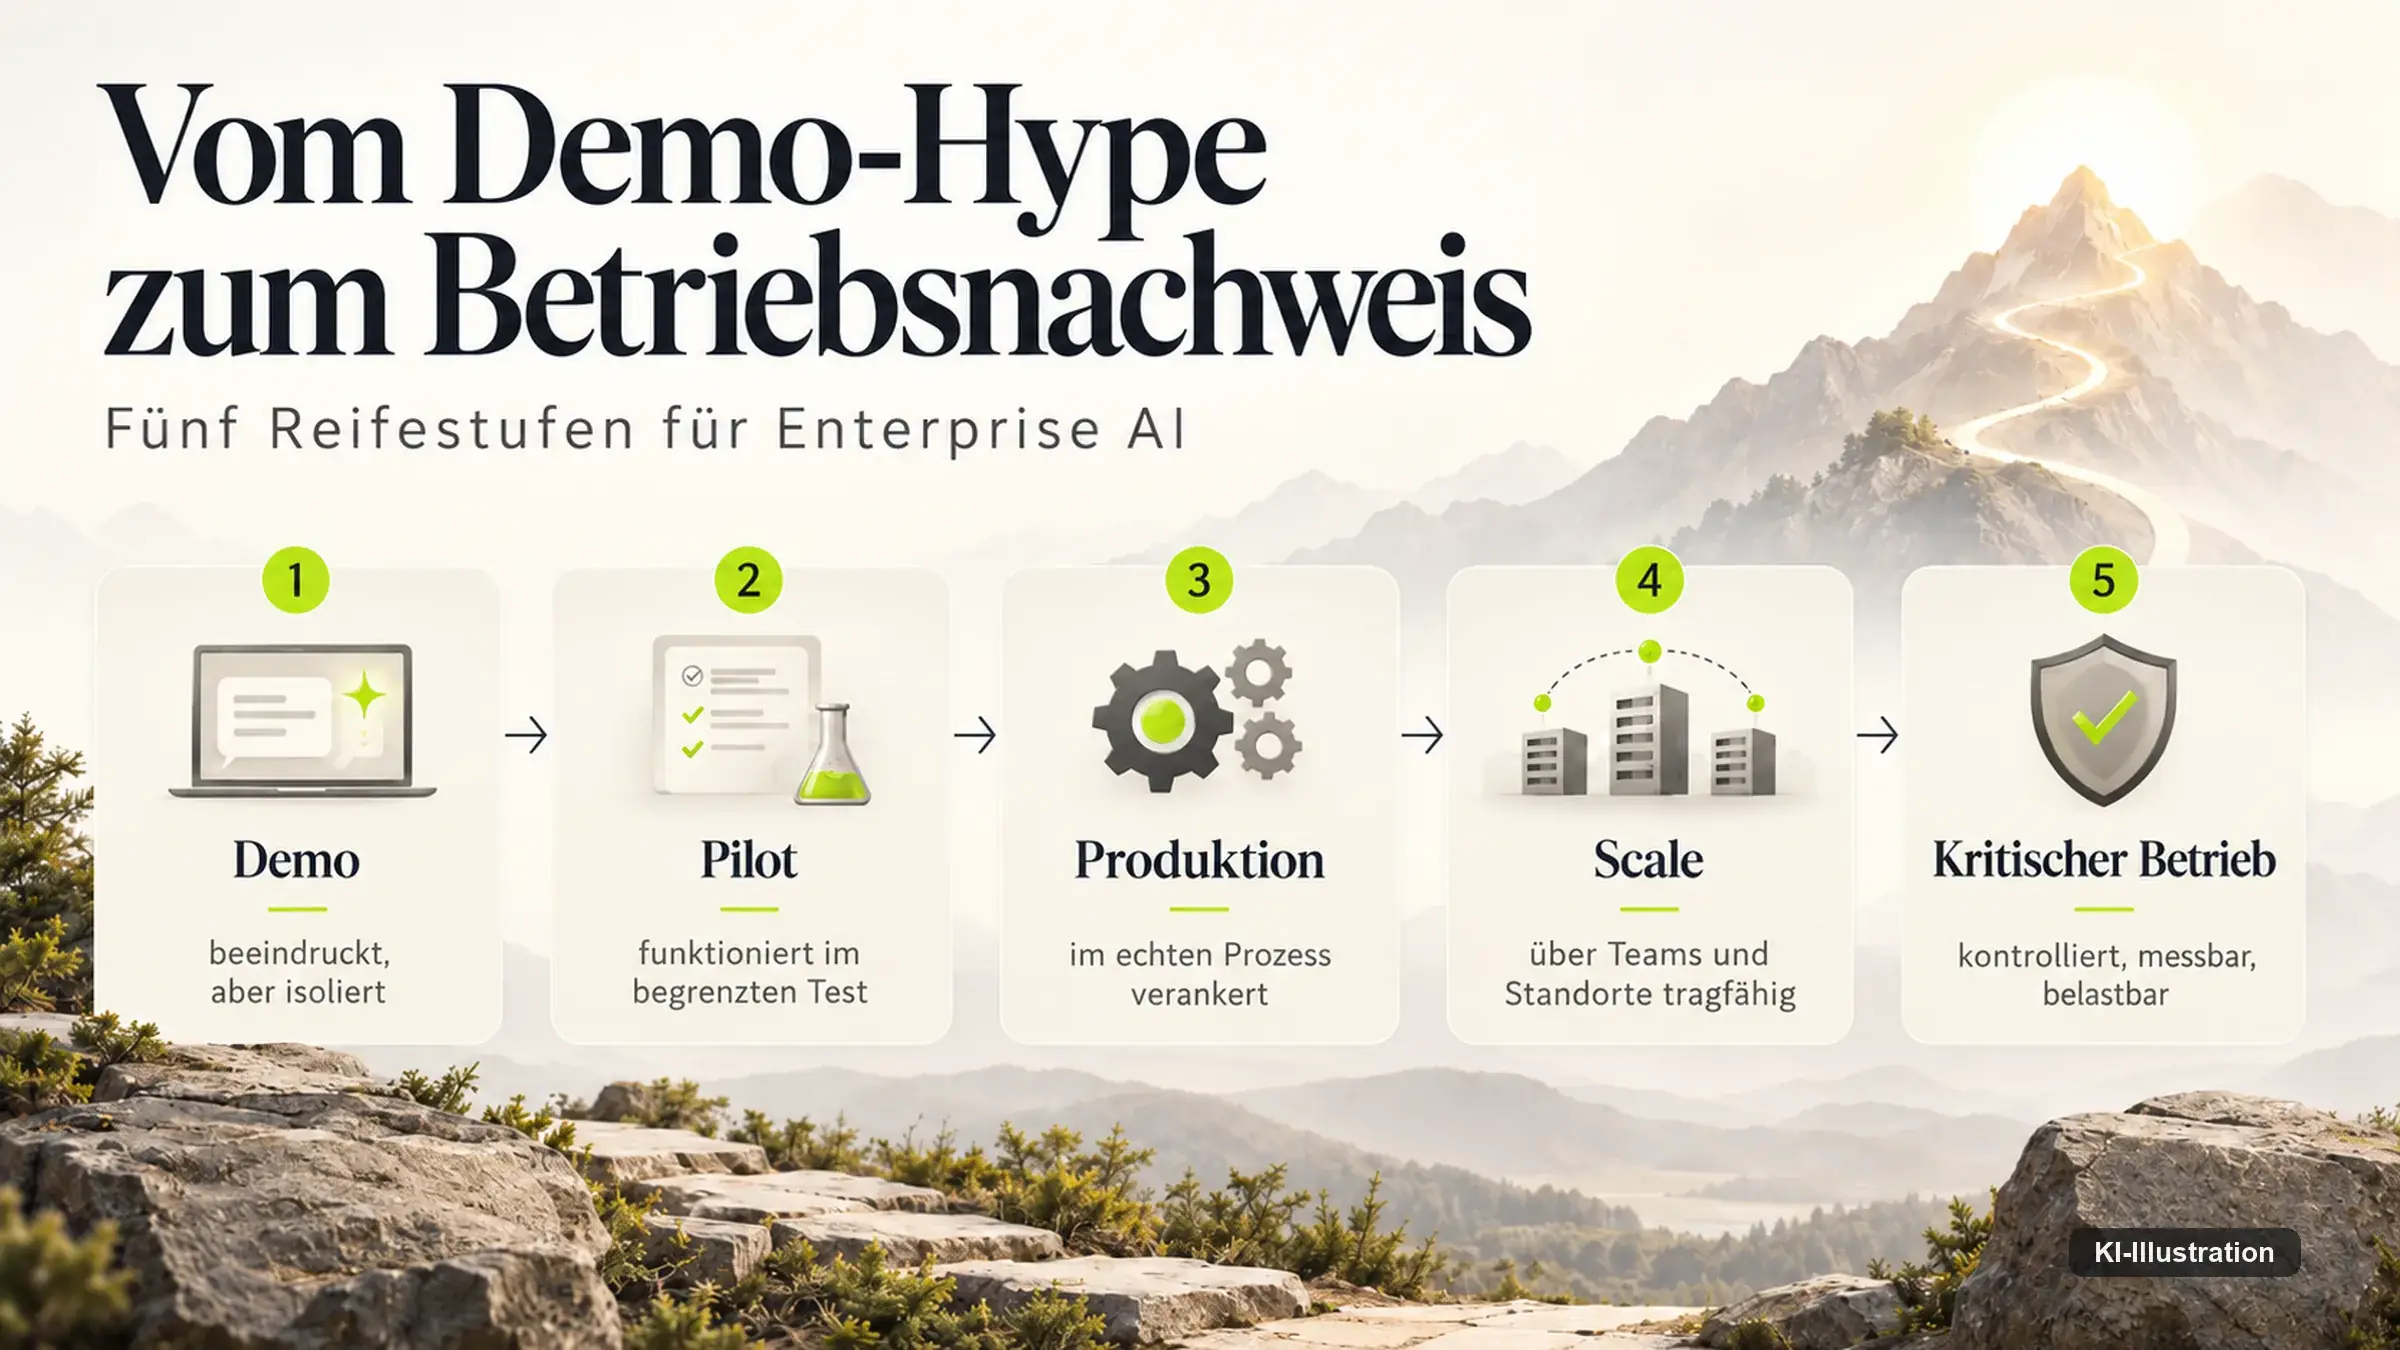
Woran Sie Betriebsreife erkennen
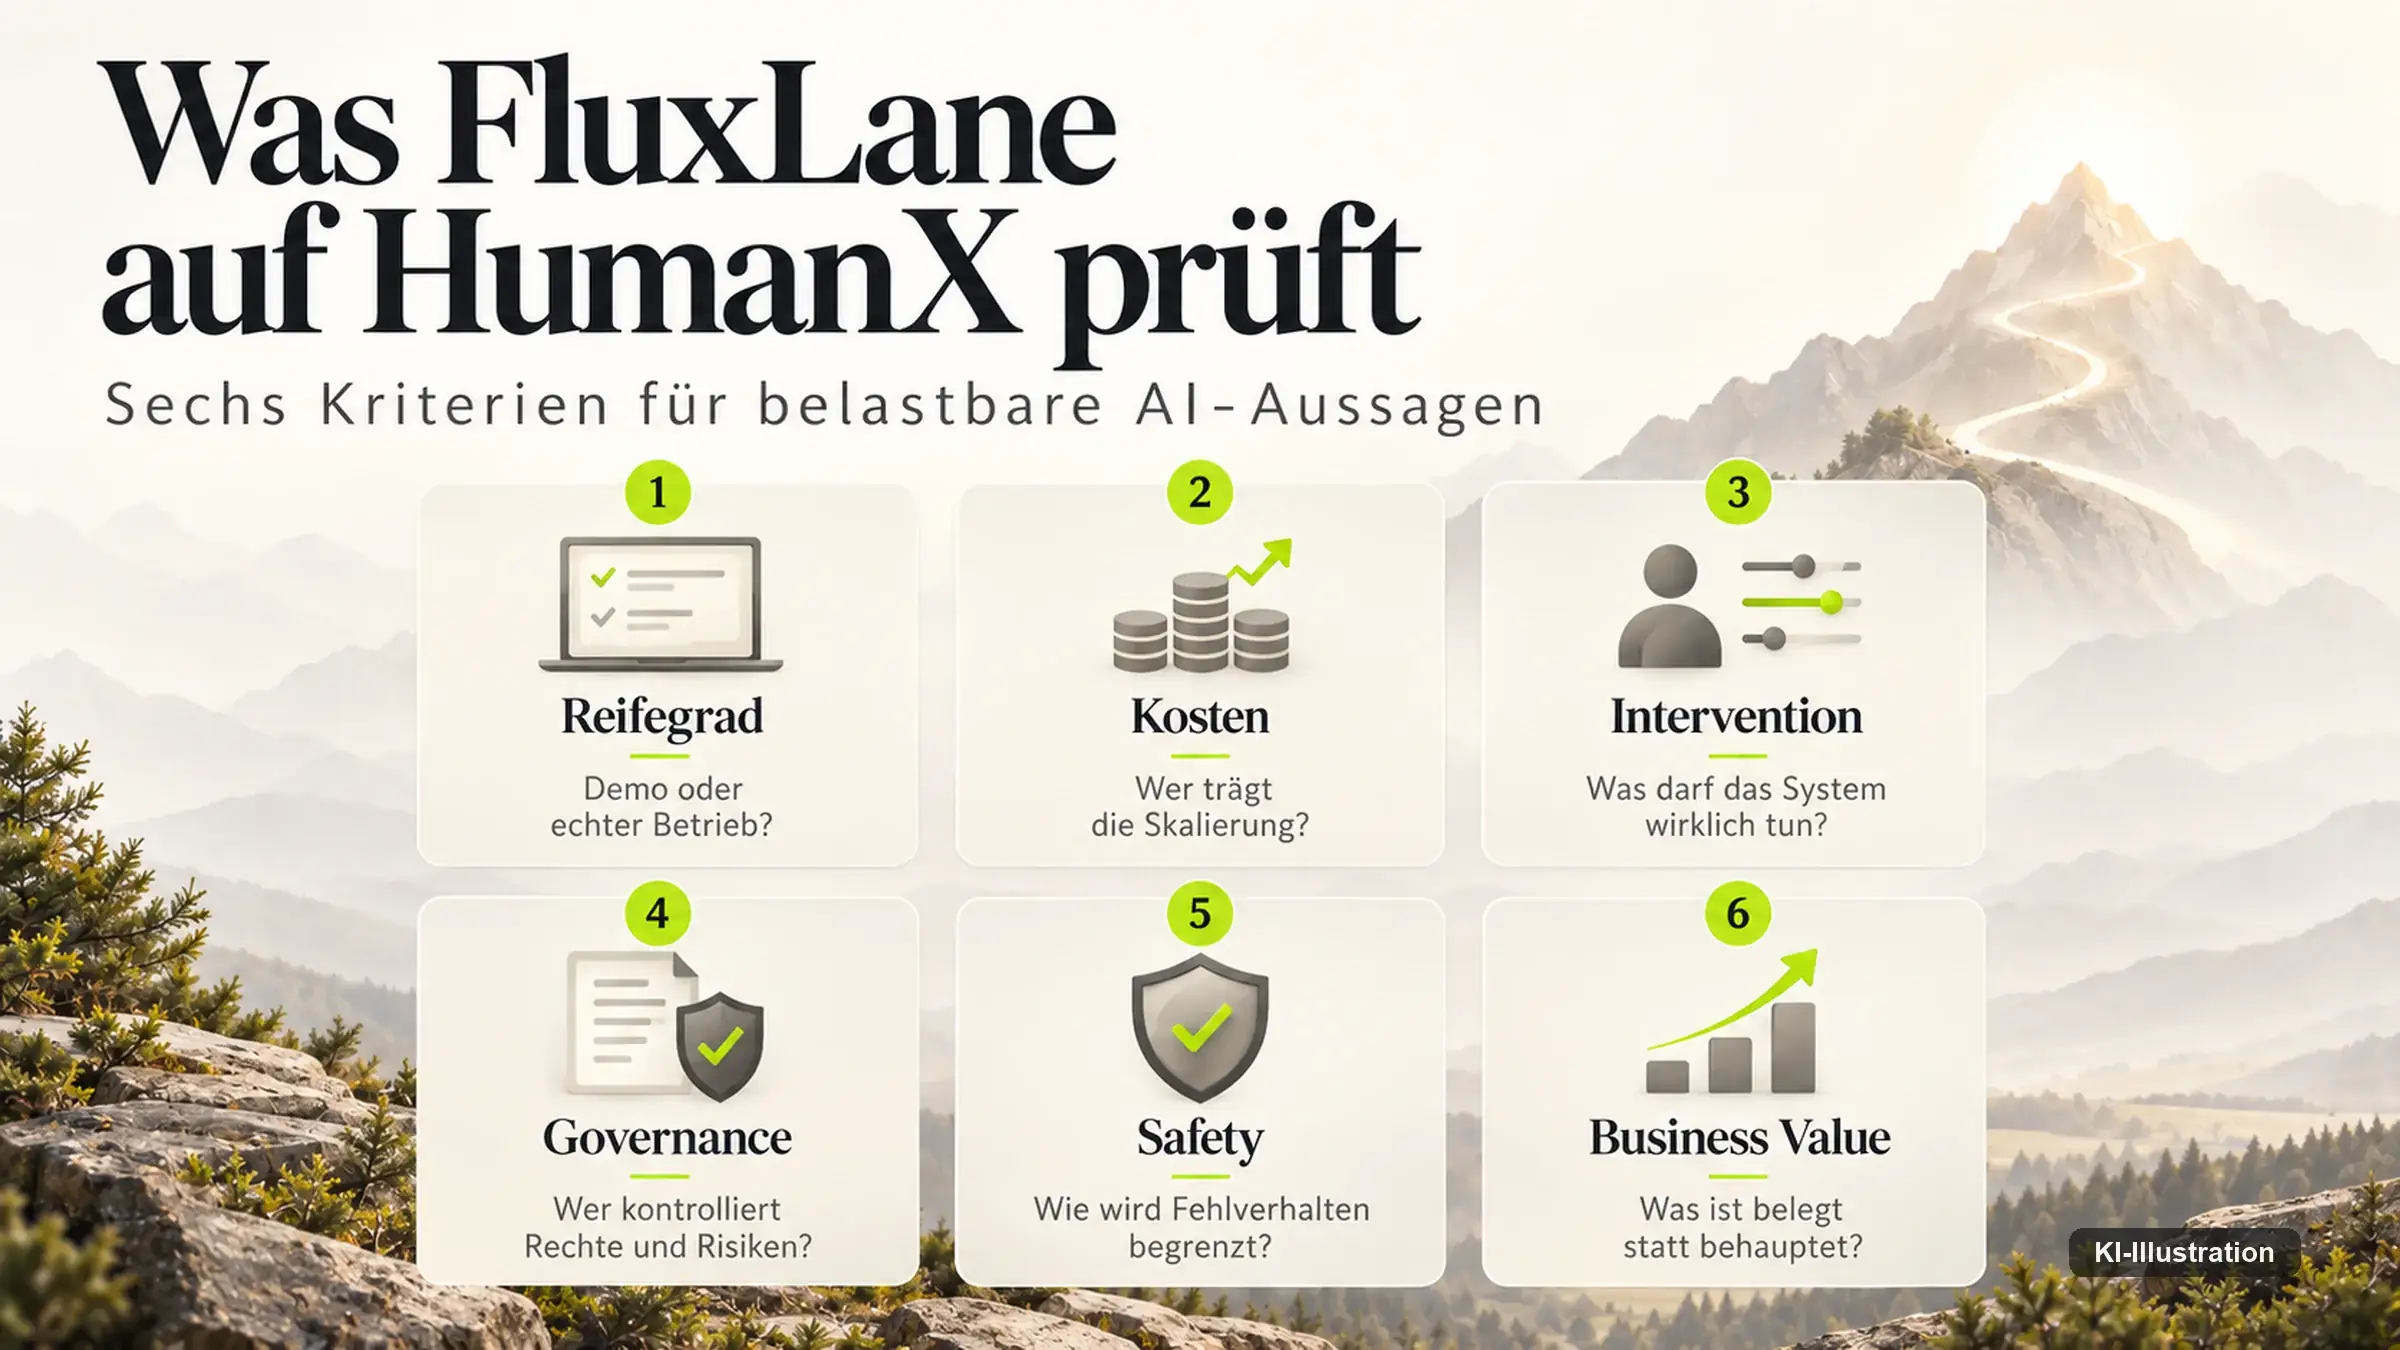
Aus den genannten Arbeiten lässt sich ein Raster ableiten, das sich auf jedes angebotene System anwenden lässt — auch auf eines, das Ihnen in Amsterdam vorgeführt wird. Die mittlere Spalte nennt, was ein Anbieter typischerweise zeigt, die rechte, was den Betrieb entscheidet.
| Prüffeld | Was in der Demonstration zu sehen ist | Was den Betrieb entscheidet |
|---|---|---|
| Erfolgsquote | gelungene Durchläufe an ausgewählten Beispielen | Quote über alle Vorgänge eines Zeitraums, gescheiterte eingeschlossen |
| Wiederholbarkeit | ein Durchlauf | derselbe Vorgang mehrfach mit gleichem Ergebnis |
| Kosten | Preis je Modellabfrage | Kosten je erledigtem Vorgang, Fehlversuche eingerechnet |
| Kontext | Antwort auf eine gestellte Frage | Verhalten, wenn die nötige Information fehlt — Antwort oder Enthaltung |
| Rechte | Zugriff auf alles, was die Vorführung braucht | engster nötiger Zugriff, getrennte Identität, Bestätigung vor kritischen Schritten |
| Nachvollziehbarkeit | Ergebnis | vollständiger Ablauf: welche Quelle, welcher Schritt, welche Entscheidung |
| Eskalation | nicht vorgesehen | festgelegter Weg zum Menschen, mit Zuständigkeit und Frist |
| Datenstand | vorbereiteter Ausschnitt | laufender Bestand, mit Lücken, Widersprüchen und Altlasten |
Das Raster ist bewusst nicht nach Anbietern sortiert. Es prüft nicht, wer besser ist, sondern ob eine Aussage überhaupt eine Aussage über den Betrieb ist. Ein Anbieter, der für die rechte Spalte belastbare Angaben liefert, ist weiter als einer mit der eindrucksvolleren Vorführung — unabhängig davon, welches Modell darunter läuft.
Die praktischste Einzelfrage steht in der dritten Zeile. Fragen Sie nach den Kosten je erledigtem Vorgang, nicht je Abfrage. Wer die Erfolgsquote nicht nennen kann, kann die Kosten nicht kennen — und wer sie nennt, hat sie gemessen.
Was diese drei Tage beantworten können
Für die Einordnung des Programms hilft ein Blick auf die europäische Ausgangslage. Nach Eurostat setzten 2025 rund 20 Prozent der Unternehmen in der EU KI-Technologien ein, nach gut 13 Prozent im Jahr davor. Die Spreizung ist erheblich: von rund 42 Prozent in Dänemark bis gut 5 Prozent in Rumänien, und von 17 Prozent bei kleinen Unternehmen bis 55 Prozent bei großen.
Auffällig ist, was Unternehmen als Hinderungsgrund angeben, wenn sie KI erwogen und verworfen haben. Ganz oben stehen fehlendes Fachwissen, Unklarheit über die Rechtsfolgen und Datenschutzbedenken. Kosten führt die Statistik in dieser Aufstellung nicht als Grund. Wer also glaubt, der Engpass sei der Preis, liegt nach dieser Erhebung falsch — es fehlt vor allem an Leuten, die es können, und an Klarheit darüber, was erlaubt ist.
Damit lässt sich einigermaßen genau sagen, was diese drei Tage leisten können. Sie werden zeigen, was technisch geht, und sie werden in den Roundtables einiges darüber hervorbringen, was in echten Häusern schiefgeht — das ist der Wert eines Formats ohne Aufzeichnung. Was sie nicht leisten können, ist der Nachweis, dass ein System im Dauerbetrieb trägt. Diesen Nachweis erbringt niemand auf einer Bühne, weil er Zeit braucht und Zahlen aus dem eigenen Haus.
Für die Bewertung des Gehörten heißt das: Das Interessante ist selten die vorgeführte Fähigkeit. Interessant ist, ob jemand eine Quote über einen längeren Zeitraum nennt, ob er sagt, was passiert, wenn es schiefgeht, und ob er die Kosten auf erledigte Vorgänge bezieht. Diese drei Angaben trennen zuverlässiger zwischen Betrieb und Erprobung als jede Produktbeschreibung.
Wir verfolgen die Veranstaltung und arbeiten die Themen einzeln auf — Agentenarchitektur, Kosten, Souveränität, Physical AI und die Datenschicht. Sobald Belege aus dem Betrieb vorliegen und nicht nur Aussagen über ihn, tragen wir sie nach.
Quellen. Alle Adressen wurden am 13. September 2026 geprüft. Wo eine Seite automatisierte Abrufe abweist, wurde sie im Browser geöffnet und der Inhalt gegen die Nennung abgeglichen.
- HumanX Europe 2026, Programm und Sessionseiten: Agenda 2026 sowie Roundtable „Beyond the Pilot“ und „Past the Demo“.
- Xu et al., TheAgentCompany: Benchmarking LLM Agents on Consequential Real World Tasks, Carnegie Mellon University und Duke University, NeurIPS 2025; Tabelle 1 mit Erfolgsquoten und Kosten je Versuch.
- Joren et al., Sufficient Context: A New Lens on Retrieval Augmented Generation Systems, ICLR 2025.
- Liu et al., Lost in the Middle: How Language Models Use Long Contexts, Stanford University und UC Berkeley, TACL.
- Hsieh et al., RULER: What’s the Real Context Size of Your Long-Context Language Models?, NVIDIA.
- NIST, AI 600-1: Generative Artificial Intelligence Profile, Juli 2024.
- Bundesamt für Sicherheit in der Informationstechnik, KI-Agenten.
- Eurostat, Use of artificial intelligence in enterprises, Datenstand Dezember 2025.
- Epoch AI, LLM inference price trends, 12. März 2025; Stanford Institute for Human-Centered AI, AI Index Report 2025.
- McKinsey & Company, The state of AI in 2026, 25. August 2026.
- Gartner, Over 40% of Agentic AI Projects Will Be Canceled by End of 2027, 25. Juni 2025.
- UNECE, Working Party on Automated/Autonomous and Connected Vehicles.
Die Angaben zur Rechtslage sind eine redaktionelle Einordnung und keine Rechtsberatung.
Wann und wo findet die HumanX Europe 2026 statt?
Vom 22. bis 24. September 2026 im RAI Amsterdam. Das Programm gliedert sich in fünf Themenstränge und umfasst zum Stand 13. September 2026 insgesamt 173 Punkte, darunter 95 Vorträge und 20 Roundtables.
Stützt sich dieser Beitrag auf Aussagen von der Konferenz?
Nein. Der Beitrag entstand vor Beginn der Veranstaltung. Ausgewertet wurde das veröffentlichte Programm — Titel, Zeiten, Formate und Beteiligte. Aussagen von der Bühne sind darin nicht enthalten und werden nachgetragen, sobald sie belegbar sind.
Wie viele Unternehmen skalieren KI-Agenten tatsächlich?
Nach der McKinsey-Befragung vom 25. August 2026 berichten 40 Prozent der Großunternehmen mit über einer Milliarde US-Dollar Umsatz, dass sie Agenten skalieren, nach 27 Prozent im Vorjahr. Bei kleineren Organisationen liegt der Wert unverändert bei 22 Prozent. Es handelt sich um Selbstauskünfte, nicht um geprüfte Werte.
Wie zuverlässig arbeiten KI-Agenten heute bei Büroaufgaben?
In einer begutachteten Untersuchung der Carnegie Mellon University mit 175 realitätsnahen Aufgaben erledigte das beste System 30,3 Prozent eigenständig, mit Teilpunkten 39,3 Prozent. Am schwersten fielen die Bedienung von Büro-Oberflächen und Gespräche mit Kollegen. Die Werte stammen aus einer nachgebauten Firma, nicht aus dem Echtbetrieb.
Was kostet ein KI-Agent je Vorgang?
In derselben Untersuchung kostete ein Aufgabenversuch beim besten System 4,20 US-Dollar an Modellabfragen. Weil auch gescheiterte Versuche bezahlt werden, liegt der Preis je tatsächlich erledigter Aufgabe bei rund 13,90 US-Dollar — eine Rechnung aus den beiden Werten der Studie. Infrastruktur, Aufsicht und Nacharbeit sind darin nicht enthalten.
Warum scheitern KI-Projekte am Kontext statt am Modell?
Eine Arbeit der ICLR 2025 fand, dass in 55,4 Prozent der geprüften Fälle der bereitgestellte Kontext die Frage gar nicht beantwortete. Zugleich sinkt mit beigegebenem Kontext die Bereitschaft der Modelle, sich zu enthalten — bei einem geprüften Modell von 84,1 auf 52 Prozent. Mehr Kontext erzeugt also Zuversicht, nicht nur Wissen.
Woran erkenne ich, ob ein vorgeführtes System betriebsreif ist?
An drei Angaben: einer Erfolgsquote über einen längeren Zeitraum statt einzelner Durchläufe, einem festgelegten Weg zum Menschen für den Fehlerfall, und Kosten, die sich auf erledigte Vorgänge beziehen statt auf einzelne Abfragen. Wer die Erfolgsquote nicht nennen kann, kennt die Kosten nicht.
Wie verbreitet ist KI in europäischen Unternehmen?
Nach Eurostat setzten 2025 rund 20 Prozent der EU-Unternehmen KI ein, nach gut 13 Prozent im Vorjahr. Die Spanne reicht von rund 42 Prozent in Dänemark bis gut 5 Prozent in Rumänien. Als Hinderungsgründe nennen Unternehmen vor allem fehlendes Fachwissen, unklare Rechtsfolgen und Datenschutzbedenken — Kosten führt die Statistik dort nicht auf.