Physical AI & Robotik-KI · Marktüberblick
Physical-AI-Datenmarkt: Wie aus Roboterdaten eine Handelsware wird
Kurz gesagt: Physical-AI-Daten sind eine eigene Handelsware geworden: Mecka, Lightwheel, Truelabel, Khenda, Robotic Data und Tacit Robotics verkaufen oder vermitteln Roboter- und Manipulationsdaten, während offene Corpora wie Open X-Embodiment, DROID und AgiBot World parallel wachsen. Einen einheitlichen Marktpreis pro Stunde gibt es dafür nicht, weil Aufgabe, Sensorik, Rechtelage und Exklusivität zu unterschiedlich sind. Wer vor einer Build-vs-Buy-Entscheidung steht, kauft deshalb besser eine genau definierte Datenlücke als eine Stundenzahl. Wer die Grundlagen sucht, findet was Physical AI technisch bedeutet in unserem Grundlagenartikel.
Warum die Frage nach dem Stundenpreis in die Irre führt
Was kostet eine Stunde Roboterdaten? Die Frage klingt nach einem vernünftigen Einstieg für jeden, der vor einer Build-vs-Buy-Entscheidung steht. Sie ist trotzdem falsch gestellt, denn sie unterstellt, „eine Stunde“ sei ein einheitliches Produkt.
Eine Stunde Video von einer Person, die in einer Küche Geschirr einräumt, ist wirtschaftlich nicht dasselbe wie eine Stunde teleoperierte Dual-Arm-Manipulation mit synchronisierten RGB-D-Kameras, Gelenkzuständen und Erfolgssignalen. Eine Stunde aus einer realen Automobilfabrik unterscheidet sich von einer Stunde Simulation, selbst wenn beide dieselbe Bewegung zeigen. Und eine Stunde mit sauberer Rechtekette ist ökonomisch etwas anderes als eine Stunde, bei der unklar bleibt, ob Beschäftigte oder Fabrikbetreiber die Nutzung für kommerzielles Modelltraining überhaupt erlaubt haben.
Selbst zwei technisch einwandfreie Stunden können unterschiedlich wertvoll sein. Die eine zeigt genau den Fehler, an dem ein Vision-Language-Action-Modell beim Zielkunden scheitert. Die andere enthält tausend Varianten eines Griffs, den das Modell längst beherrscht. Genau deshalb entsteht 2026 ein Markt, der noch keine gemeinsame Maßeinheit besitzt – der Physical-AI-Datenmarkt.
Unternehmen wie Mecka, Lightwheel, Truelabel, Khenda, Robotic Data und Tacit Robotics verkaufen oder vermitteln unterschiedliche Formen physischer Erfahrung, Roborecs bereitet einen Marktplatz dafür vor, während offene Datensätze wie Open X-Embodiment, DROID, AgiBot World, RoboMIND und EgoVerse parallel wachsen. Damit stellt sich für Physical AI eine ökonomische Frage, die ähnlich wichtig werden könnte wie Cloud Compute für Sprachmodelle: Welche Daten sollte ein Unternehmen selbst erzeugen, welche offen verwenden und welche zukaufen?
Vom Rohstoff zur Handelsware: wie der Markt entsteht
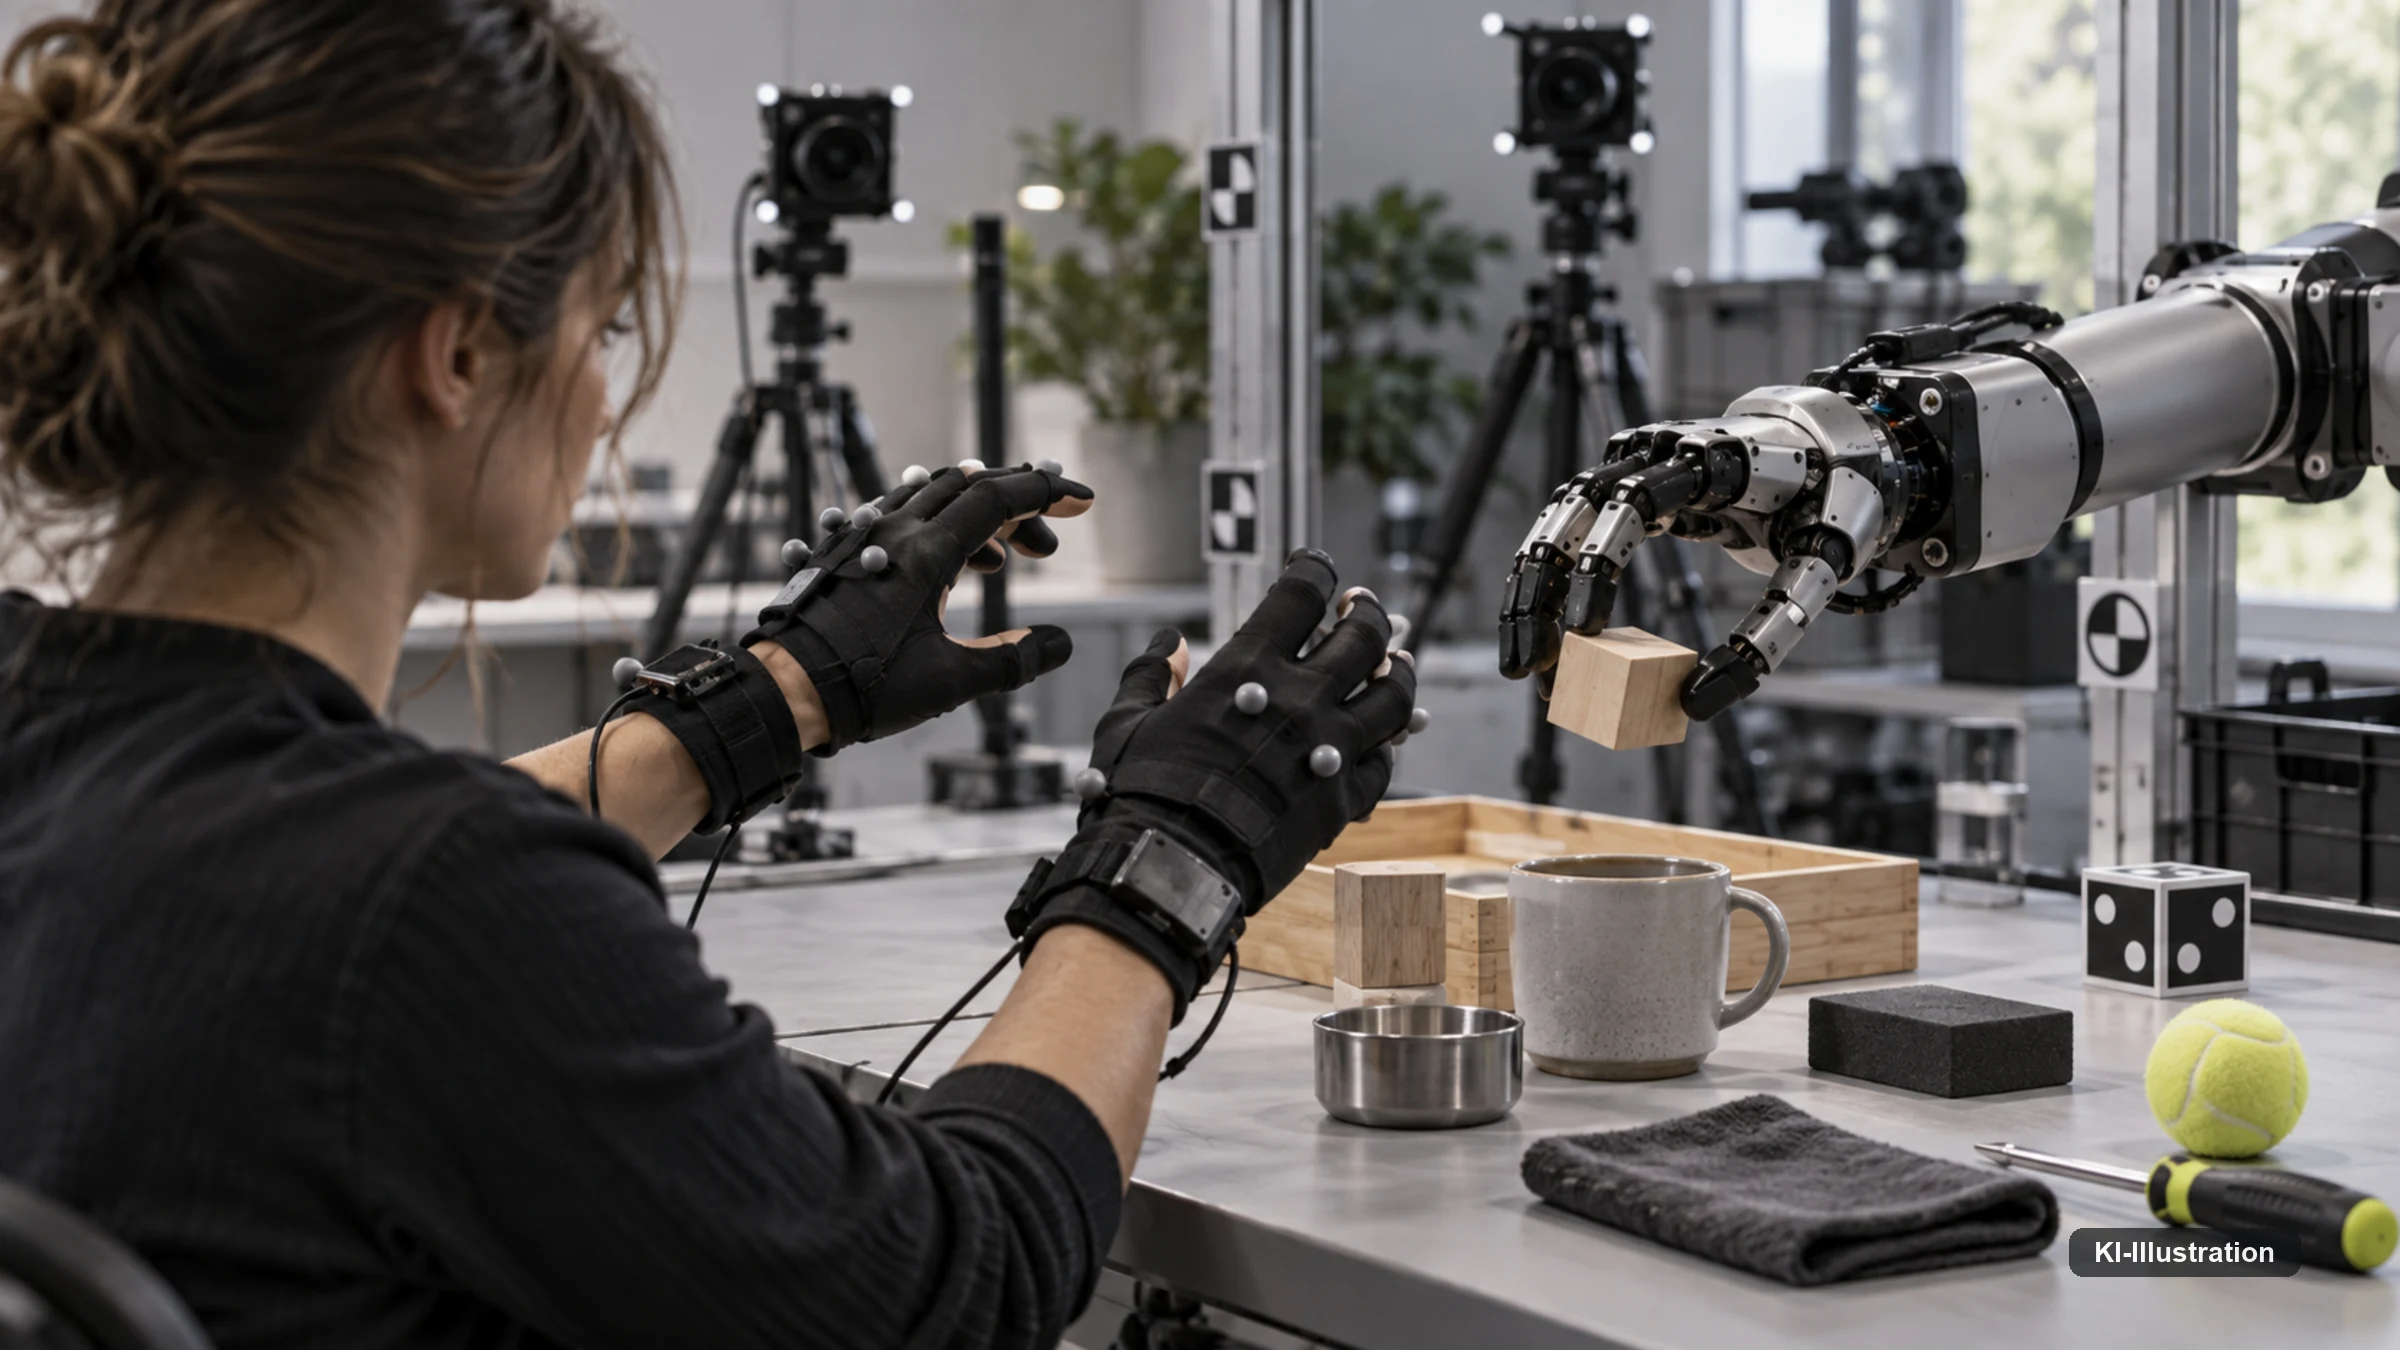
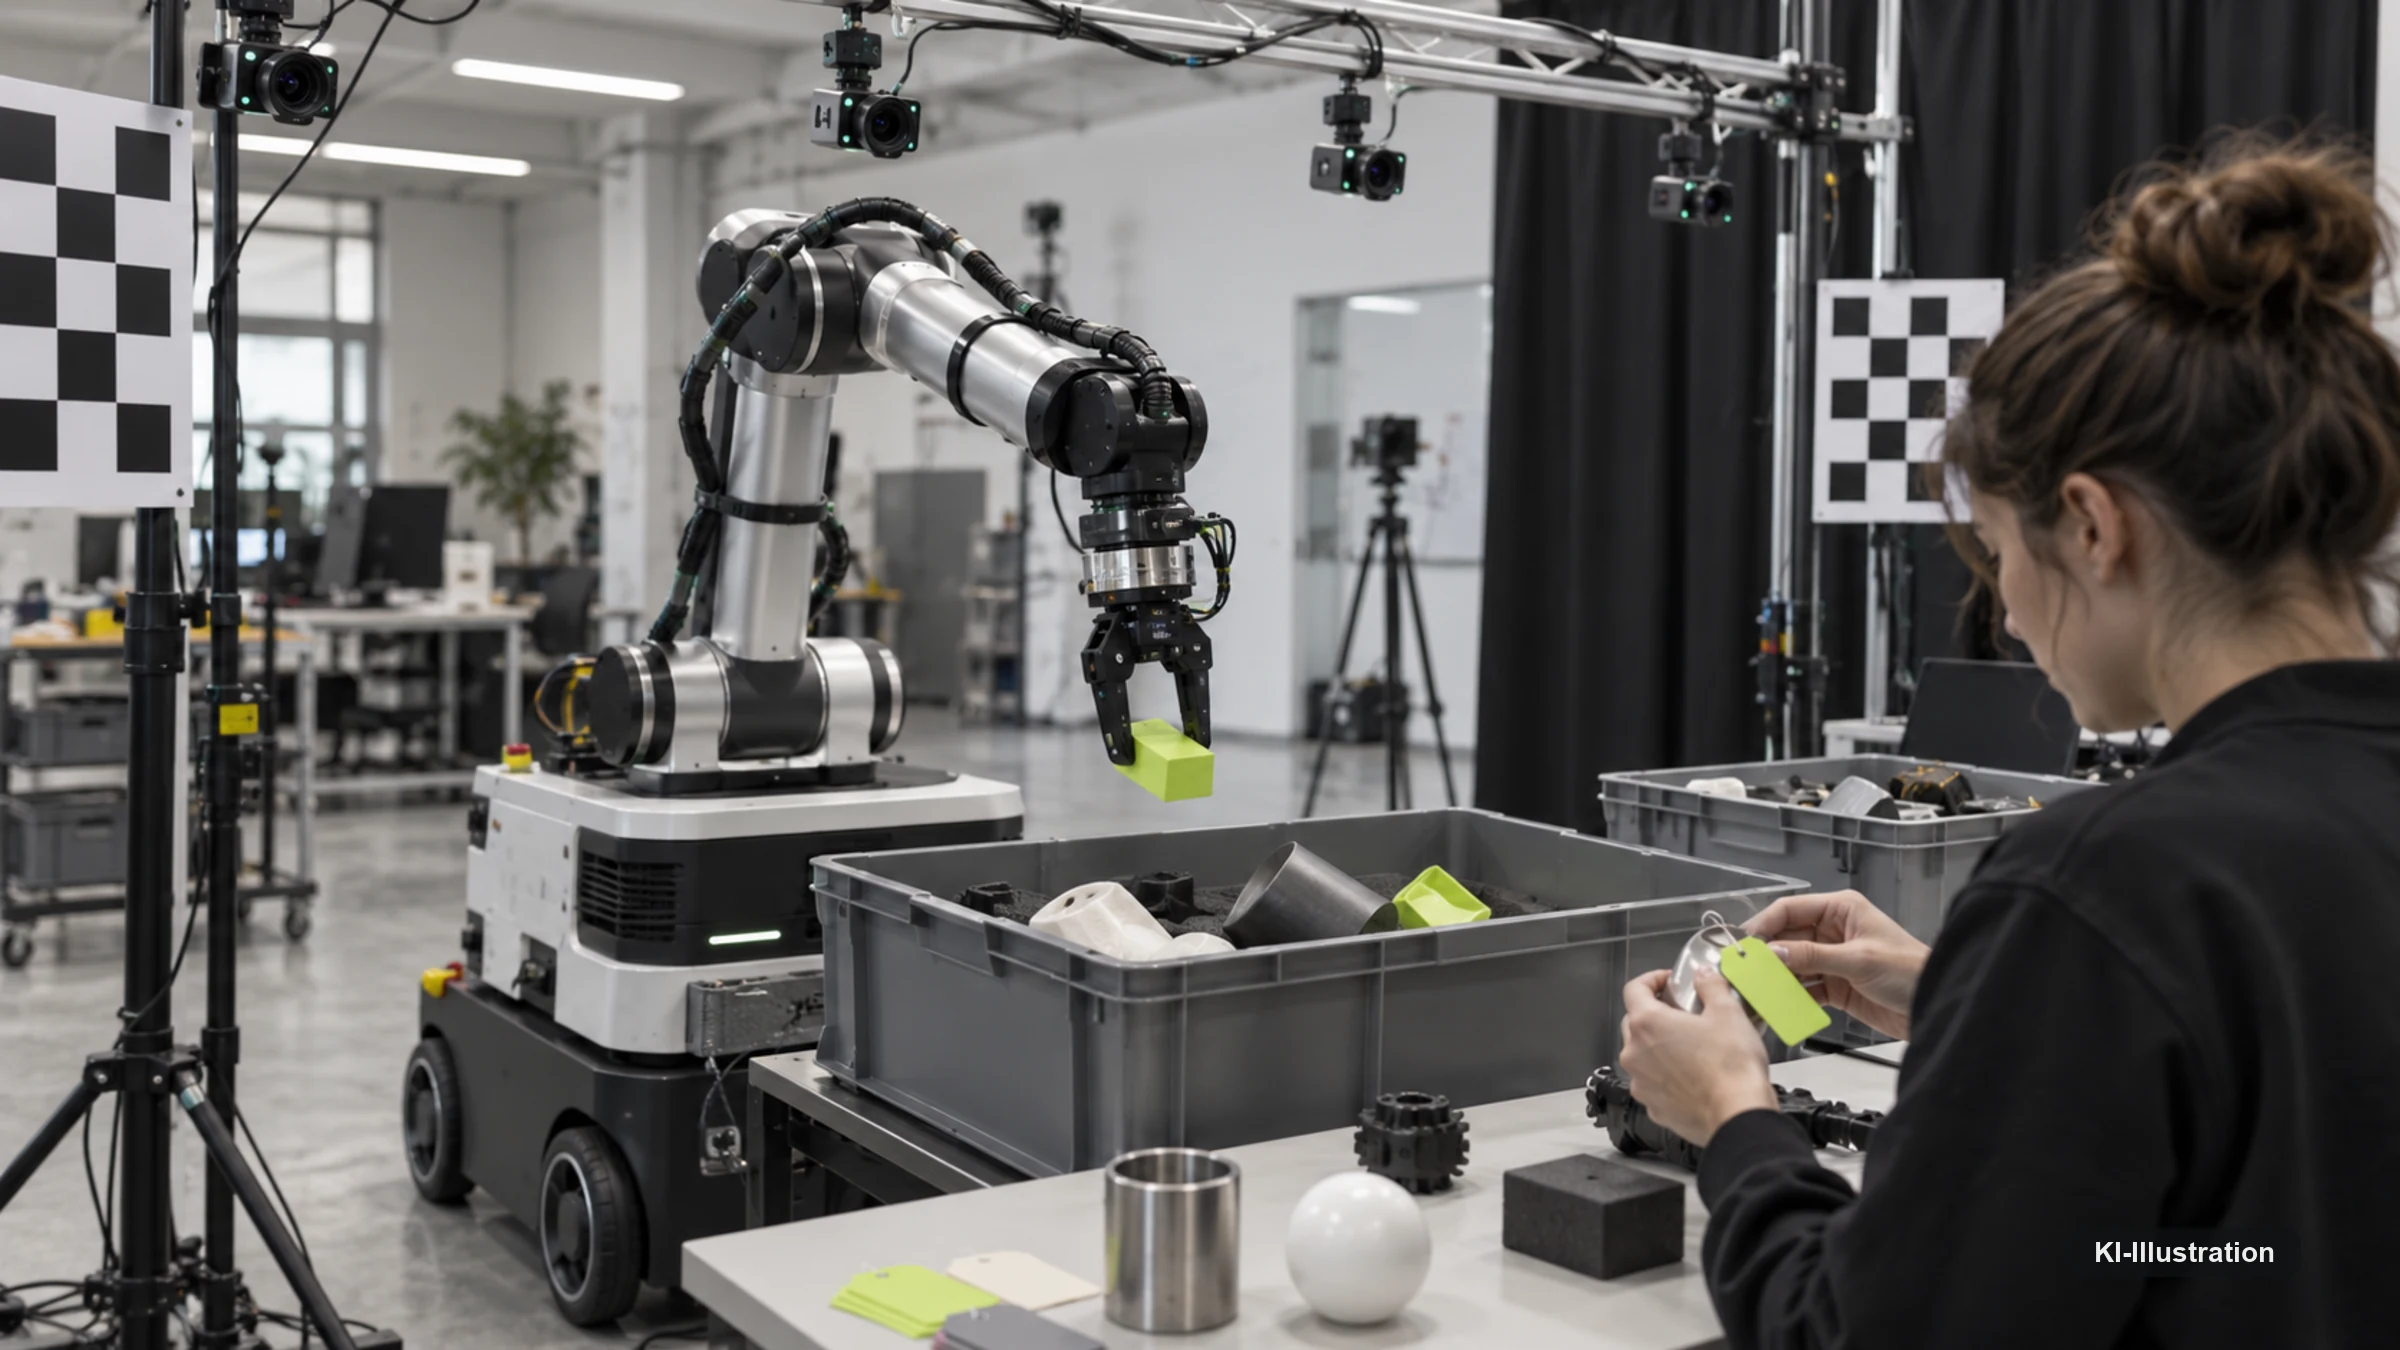
Eine frühere Analyse dieser Serie hat beschrieben, wie Robotikdaten industriell entstehen: in Trainingshallen mit Teleoperatoren, menschlichen Demonstrationen, Simulation und Annotation, verteilt über chinesische Zentren wie Wuxi, Peking, Shanghai und Shenzhen. Das war die Produktionsseite. Ein Markt beginnt aber erst dort, wo Daten zwischen Organisationen wechseln, denn dann stellen sich neue Fragen: Wird Eigentum verkauft oder nur eine Lizenz, ein maßgeschneiderter Capture-Auftrag oder ein bereits existierender Datensatz, nur Rohmaterial oder auch Annotation, Evaluation und Deployment-Unterstützung? 2026 laufen alle diese Modelle parallel.
Bevor man über kommerzielle Anbieter spricht, hilft der Blick darauf, womit sie konkurrieren: nicht mit null Daten, sondern mit immer größeren offenen Robotikcorpora. Open X-Embodiment hat Daten aus vielen Laboren und Roboterausführungen in einem gemeinsamen Zugriff zusammengeführt, mit dem ausdrücklichen Ziel, offene Robotikdaten einheitlich für nachgelagertes Lernen verfügbar zu machen. DROID sammelte 76.000 Demonstrationstrajektorien beziehungsweise rund 350 Stunden realer Manipulation in hunderten Szenen. Die Beta-Version von AgiBot World veröffentlichte mehr als eine Million Trajektorien, allerdings unter der Lizenz CC BY-NC-SA 4.0 – ein Punkt, der für kommerzielle Nutzer relevant ist. RoboMIND 2.0 bringt mehr als 310.000 reale Dual-Arm-Trajektorien über sechs Embodiments sowie taktile, mobile und simulierte Teilmengen.
EgoVerse verfolgt einen anderen Weg und nutzt menschliche egozentrische Manipulation als skalierbare Lernquelle. Die Veröffentlichung vom April 2026 nennt 1.362 Stunden, 80.000 Episoden, 1.965 Aufgaben, 240 Szenen und mehr als 2.000 Demonstrierende, während der laufende Explorer der Plattform inzwischen deutlich mehr umfasst. Generisches Pretraining-Material wird damit ständig billiger, ein Teil davon bleibt sogar kostenlos.
Warum ein Unternehmen trotz offener Daten noch kauft
Warum sollte dann jemand überhaupt für Roboterdaten bezahlen? Weil offen verfügbare Daten nicht automatisch zur eigenen Einsatzverteilung passen. Stellen Sie sich einen Hersteller vor, der einen Humanoiden für Kabelmontage in einem deutschen Maschinenbauwerk trainieren will: Offene Daten helfen bei allgemeinen Manipulationsrepräsentationen, visuomotorischem Pretraining, Objektverständnis und Grasp Priors. Sie liefern aber selten die passenden Schaltschrankgeometrien, die konkreten Steckverbinder, die reale Werksbeleuchtung, die Handschuhe der Beschäftigten oder die typischen Fehlerzustände unter Zeitdruck.
Ein Beispiel macht den Unterschied greifbar. Ein Modell, das ausschließlich mit offenen Küchendaten trainiert wurde, kann in einer Fabrikhalle an anderer Beleuchtung, anderen Werkzeugen und anderer Kinematik scheitern – nicht, weil ihm allgemeines Greifen fehlt, sondern weil die Verteilung der Trainingsdaten nicht zur Zielumgebung passt. Genau für diese Lücke sind Unternehmen bereit zu zahlen, nicht für zusätzliches Volumen an ohnehin vorhandenem Material.
Je größer offene Corpora werden, desto schwerer lässt sich deshalb ein Geschäft aufbauen, das nur „viele Stunden Robotikvideo“ verkauft. Der Premiumwert verschiebt sich zu Task-, Umgebungs-, Sensor- und Embodiment-Fit, zu seltenen Fehlern, aktuellen realen Arbeitsabläufen, geklärten Rechten, sinnvoll definierter Exklusivität und, am Ende, zu nachweisbarer Verbesserung des Zielmodells. Der Physical-AI-Datenmarkt funktioniert damit weniger wie ein Rohstoffmarkt und stärker wie ein Spezialzuliefermarkt.
Die Anbieterlandschaft im Vergleich
Sieben Namen tauchen in praktisch jeder Recherche zum Physical-AI-Datenmarkt auf: Mecka, Lightwheel, Truelabel, Roborecs, Khenda, Robotic Data und Tacit Robotics. Statt sieben einzelne Herstellerporträts aneinanderzureihen, lohnt der direkte Vergleich, weil sich daraus ablesen lässt, welchen Wettbewerbsvorteil jeder Anbieter tatsächlich verkauft.
| Anbieter | Modell | Herkunft der Daten | Rechte / Exklusivität | Format | Marktstatus (19.09.2026) |
|---|---|---|---|---|---|
| Mecka | Daten- und Deployment-Layer | Eigene Erhebung, Partner, EgoVerse als Basisschicht | Individuelle Unternehmensverträge | Plattform / Enterprise | Kommerziell aktiv; 60 Mio. US-$ Funding, projizierte 100 Mio. US-$ ARR (Herstellerangabe, Fortune 06/2026) |
| Lightwheel | Simulation + Daten + Evaluation | Reale Erfassung + Simulation, SimReady-Assets | Individuelle Enterprise-Verträge | RLDS, LeRobot | Kommerziell aktiv; rund 100 Mio. US-$ Q1-2026-Orders über die gesamte Physical-AI-Infrastruktur, nicht nur Daten (Herstellerangabe) |
| Truelabel | Marktplatz / Broker | Off-the-shelf-Kataloge, eigene Workforce, externe Vendoren | Anfragespezifisch | Buyer-Pipeline-Lieferung | Marktplatz operativ; Herstellerangabe über 100 Anbieter, Preise nicht öffentlich |
| Roborecs | EU-Direktlizenz-Marktplatz | Katalog + Capture-Partner | Non-exclusive / Expanded / Exclusive, EU-Jurisdiktion | LeRobot-kompatibel | Vorbereitungsphase: Katalog noch nicht befüllt, Zugang über Warteliste, Kapture-Programm für H2 2026 angekündigt |
| Khenda | Fabrik-/Workplace-Capture | Vertraglich angebundene Produktionsanlagen | Individuelle Consent- und Site Agreements, Exklusivität möglich | HDF5, LeRobot, RLDS, Custom | Kommerziell aktiv; SOC 2 Type II, ISO 27001 (Herstellerangabe) |
| Robotic Data | Globale Field-Data-Produktion | Globale Field-Operations | Individuelle Enterprise-Verträge | Custom | Kommerziell aktiv; Einsätze in 26 Ländern, mehrere hunderttausend Stunden Human Interaction Data (Herstellerangabe) |
| Tacit Robotics | Auftragserfassung | Rekrutierte Collectoren, reale Standorte | Programmspezifisch | Custom | Kommerziell aktiv; keine öffentliche Preisreferenz |
Die Tabelle zeigt vor allem eines: Kein Anbieter verkauft dasselbe Produkt unter dem gemeinsamen Wort „Daten“. Meckas Kombination aus Datenzugang und Deployment-Unterstützung steht neben Lightwheels Ansatz: Lightwheel verbindet Simulation mit Evaluation, Truelabel aggregiert Angebot über einen Marktplatz, Khenda verkauft Zugang zu echten Produktionsanlagen, Robotic Data bringt globale Feldoperationen ein, und Tacit spezialisiert sich auf drei klar getrennte Erfassungsformen.
Roborecs positioniert sich anders als die übrigen sechs. Das Unternehmen plant einen Robot-Training-Data-Marktplatz mit den Dimensionen Task, Modality, Sensor Stack, Hours, Provenance, Consent, Preview und License Tier sowie drei Lizenzstufen von Non-exclusive bis Exclusive. Nach eigener Website ist das ein Vorhaben und keine laufende Plattform: Der Katalog ist Stand 19. September 2026 noch nicht befüllt, der Zugang läuft über eine Warteliste, und das angekündigte Kapture-Programm soll erst in der zweiten Jahreshälfte 2026 starten, mit Herstellern nach eigenen Angaben „in discussion“. Für einen Einkäufer heißt das: Roborecs zeigt, wie ein europäischer Lizenzmarktplatz aussehen könnte – als nutzbare Beschaffungsquelle steht er noch nicht bereit.
Sechs Beschaffungswege statt einer Commodity
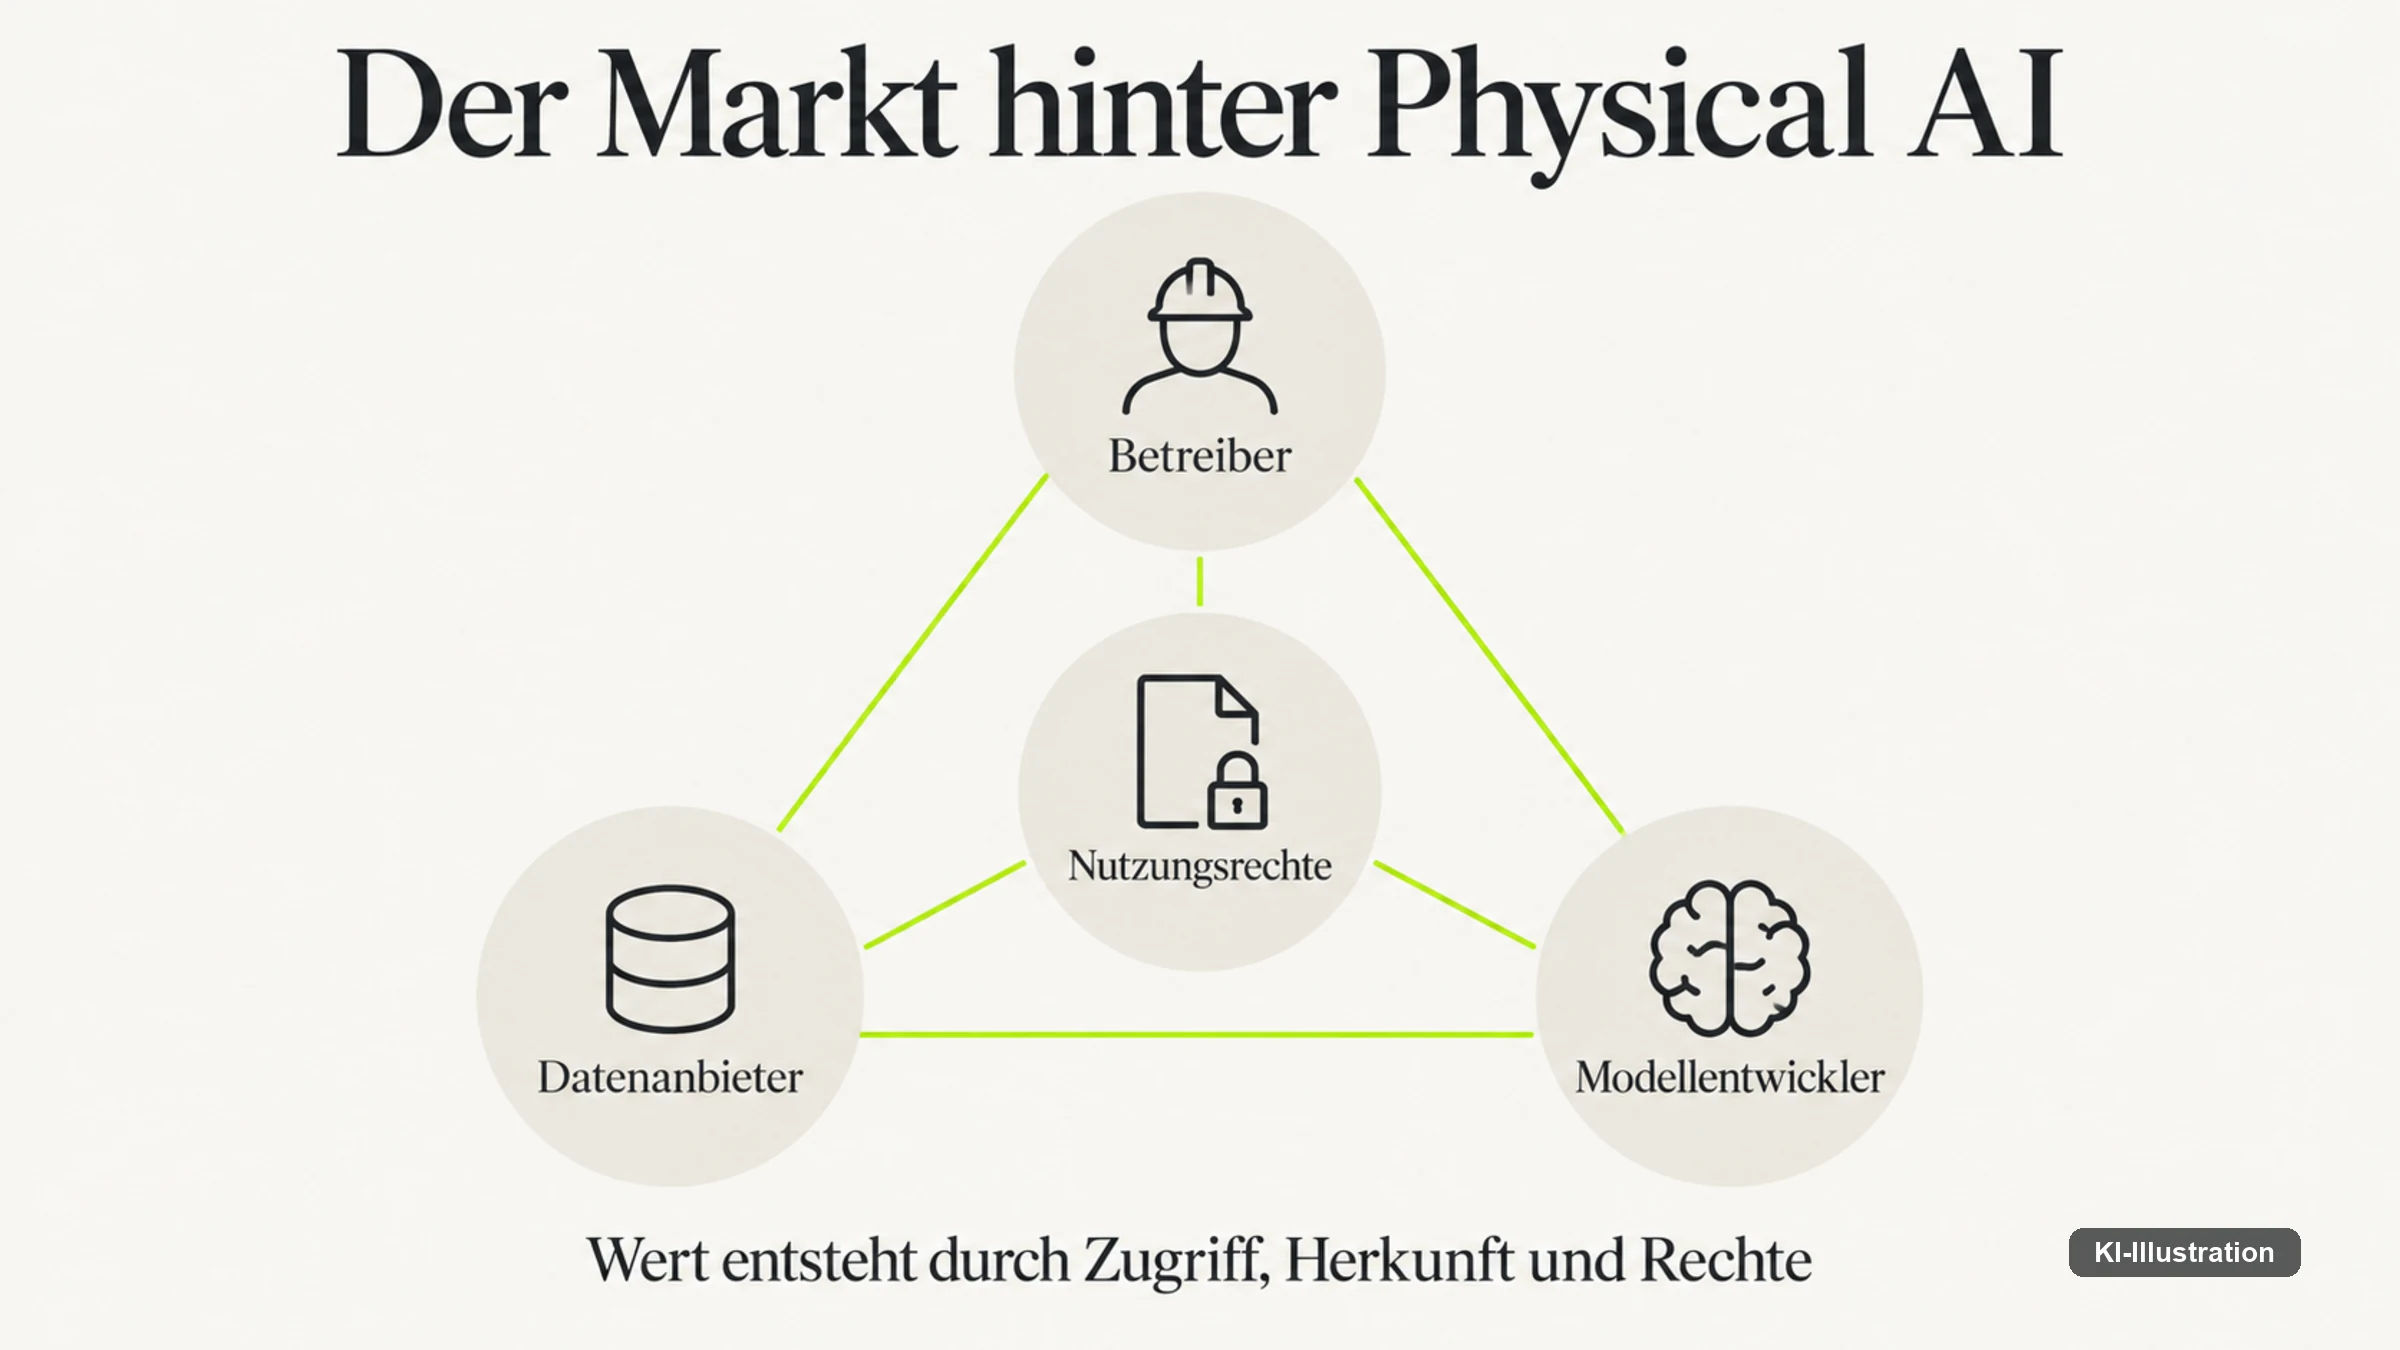
Über die einzelnen Anbieter hinweg lassen sich sechs unterschiedliche Beschaffungswege unterscheiden, und keiner ersetzt die anderen vollständig. Am einen Ende steht der offene Corpus – Open X-Embodiment, DROID, AgiBot World, RoboMIND, EgoVerse –, der ohne oder gegen reine Infrastrukturkosten nutzbar ist und vor allem beim Pretraining und Benchmarking hilft, aber an Task-Fit, Lizenzfragen und Aktualität stößt. Daneben gibt es die Off-the-Shelf-Lizenz auf einen bereits existierenden kommerziellen Datensatz: schnell verfügbar, aber selten exklusiv und nicht zwangsläufig passend zur eigenen Sensorik.
Der Marktplatz oder Broker – etwa Truelabel, perspektivisch auch Roborecs – aggregiert Angebot verschiedener Anbieter und übernimmt Rechteabwicklung, Sample-Bereitstellung und Matching. Das löst Suchkosten, erzeugt aber neue Arbeit, denn Consent-Formulare, Kalibrierung, Labels und Nutzungsrechte müssen erst vergleichbar gemacht werden. Ein Marktplatz beantwortet diese Fragen nicht automatisch, er macht sie nur an einer Stelle sichtbar.
Bei der Custom Collection – etwa bei Mecka, Tacit Robotics oder Robotic Data – definiert der Käufer Aufgabe, Region, Sensorik und Umfang selbst; das kostet mehr Vorlauf, liefert dafür aber eine passgenauere Verteilung. Workplace Capture, wie Khenda es betreibt, sammelt Daten aus echter Produktionsarbeit und erreicht damit den höchsten Deployment-Fit, gleichzeitig aber auch die höchste Governance-Anforderung, weil Werksdaten mehr zeigen als nur eine Handbewegung. Am anderen Ende steht der synthetische beziehungsweise simulationsbasierte Stack, wie ihn Lightwheel mit physikalisch kalibrierten Umgebungen und Evaluation anbietet: skalierbar und günstig, aber nur so gut wie die physikalische Modellierung von Reibung, Masse und Kontakt.
Eine angrenzende Schicht bilden reine Data-Ops-Dienstleister wie Digital Divide Data, die 2026 in Dehradun ein neues Kapazitätszentrum für egozentrische Erfassung, Annotation und Evaluation eröffnet haben. Sie verkaufen keine eigenen Datensätze, sondern die Arbeitskraft, die hinter jedem der sechs Modelle steckt.
Warum Rechte und Herkunft zum Produkt gehören
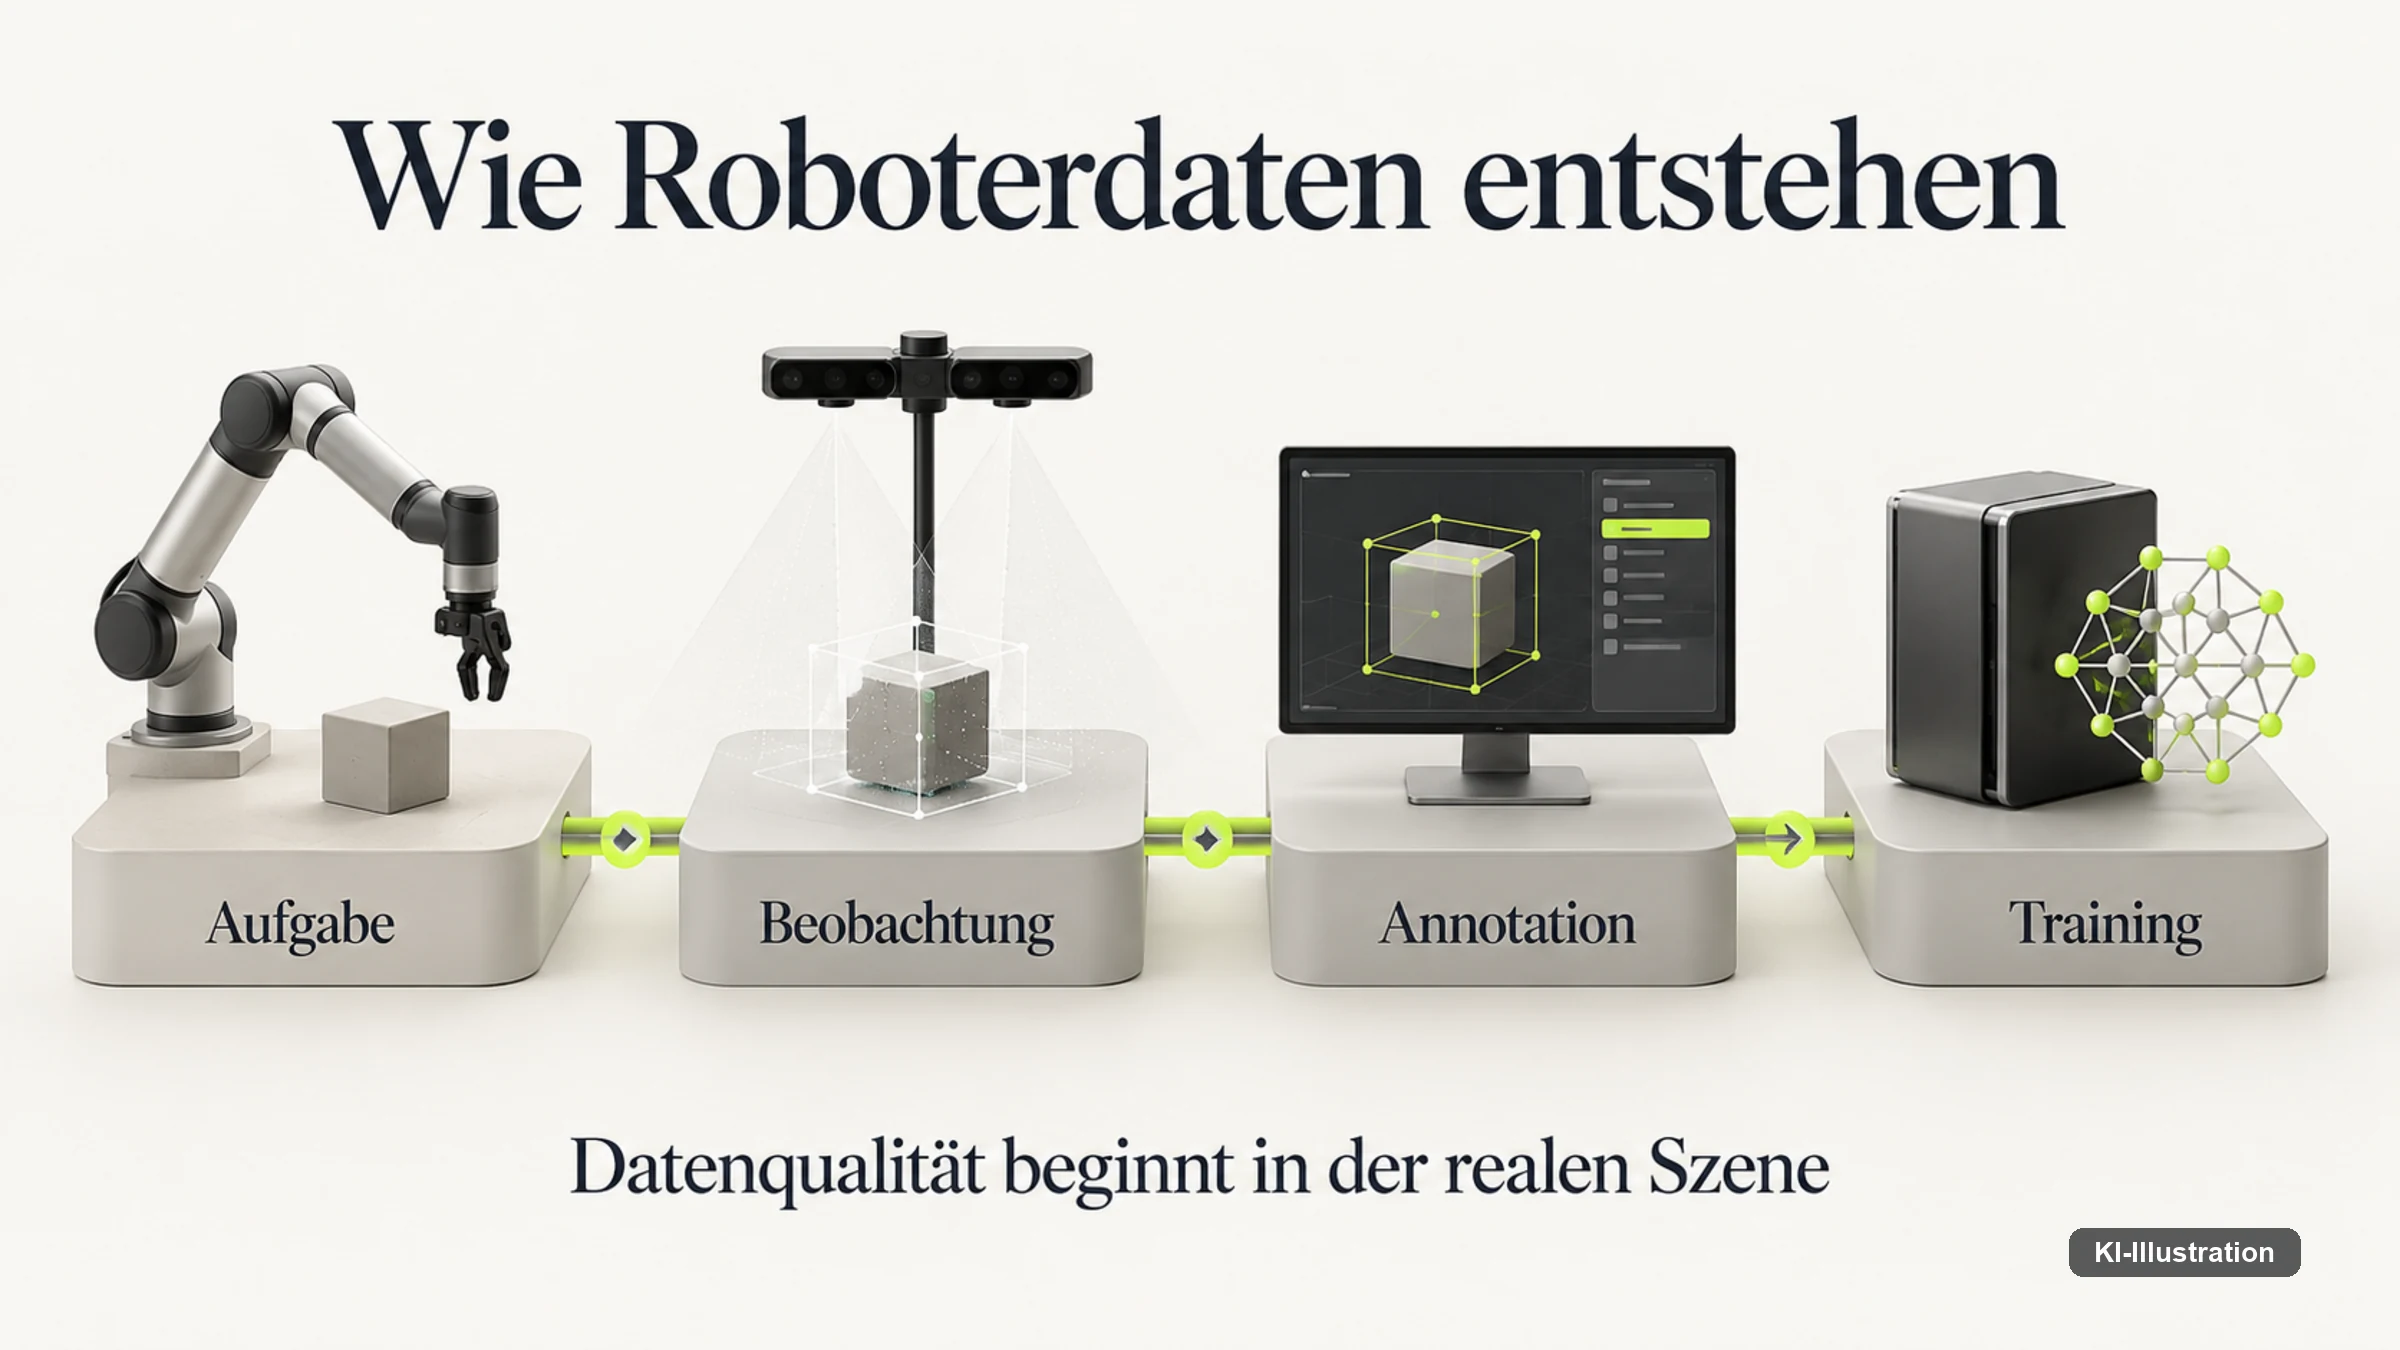
Bei einem professionellen Robotikdatensatz reicht Provenienz nicht als bloßes Aufnahmedatum. Wer entscheidungsrelevant einkauft, muss zusätzlich wissen: Wer hat aufgenommen, wer war im Bild, wer betreibt den Standort, welche Nutzungsrechte wurden für welchen Zweck eingeräumt – Training, Evaluation, Weiterverbreitung, Ableitung neuer Daten –, für welche Regionen und Modelle, wie lange, und welche Lösch- oder Widerrufsprozesse gelten. Diese Metadaten sind wirtschaftlich relevant, weil sie entscheiden, ob ein Datensatz später in einem kommerziellen Produkt überhaupt verwendet werden darf.
Besonders sensibel wird das bei Aufnahmen aus echten Fabriken, weil eine Kamera dort nicht nur Hände zeigt, sondern auch Produkte, Prozessreihenfolgen, Vorrichtungen, Qualitätsprobleme und mitunter unveröffentlichte Produktvarianten. Damit treffen mindestens zwei Rechtewelten aufeinander: personenbezogene Daten und Geschäftsgeheimnisse. Die Datenschutz-Grundverordnung öffnet in Art. 88 DSGVO ausdrücklich Raum für spezifischere Regeln zum Beschäftigtendatenschutz; die EU-Geschäftsgeheimnisrichtlinie 2016/943 – in Deutschland umgesetzt im Geschäftsgeheimnisgesetz (GeschGehG) – schützt nicht offengelegtes Know-how vor rechtswidriger Erlangung, Nutzung und Offenlegung. Ein Consent-Häkchen einer einzelnen operierenden Person löst diese Fragen deshalb nicht automatisch. Die rechtliche Grundlage vor jedem Datenhandel selbst — wer per EU Data Act überhaupt auf welche Roboterdaten zugreifen darf — ordnet ein eigener Beitrag zum Data Act ein.
Mehrere Anbieter machen genau diese Vertrauensschicht inzwischen zum Verkaufsargument. Khenda beschreibt individuelle Einwilligungen und Site Agreements, die Umfang, Zweck, Aufbewahrung und Weiterverwendung regeln, dazu SOC 2 Type II und ISO 27001 als Sicherheitsnachweis. Roborecs plant Dataset Cards mit Consent-Basis und Chain-of-Custody je Datensatz und positioniert sich ausdrücklich unter europäischer Jurisdiktion. Truelabel wirbt mit Commercial-Use-Terms und Provenance-Artefakten. Ob ein konkreter Vertrag im Einzelfall alle Anforderungen eines Käufers erfüllt, muss trotzdem individuell geprüft werden.
Was „exklusiv“ bei einem Datenkauf wirklich bedeutet
„Exklusiv“ ist eines der teuersten Wörter in diesem Markt, weil es selten definiert wird. Wer dafür zahlt, sollte klären, worauf sich die Exklusivität bezieht: auf die Rohvideos, auf annotierte Episoden, auf eine bestimmte Taskdefinition, auf ein Land, eine Branche oder einen Zeitraum. Darf der Anbieter ähnliche Szenen erneut aufnehmen? Darf er Embeddings aus denselben Aufnahmen für eigene Modelle nutzen? Ohne diese Klärung kann ein „exklusiver Datensatz“ wirtschaftlich viel weniger exklusiv sein, als ein Einkäufer beim Vertragsabschluss annimmt.
Sinnvoll lässt sich Exklusivität nach mehreren Dimensionen granular vereinbaren: als reine Rohdaten-Exklusivität für die Originalaufnahmen, als Task-Exklusivität, die dem Anbieter verbietet, denselben Task für Wettbewerber zu erfassen, als Standort-Exklusivität für eine einzelne Fabrik, als zeitlich befristete Exklusivität mit anschließender Freigabe, als regionale Exklusivität etwa nur für Deutschland, als Exklusivität gegenüber bestimmten Modellfamilien oder als Exklusivität, die Ableitungen wie Labels, synthetische Varianten oder trainierte Policies mit einschließt. Jede dieser Varianten hat einen anderen wirtschaftlichen Wert, und keine ist automatisch in den anderen enthalten.
Ob sich Exklusivität überhaupt lohnt, hängt davon ab, wie viel Modellverbesserung wirklich proprietär bleibt. Zeigt ein Datensatz nur allgemeines Greifen, das ohnehin in offenen Corpora vorkommt, bringt Exklusivität wenig, weil der Anbieter Wiederverkaufsoptionen verliert, ohne dass der Käufer einen messbaren Vorteil gegenüber Wettbewerbern erhält. Enthält er dagegen seltene Industrieprozesse, spezifische Fehlerfälle oder besonders wertvolle menschliche Expertise, kann derselbe Aufpreis strategisch sinnvoll sein.
Stunden, Episoden, Trajektorien: falsche Vergleichsgrößen
Stunden, Episoden, Trajektorien und Frames klingen austauschbar, sind es aber nicht. DROID zählt 76.000 Demonstrationstrajektorien beziehungsweise rund 350 Stunden, die AgiBot-World-Beta über eine Million Trajektorien, RoboMIND 2.0 mehr als 310.000, und EgoVerse nennt für die Paper-Version 1.362 Stunden und 80.000 Episoden. Ego2Robot berichtet sogar 18.561 Stunden robot-formatiger Daten über 15 Robotermorphologien – allerdings nicht als physisch ausgeführte Roboteroperation, sondern als durch Retargeting und Rendering synthetisierte Daten aus egozentrischen Human-Videos. Diese Zahlen lassen sich nicht gegeneinander dividieren, ohne zu wissen, wie eine Episode definiert ist, wie Pausen gezählt werden und ob es sich um Erfolg oder Fehler, reale oder synthetisierte, menschliche oder robotische Daten handelt.
Dazu kommt die Formatfrage. Die LeRobotDataset-Struktur von Hugging Face standardisiert multimodale Zeitreihendaten, Video, Zustands-/Aktionsdaten und Metadaten in einer skalierbaren Form, nachdem Open X-Embodiment zuvor viele Quellen über das RLDS-Format vereinheitlicht hatte; Lightwheel und Khenda nennen LeRobot beziehungsweise RLDS ausdrücklich als Auslieferungsformat. Ein Format löst aber nur, dass ein Loader funktioniert, nicht ob ein Modell daraus lernt. Zwei LeRobot-kompatible Datensätze können trotzdem inkompatibel bleiben, wenn der eine einen Einarm-Greifer bei 10 Hertz mit einer Kamera erfasst und der andere zwei fingerfertige Hände bei 30 Hertz mit Handgelenkkameras – derselbe Container, ein anderer Embodiment Gap.
Für den Einkauf folgt daraus eine einfache Konsequenz: Eine Stundenzahl im Angebot sagt fast nichts, solange Episodendefinition, Erfolgskriterium und Sensorstack nicht mitgeliefert werden.
Wie sich der Trainingswert eines Datensatzes prüfen lässt
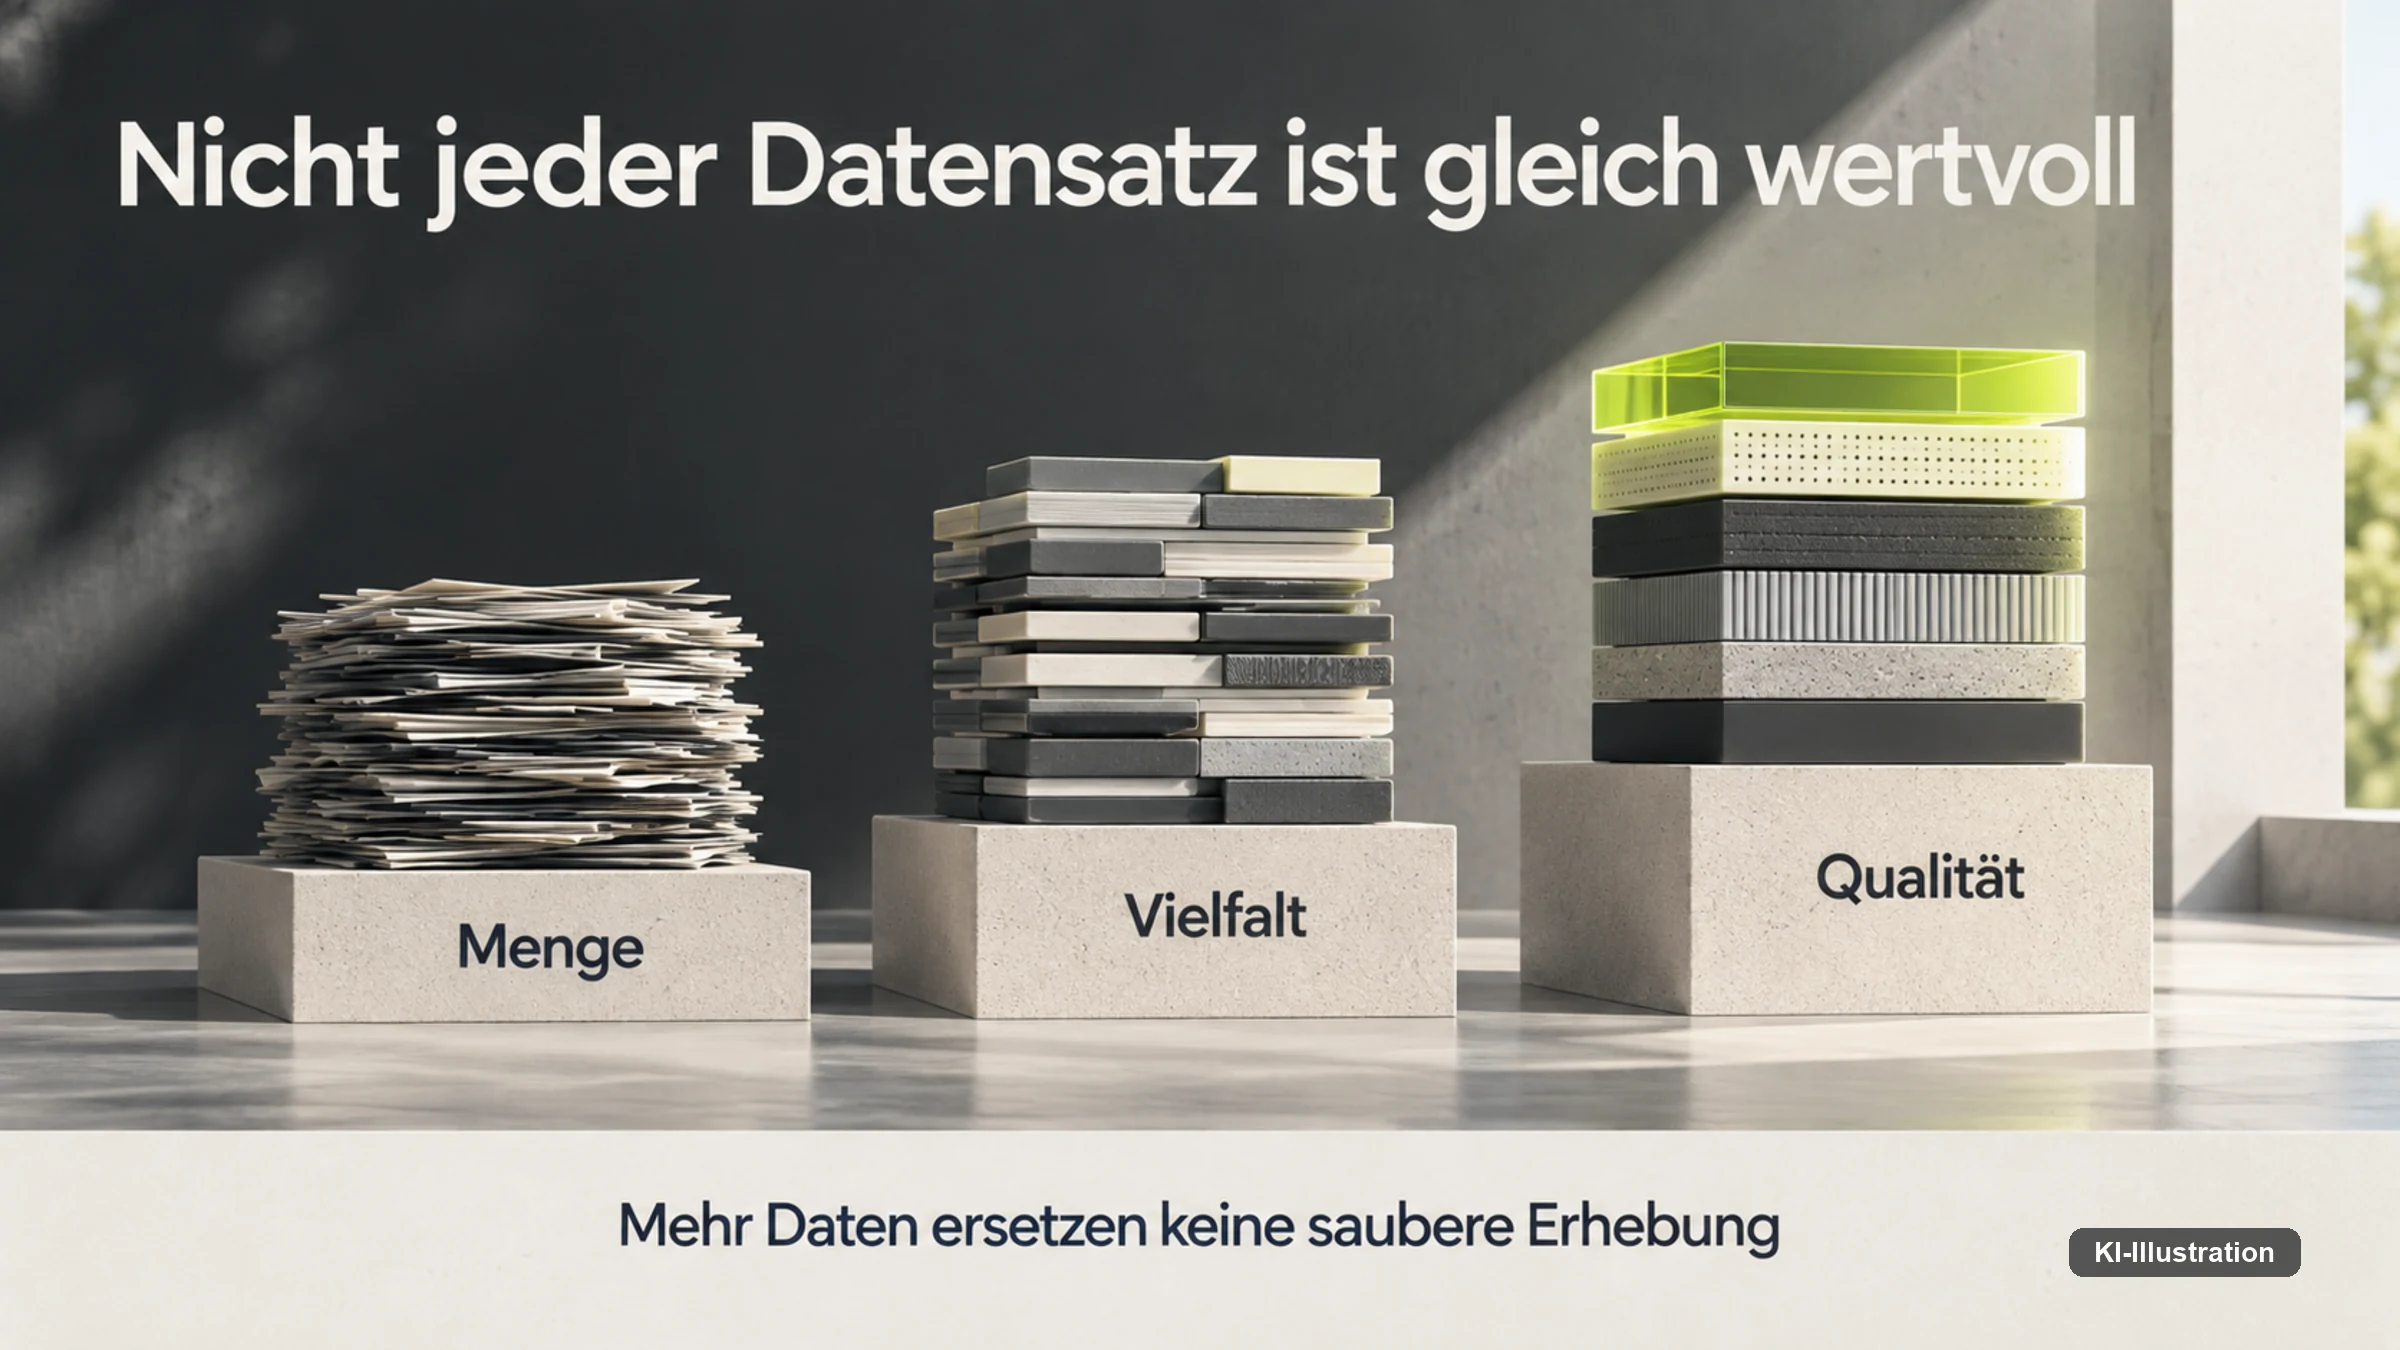
Wie viel ein Datensatz wirklich wert ist, zeigt sich erst, wenn man rohes Erfassungsvolumen von akzeptiertem Trainingswert trennt. Dafür eignet sich ein einfaches Stufenmodell, das wir für diesen Beitrag verwenden – keine Branchennorm, sondern eine eigene Ordnung, um Rohmaterial und Trainingswert nicht zu verwechseln.
| Stufe | Was hier geprüft wird | Typischer Verlust gegenüber der Vorstufe |
|---|---|---|
| 1. Erfasst | Rohmaterial existiert, ungeprüft | – |
| 2. Rechtlich geklärt | Nutzung ist vertraglich und rechtlich ausreichend abgesichert | Anteil ohne belastbare Zustimmung fällt weg |
| 3. Technisch valide | Streams synchron, kalibriert, keine kritischen Datenlücken | Aufnahmen mit Drift oder fehlenden Kanälen fallen weg |
| 4. Aufgabenrelevant | Inhalt passt zum definierten Data Brief | Off-Topic-Material fällt weg |
| 5. Qualitätsgeprüft | Interne Abnahmekriterien bestanden | Fehlerhafte oder redundante Episoden fallen weg |
| 6. Trainingsfähig | Format, Labels und Pipeline funktionieren durchgängig | – |
| 7. Wirkung nachgewiesen | Verbessert nachweislich die definierte Zielmetrik | Episoden ohne messbaren Beitrag zählen wirtschaftlich nicht |
Nur die letzte Stufe zeigt den tatsächlichen wirtschaftlichen Trainingswert. Sammelt ein Anbieter beispielsweise 1.000 Stunden, bleiben nach Rechteprüfung vielleicht 950, nach technischer Prüfung 850, nach Aufgabenrelevanz 600 und nach Qualitätsprüfung 500 – und erst das Training zeigt, ob überhaupt eine Teilmenge davon die Zielmetrik verbessert. Der Käufer hat dann nicht 1.000 wertvolle Stunden erworben, sondern 500 akzeptierte Stunden mit einem bestimmten, klar definierten Modellzuwachs.
Für den Vergleich zwischen Angeboten sind deshalb zwei abgeleitete Kennzahlen brauchbarer als eine reine Stundenzahl: die Kosten je akzeptierter Episode – Gesamtkosten des Programms geteilt durch die Zahl der Episoden, die alle sieben Stufen durchlaufen haben – und die Modellverbesserung je 1.000 akzeptierter Episoden. Beide Kennzahlen sind aber nur innerhalb derselben Modellarchitektur, derselben Ausgangsgewichte, desselben Evaluationssets und derselben Trainingskonfiguration vergleichbar; über verschiedene Anbieter hinweg verlieren sie ihre Aussagekraft.
Was sich über Preise tatsächlich sagen lässt
Eine belastbare, öffentliche Marktpreisangabe pro Roboterdatenstunde gibt es nach dieser Recherche nicht. Über Modalität, Hardware, Land, Aufgabe, Exklusivität, Operatorenzahl, Site-Zugang, Consent, Annotation und Lieferzeit hinweg wäre „Robotikdaten kosten X Euro pro Stunde“ reine Scheingenauigkeit, und keiner der geprüften Anbieter veröffentlicht eine Preisliste. Das ist für einen Einkäufer trotzdem eine nützliche Information: Wer eine Preistabelle wie bei Cloud-Compute erwartet, wird enttäuscht, weil dieser Markt noch als Einzelanfrage funktioniert.
Was sich stattdessen ablesen lässt, sind Größenordnungen auf Unternehmensebene. Mecka hat nach eigenen Angaben zunächst 8 Millionen US-Dollar Seed-Kapital (August 2025) und im Juni 2026 zusätzlich 60 Millionen US-Dollar (25 Millionen US-Dollar Series A plus 35 Millionen US-Dollar Follow-on) aufgenommen; eine mögliche weitere Bewertungsrunde bei rund 500 Millionen US-Dollar wurde Stand September 2026 gemeldet, aber noch nicht abgeschlossen. Gründer Josh Gao nannte gegenüber Fortune im Juni 2026 zusätzlich eine erwartete jährliche Run Rate von 100 Millionen US-Dollar auf Basis bereits unterzeichneter Verträge – eine Unternehmensprojektion aus einem Interview, kein testierter Umsatz. Lightwheel meldete für das erste Quartal 2026 rund 100 Millionen US-Dollar an Orders, die allerdings Simulation, Datengenerierung, Evaluation und Deployment-Systeme zusammen umfassen und sich nicht auf reinen Datenverkauf reduzieren lassen. Beide Zahlen sind keine Marktgrößen, zeigen aber, dass Kapital und Beschaffungsbudgets sich sichtbar in Richtung dieser Daten- und Evaluationsschicht verschieben.
Für die eigene Beschaffung folgt daraus ein praktischer Weg statt einer Preistabelle: Ein Anbieter liefert zunächst 100 bis 500 Sample-Episoden, der Käufer trainiert damit kontrolliert und misst Task-Erfolg, Fehlermodi und Generalisierung gegen den eigenen Benchmark, bevor ein größerer Auftrag ausgelöst wird. Die Kosten je akzeptierter Episode aus dem vorigen Abschnitt lassen sich dann als interner Vergleichsmaßstab zwischen mehreren Angeboten nutzen, auch ohne dass ein externer Marktpreis existiert.
Die Lücke kaufen, nicht die Menge
Die zentrale Beschaffungsregel dieses Markts lautet: die Lücke kaufen, nicht die Menge. Statt mit „Wie viele Stunden bekommen wir?“ zu beginnen, sollte ein Einkäufer zuerst fragen, woran das eigene Modell heute konkret scheitert – an einem Stecker unter schlechter Beleuchtung, an einer bestimmten Schraube, an linkshändiger Bedienung oder an einem bestimmten Werkzeugwechsel. Erst aus einem so beschriebenen Data Gap wird eine sinnvolle Kaufentscheidung, denn eine Forderung wie „100.000 Stunden Physical-AI-Daten“ lässt sich weder erfüllen noch überprüfen.
Praktisch läuft das über wenige, klar abgegrenzte Schritte. Das bestehende Modell wird gegen den Zielbenchmark getestet, um Fehler-Cluster zu identifizieren; daraus entsteht eine Datenspezifikation mit Aufgaben, Objekten, Umgebung, Sensorstack und Erfolgskriterien. Bevor irgendjemand 10.000 Stunden bestellt, liefert der Anbieter eine kleine Stichprobe, die eine Rechteprüfung – Provenienz, Consent, Standortrechte, Weiterverwendung – und eine technische Qualitätsprüfung auf Synchronisation, Kalibrierung und fehlende Datenströme durchläuft. Erst dann folgt ein kontrolliertes A/B-Training mit gleicher Modellversion und gleichem Benchmark, und nur wenn dieser Test eine Verbesserung zeigt, wird skaliert.
Ein guter Data-Anfrage-Brief ist dabei ungewöhnlich konkret: nicht „bimanuale Industriedaten“, sondern benannte Task-Familien, Objektklassen, Materialien, Lichtverhältnisse, Schutzausrüstung, Kamerasystem, Bildrate, Aktionsrepräsentation, Region, Operatorvielfalt, das Verhältnis von Erfolgs- zu Fehlerfällen, Rechte, Exklusivität und ein Abnahmetest. Nur so lassen sich zwei Angebote überhaupt vergleichen, weil sonst jeder Anbieter ein anderes Bündel unter demselben Wort „Daten“ verkauft.
Wer kauft, entscheidet auch, was er braucht
Der Physical-AI-Datenmarkt wirkt von außen wie eine einzelne Branche, tatsächlich kaufen unterschiedliche Käufergruppen aber unterschiedliche Dinge. Ein Foundation-Model-Team, das ein breites VLA- oder Weltmodell trainiert, sucht vor allem Breite über viele Aufgaben, Umgebungen und Embodiments – hier kann ein großer offener Corpus einen erheblichen Teil der Arbeit übernehmen, während kommerzielle Daten vor allem geografische Lücken, fehlende Fertigkeiten oder ungewöhnliche Objekte ergänzen. Ein Robot-OEM braucht dagegen zusätzlich die eigene Handkinematik, eigene Kamerapositionen und eigene Fehlermodi, weil roboterspezifische Daten mit wachsender Nähe zum Einsatz wertvoller werden. Ein Industriebetreiber wiederum interessiert sich kaum für generischen Robotikcontent, sondern für die eigene Station, die eigenen Teile, die eigenen Toleranzen und die eigenen Beschäftigten – der Bedarf verschiebt sich damit vom allgemeinen Pretraining zu einem eng zugeschnittenen Datensatz für die letzte Meile der Auslieferung. Ein viertes Segment kauft gar nicht primär zum Trainieren, sondern zum Testen: Evaluationskäufer wollen wissen, ob ein Modell unter unbekannter Beleuchtung, mit anderen Schrauben oder bei linkshändigen Operatoren noch funktioniert, und solche Testdaten können einen eigenen Marktwert besitzen, wenn sie unabhängig vom Trainingsanbieter bleiben.
Build vs. Buy: welcher Weg zu welcher Lücke passt
Aus dieser Segmentierung folgt auch die Build-vs-Buy-Abwägung selbst. Eigenerhebung sichert volle Kontrolle über Rechtekette und Sensorstack, verlangt aber Recruiting, Hardware, Standorte, Operatoren, Qualitätssicherung und Rechteverwaltung – ein Robotikunternehmen kann dabei unversehens eine eigene Data-Operations-Firma betreiben. Ein Off-the-Shelf-Kauf ist sofort verfügbar und günstig als Baseline, bleibt aber nicht exklusiv und passt selten exakt zur eigenen Verteilung. Eine beauftragte Custom Collection lässt sich rechtlich und technisch auf den eigenen Bedarf zuschneiden, kostet dafür mehr Vorlauf und Zeit bis zur ersten belastbaren Lieferung. Partner Capture, bei dem eine Fabrik gemeinsam mit einem Anbieter erhebt, erreicht den größten Deployment-Fit bei der komplexesten Governance. In der Praxis kombinieren die meisten Unternehmen deshalb offene Daten als Basis, Off-the-Shelf-Material für schnelle Lücken und Custom Collection für die verbleibenden, wirklich entscheidenden Fehlercluster.
Woran ein Deal nach der Lieferung noch scheitert
Auch ein rechtlich sauber eingekaufter Datensatz kann sich nachträglich entwerten. Stellen Sie sich vor, ein Unternehmen trainiert monatelang, bevor sich herausstellt, dass ein Standortvertrag zwar Forschung, aber keine kommerzielle Modellverbreitung erlaubte, oder dass eine Einwilligung von Beschäftigten die konkrete Weiterverwendung nicht abdeckte. Der wirtschaftliche Wert einer Datenpipeline hängt deshalb nicht nur von der Aufnahmequalität ab, sondern davon, wie dauerhaft die eingeräumten Rechte tatsächlich tragen.
Damit eng verbunden ist die Frage nach Ableitungen. Annotationen, Feature-Embeddings, synthetische Varianten, feinabgestimmte Gewichte und daraus abgeleitete Policies entstehen fast zwangsläufig aus jedem Trainingsprozess. Wenn ein Lizenzvertrag nur „Dataset Use“ erlaubt, bleibt oft unklar, was mit diesen Ableitungen geschehen darf – und genau das wird heikel, sobald Datenanbieter, Fabrik, operierende Person, Käufer und Cloud-Anbieter fünf unterschiedliche Parteien mit fünf unterschiedlichen Interessen sind.
Ein drittes Risiko liegt in der Messung selbst: Wenn die Evaluationsszenen einem Trainingsdatensatz zu ähnlich sind – dieselbe Küche, dieselbe Fabrik, dieselben Personen, dieselben Objekte –, misst ein starkes Testergebnis eher Wiedererkennung als echte Generalisierung. Methodisch stabiler ist es, wenn der Käufer einen eigenen, dem Anbieter nicht bekannten Evaluationssatz zurückhält und Lieferungen stufenweise gegen diesen Satz prüft. Keines dieser Risiken bedeutet automatisch, dass ein Anbieter unseriös handelt, denn die Ursache liegt oft im eigenen Trainingsrezept oder in einem zu engen Benchmark. Ein Vertrag, der Datenfehler, Spezifikationsabweichung und Modellbeschränkung nicht sauber trennt, führt trotzdem fast zwangsläufig zu Streit.
Wohin sich der Markt bewegt
Mit wachsenden offenen und synthetischen Corpora verschiebt sich der Markt absehbar in zwei Schichten. Für häufige Aufgaben, offene oder nicht-exklusive Daten und standardisierte Formate entsteht eine Commodity-Schicht mit niedrigen Margen und großem Volumen; für proprietäre Prozesse, seltene Fehler, hohe Compliance-Anforderungen und exklusive Standortkorpora bleibt eine Premium-Schicht mit deutlich höheren Margen. Das folgt derselben Logik, die man aus anderen Datenmärkten kennt: Generisches wird billig, Spezifisches bleibt teuer.
Synthetische Daten dürften diese Verschiebung beschleunigen. Ego2Robot zeigt, wie sich aus egozentrischen Human-Videos große Mengen robot-formatiger Trainingsdaten synthetisieren lassen, und Lightwheel automatisiert vergleichbare Pipelines für synthetische Daten und SimReady-Umgebungen. Je besser solche Verfahren werden, desto stärker konzentriert sich realer Capture auf das, was Simulation schwer trifft: Reibung, deformierbare Objekte, Werkzeugverschleiß, menschliche Variabilität und unaufgeräumte Fabrikzustände.
Langfristig könnte der wertvollste Datensatz ohnehin nicht der gekaufte sein, sondern der, den ein bereits produktiver Roboter im eigenen Betrieb selbst erzeugt: Er arbeitet, scheitert gelegentlich, wird durch menschliches Eingreifen korrigiert, die Korrektur wird gelabelt und fließt zurück ins Training. Kommerzielle Anbieter können helfen, diesen Kreislauf überhaupt erst in Gang zu setzen – ob er sich danach selbst trägt, entscheidet sich an der Flottengröße und an der Häufigkeit echter Fehler, nicht an der Menge zugekaufter Stunden.
Fazit: Lernfortschritt statt Videostunden
Der Physical-AI-Datenmarkt ist real, weil Unternehmen heute konkret Datenzugang, Custom Collection, Workplace Capture, Lizenzierung, Simulation, Evaluation und Deployment-Unterstützung anbieten und dafür sichtbares Kapital sowie reale Kundenverträge existieren. Er ist aber noch jung: Es gibt keine einheitliche Stunde, keine standardisierte Preisstruktur, keine gemeinsame Rechtearchitektur und keine universelle Qualitätsmetrik.
Offene Daten werden den unteren Teil des Markts weiter verbilligen, denn generische Manipulationsdaten stehen inzwischen in großem Umfang kostenlos zur Verfügung. Der Premiumwert wandert dagegen zu dem, was sich schwer kopieren lässt: echte Produktionsprozesse, seltene Fehlerfälle, rechtlich geklärte Daten, sinnvoll definierte Exklusivität und vor allem ein messbarer Modellzuwachs. Wer als Einkäufer oder Data-Product-Manager vor einer Build-vs-Buy-Entscheidung steht, sollte deshalb nicht fragen, wie viele Stunden ein Angebot umfasst, sondern welche konkrete Fähigkeit der eigene Roboter danach beherrscht – und wie sich das vor dem großen Auftrag mit einer kleinen, kontrollierten Stichprobe belegen lässt.
Sobald der Markt diese Frage routinemäßig beantworten kann, wird aus einem heute noch unübersichtlichen Projektgeschäft eine geordnete Industrie. Bis dahin gilt: Nicht die Daten mit den meisten Sensoren sind die teuersten, sondern jene, die teuer eingekauft werden und anschließend nichts am Modell verbessern.
Was kostet eine Stunde Roboterdaten?
Dafür gibt es keinen belastbaren öffentlichen Marktpreis, weil Modalität, Sensorik, Rechtelage, Exklusivität und Region den Wert zu stark verändern. Verlässlicher als ein Stundenpreis ist ein Sample-Test: Ein Anbieter liefert 100 bis 500 Beispiel-Episoden, bevor ein größerer Auftrag ausgelöst wird.
Sind offene Datensätze wie Open X-Embodiment oder AgiBot World kommerziell frei nutzbar?
Nicht automatisch. Open X-Embodiment nutzt offene Lizenzstrukturen, die relevante Repository-Version von AgiBot World Beta steht dagegen unter CC BY-NC-SA 4.0, was kommerzielle Nutzung einschränkt. Jeder offene Datensatz braucht deshalb eine eigene Lizenzprüfung vor dem Einsatz.
Ist der Roborecs-Marktplatz bereits nutzbar?
Nein. Roborecs plant einen Robot-Training-Data-Marktplatz mit Lizenzstufen von Non-exclusive bis Exclusive, der Katalog ist Stand 19. September 2026 aber noch nicht befüllt. Der Zugang läuft über eine Warteliste, das angekündigte Kapture-Programm soll erst in der zweiten Jahreshälfte 2026 starten.
Was bedeutet „exklusiv“ bei einem Robotikdatensatz?
Das hängt von der vereinbarten Dimension ab – Rohdaten, ein bestimmter Task, ein Standort, eine Zeitspanne, eine Region, eine Modellfamilie oder auch Ableitungen wie Labels und trainierte Gewichte. Ohne diese Festlegung kann ein „exklusiver“ Datensatz wirtschaftlich viel weniger exklusiv sein, als der Käufer annimmt.
Welche Rechte muss ein Datensatz aus einer echten Fabrik zusätzlich klären?
Neben der Einwilligung der gefilmten Personen nach Datenschutzrecht geht es um Geschäftsgeheimnisse, weil eine Werkskamera auch Prozesse, Vorrichtungen und unveröffentlichte Produktvarianten zeigt. Ein einzelnes Consent-Häkchen deckt diese zweite Rechteebene nicht automatisch ab.
Wie lässt sich der Trainingswert eines Datensatzes vor dem großen Auftrag prüfen?
Über eine kleine, kontrollierte Stichprobe: Der Anbieter liefert Sample-Episoden, der Käufer trainiert damit unter gleichbleibenden Bedingungen und misst Task-Erfolg gegen einen eigenen, dem Anbieter nicht bekannten Evaluationssatz. Erst ein nachgewiesener Modellzuwachs rechtfertigt eine Skalierung.
Build, Buy oder Custom Capture – wie entscheidet ein Unternehmen das?
Das hängt vom Fehlerbild ab: Fehlt allgemeine Breite, hilft oft ein offener Corpus. Fehlt eine spezifische Umgebung oder Sensorik, lohnt sich eine beauftragte Custom Collection. Braucht es maximale Kontrolle über die Rechtekette, bleibt nur die eigene Erhebung – die meisten Unternehmen kombinieren alle drei Wege.
Warum ist die Anzahl der Stunden allein keine gute Einkaufsmetrik?
Weil Rechteprüfung, technische Qualitätskontrolle und Aufgabenrelevanz einen großen Teil des Rohvolumens aussortieren, bevor überhaupt trainiert wird. Aussagekräftiger sind die Kosten je akzeptierter Episode und der nachgewiesene Modellzuwachs je 1.000 akzeptierter Episoden.
Quellen & Stand: mecka.ai (Positionierung, Datenzugang); fortune.com, 01.06.2026 (Mecka-Funding und ARR-Projektion, Herstellerangabe/Interview); arxiv.org/abs/2604.07607 (EgoVerse-Paper, Forschungsquelle) und die Mecka-EgoVerse-Explorer-Plattform (laufender Datenstand); lightwheel.ai inkl. Q1-2026-Orders-Meldung; truelabel.ai (Marktplatz-Positionierung); roborecs.com/datasets und roborecs.com (Marktplatz-Vorhaben, Status Warteliste, Stand 19.09.2026); khendarobotics.com (Workplace Capture, Security-Zertifizierungen); roboticdata.com (Field-Operations); tacitrobotics.com (Collection-Formate); expresscomputer.in, 11.09.2026 (Digital Divide Data, Dehradun); github.com/google-deepmind/open_x_embodiment; droid-dataset.github.io; github.com/OpenDriveLab/Agibot-World (Lizenz CC BY-NC-SA 4.0); arxiv.org/abs/2512.24653 (RoboMIND 2.0); huggingface.co/docs/lerobot/lerobot-dataset-v3; arxiv.org/abs/2608.02580 (Ego2Robot); eur-lex.europa.eu, Verordnung (EU) 2016/679 (DSGVO) und Richtlinie (EU) 2016/943 (Geschäftsgeheimnisse). Herstellerangaben sind Bestangaben und an der Primärquelle zu prüfen; Roborecs-Angaben spiegeln ausdrücklich eine Vorbereitungsphase, keinen laufenden Marktplatz. Ein öffentlicher Preis pro Datenstunde ist nicht belegt und wird hier bewusst nicht beziffert. Diese Einordnung ist redaktionell und keine Rechts- oder Anlageberatung. Stand: 19. September 2026.