News & Markt · Marktüberblick
KI-Kosten im Unternehmen: was jenseits des Modellpreises tatsächlich anfällt
Kurz gesagt: Der Preis, ein festgelegtes Leistungsniveau zu erreichen, ist in drei Jahren um mehrere Größenordnungen gefallen — auf einem verbreiteten Prüfsatz von 60,00 auf 0,07 US-Dollar je Million Token. Der laufende Betrieb wird davon kaum billiger, weil die Rechnung an anderen Stellen entsteht: bei Fehlversuchen, beim Kontextaufbau, bei Werkzeugaufrufen und bei der menschlichen Prüfung. Die belastbare Kennzahl ist deshalb nicht der Preis je Abfrage, sondern der Preis je erledigtem Vorgang. Und die europäische Statistik setzt dieser Erzählung einen Widerspruch entgegen, der hier nicht unterschlagen wird.
Die Budgetzeile, die sich am leichtesten ausrechnen lässt
In jeder Planung für ein KI-Vorhaben gibt es einen Posten, der sich sauber berechnen lässt: Preis je Million Token mal erwartetes Volumen. Die Zahl steht auf einer öffentlichen Preisliste, sie lässt sich in eine Tabelle eintragen, und sie sieht im Genehmigungsantrag beruhigend aus.
Genau deshalb ist sie der unzuverlässigste Teil der Rechnung. Sie beschreibt den Rohstoff, nicht das Produkt — ungefähr so, wie der Kilopreis für Stahl einen Karosseriebau beschreibt.
Wenn Sie im Unternehmen für ein Agentenvorhaben ein Budget verantworten und es im Folgejahr wieder verteidigen müssen, ist die interessante Frage nicht, ob KI teuer ist. Interessant ist, welche Posten in einem Jahr steigen werden, während die Preisliste fällt. Denn beides passiert gleichzeitig, und wer nur die Preisliste verfolgt, wird von der eigenen Abrechnung überrascht. Wer aus welchem Interesse an der KI-Leistung tatsächlich spart oder bremst, ordnet ein eigener Beitrag zur KI-Drosselung ein.
Dass die Frage offen ist, zeigt das Programm der HumanX Europe 2026, die vom 22. bis 24. September 2026 im RAI Amsterdam läuft. Ein Programmpunkt trägt den Titel „Deploying at Scale: The True Cost of AI“, angekündigt ist dafür James Waters. Der Zusatz „true“ in einem Konferenztitel setzt voraus, dass die geläufige Kostenangabe als unvollständig gilt — sonst müsste man sie nicht eigens als die wahre bezeichnen.
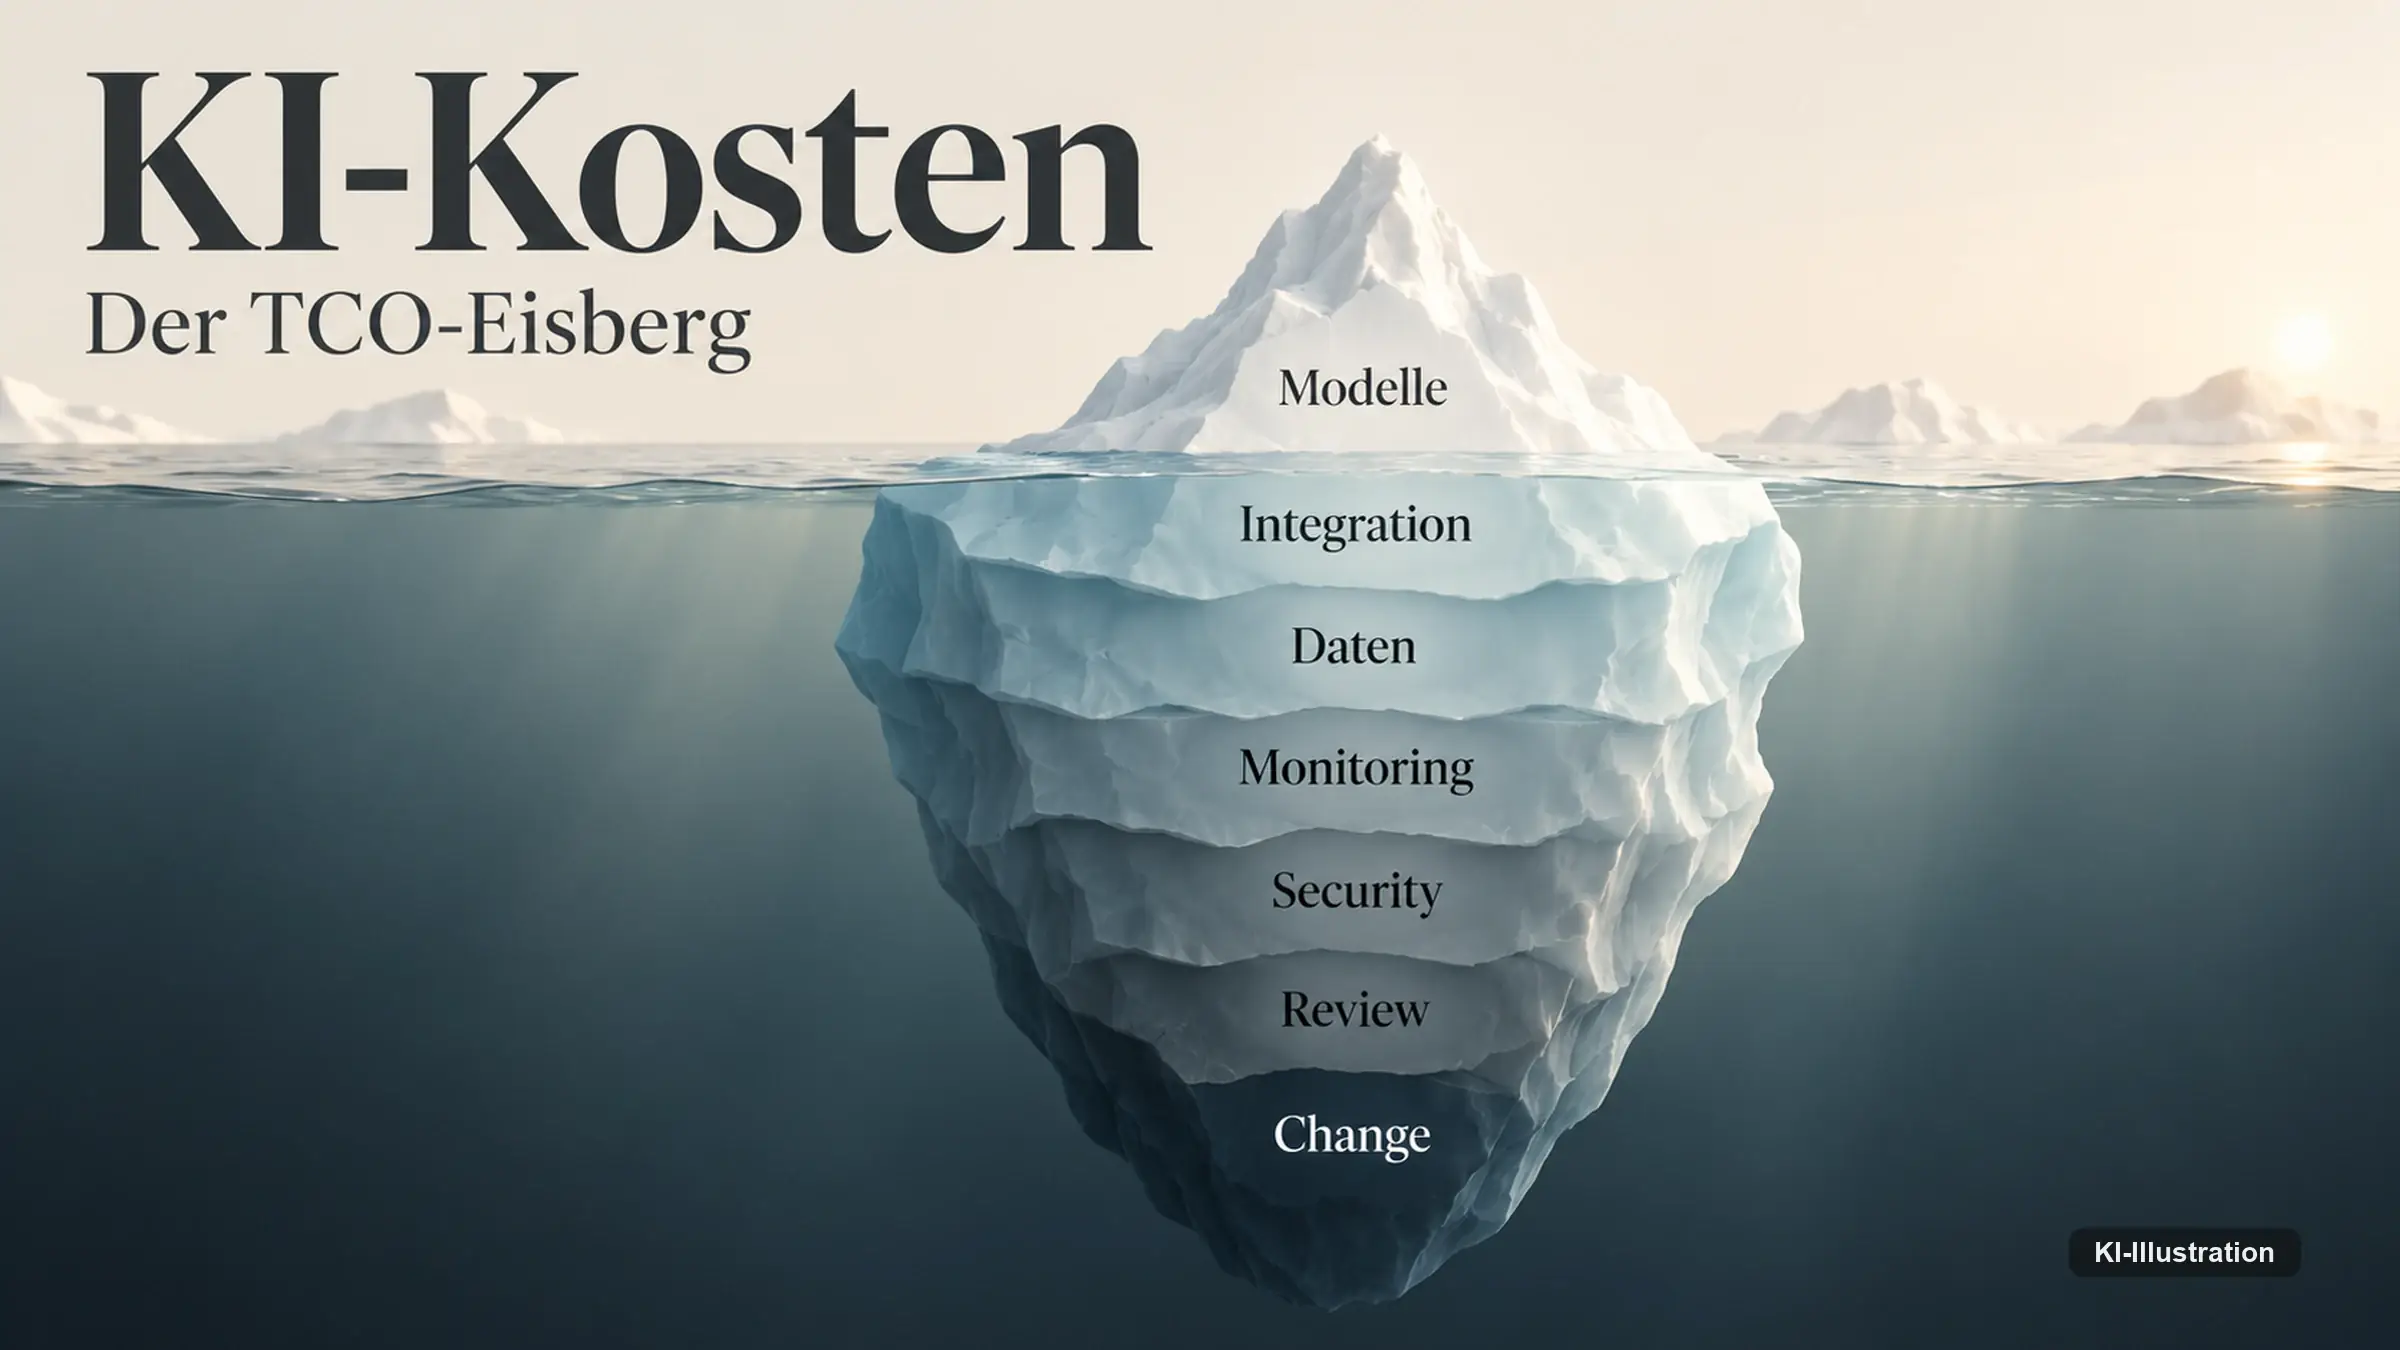
Eine Beispielkalkulation in Euro hilft an dieser Stelle nicht weiter. Solche Rechnungen sehen präzise aus und sind es nie, weil jede ihrer Annahmen vom eigenen Haus abhängt: von der Art der Vorgänge, von der Datenlage, von der Frage, wer die Ergebnisse gegenliest. Belastbar ist nur die Zerlegung der Rechnung in ihre Bestandteile, und die lässt sich an belegten Zahlen zeigen.
Warum billiger nicht günstiger heißt
Der Preisverfall bei Modellabfragen ist real, und er ist beeindruckend. Das Forschungsinstitut Epoch AI hat am 12. März 2025 nachgerechnet, wie sich der Preis entwickelt, wenn man ein Leistungsniveau festhält und fragt, was es im Zeitverlauf kostet. Je nach Aufgabe fiel dieser Preis um das Neun- bis Neunhundertfache pro Jahr.
Für das Niveau von GPT-3 auf einem verbreiteten Prüfsatz lassen sich vier Stützpunkte nennen: 60,00 US-Dollar je Million Token im November 2021, 20,00 im September 2022, 2,00 im März 2023 und 0,07 im Oktober 2024. Das Stanford-Institut für menschenzentrierte KI beziffert den Rückgang für ein GPT-3.5-Niveau zwischen November 2022 und Oktober 2024 auf mehr als das 280-Fache und nennt daneben rund 30 Prozent sinkende Hardwarekosten und rund 40 Prozent steigende Energieeffizienz pro Jahr.
Zwei Einschränkungen gehören zu diesen Zahlen, und beide sind für die Planung wichtiger als die Zahlen selbst. Gemessen wird ein Listenpreis für ein eingefrorenes Leistungsniveau, nicht der Aufwand eines echten Einsatzes. Und die Stanford-Angabe stützt sich auf dieselbe Datengrundlage von Epoch AI, ist also keine unabhängige zweite Bestätigung, sondern eine institutionelle Zweitverwendung.
Dazu kommt ein Detail, das selten erwähnt wird: Der AI Index des Jahres 2026 führt diese Kennzahl nicht fort. Eine Reihe, die abbricht, ist kein Beleg dafür, dass der Trend endete — sie ist jedoch ein Grund, ihn nicht ungeprüft in die Zukunft zu verlängern.
Der entscheidende Denkfehler liegt ohnehin woanders. Unternehmen halten kein Leistungsniveau fest. Sie nehmen das jeweils beste verfügbare Modell, weil das schwächere die Aufgabe nicht löst, und zahlen dessen aktuellen Preis. Beide Aussagen stimmen deshalb gleichzeitig: Ein eingefrorenes Niveau wird rapide billiger, und der laufende Betrieb wird trotzdem nicht günstig.
Der Preis je erledigtem Vorgang
Es gibt eine begutachtete Arbeit, die beides zugleich misst — Erfolg und Kosten. Eine Gruppe der Carnegie Mellon University und der Duke University hat dafür eine vollständige Firma nachgebaut und darin 175 realitätsnahe Büroaufgaben stellen lassen; die Ergebnisse erschienen 2025 auf der NeurIPS-Konferenz.
| System | Eigenständig gelöst | Kosten je Versuch | Anmerkung |
|---|---|---|---|
| Gemini 2.5 Pro | 30,3 % | 4,20 US-$ | bestes System; 39,3 % mit Teilpunkten, 27,2 Schritte im Mittel |
| Claude 3.7 Sonnet | 26,3 % | 4,10 US-$ | ähnlicher Preis, niedrigere Quote |
| Claude 3.5 Sonnet | 24,0 % | 6,30 US-$ | teurer als das bessere System |
| Gemini 2.0 Flash | 11,4 % | 0,60 US-$ | günstigster Versuchspreis im Feld |
| Gemini 1.5 Pro | 3,4 % | 6,80 US-$ | höchster Preis bei niedrigster Quote |
| offene Modelle | 5,7 bis 7,4 % | k. A. | Spanne über mehrere geprüfte Modelle |
Alle Werte stammen aus Tabelle 1 dieser Arbeit. Sie gelten für eine nachgebaute Firma, nicht für einen echten Betrieb, und sie umfassen ausschließlich Modellabfragen ohne Zwischenspeicherung, ohne Infrastruktur, ohne Aufsicht und ohne Nacharbeit.
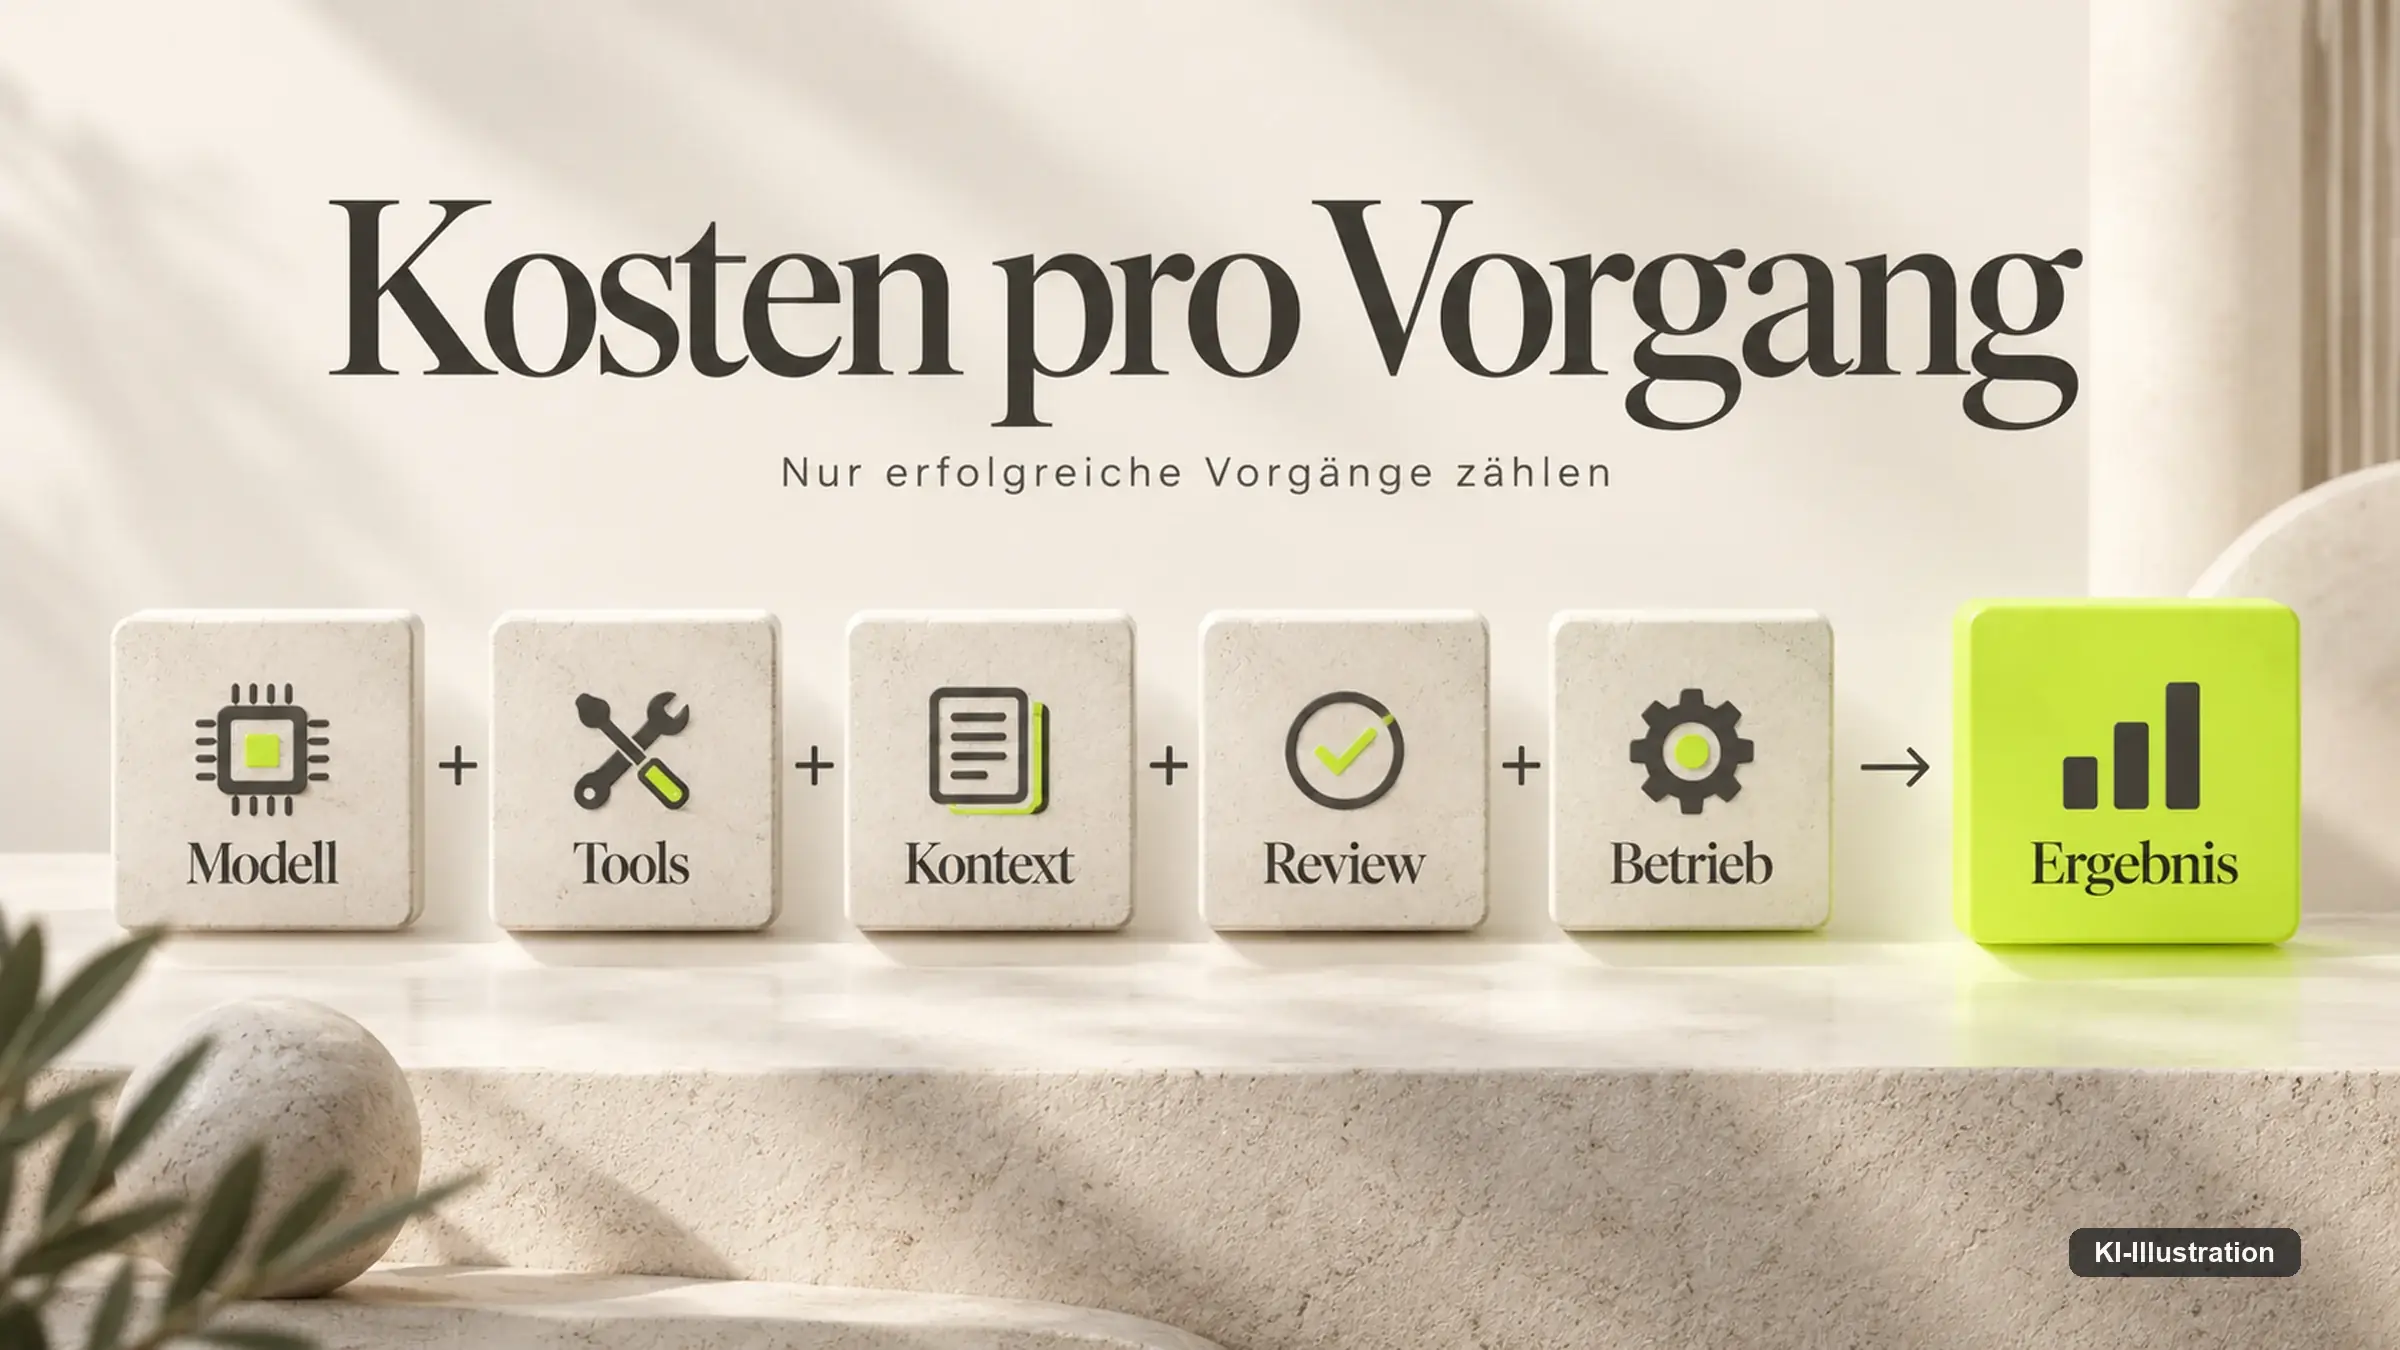
Aus diesen Werten folgt eine Zahl, die in keiner der Spalten steht. Bezahlt werden alle Versuche, die gescheiterten eingeschlossen. Wer wissen will, was eine erledigte Aufgabe kostet, muss die Erfolgsquote hineinrechnen: 4,20 US-Dollar geteilt durch 0,303 ergibt rund 13,90 US-Dollar je tatsächlich abgeschlossener Aufgabe. Diese Division ist eine Ableitung dieser Redaktion aus zwei Werten der Arbeit — sie steht so nicht in der Veröffentlichung und wird dort auch nicht behauptet.
Aus derselben Logik folgt, dass der günstigste Versuchspreis nicht den günstigsten Vorgang bedeutet. Ein Modell mit 0,60 US-Dollar je Versuch und 11,4 Prozent Erfolg erzeugt sehr viele bezahlte Versuche, bevor eine Aufgabe fertig ist, und jeder davon belegt außerdem Zeit und Aufmerksamkeit. Umgekehrt zeigt die Zeile mit 6,80 US-Dollar bei 3,4 Prozent, dass ein hoher Preis für sich genommen nichts über Qualität aussagt.
Was in der gemessenen Zahl nicht enthalten ist
Die 13,90 US-Dollar sind immer noch zu günstig, und zwar deutlich. Sie enthalten weder die Umgebung, in der ein Agent arbeitet, noch die Menschen, die seine Ergebnisse verantworten. Diese Posten tauchen in keiner Preisliste auf, weil sie nicht beim Modellanbieter anfallen, sondern im eigenen Haus.
| Kostenblock | Was ihn treibt | Woran er sich messen lässt |
|---|---|---|
| Kontextaufbau | Menge und Länge der Dokumente, die vor jeder Antwort herangezogen werden | Eingabe-Token je Vorgang, getrennt von der Ausgabe |
| Fehlversuche | Erfolgsquote und Zahl der Wiederholungen bis zum Abbruch | Verhältnis begonnener zu abgeschlossenen Vorgängen |
| Werkzeugaufrufe | Zahl der Schritte je Vorgang, Preise angebundener Dienste | Aufrufe je Vorgang, nach Zieldienst aufgeschlüsselt |
| Zwischenspeicherung | Anteil wiederverwendbarer Kontexte, Gültigkeitsdauer | Trefferquote des Zwischenspeichers |
| Menschliche Prüfung | Anteil der Vorgänge mit Freigabe- oder Sichtungspflicht | Bearbeitungsminuten je geprüftem Vorgang |
| Nacharbeit | Fehler, die erst nach der Freigabe auffallen | Rückläuferquote und Zeit bis zur Entdeckung |
| Protokollierung | Detailtiefe der Ablaufaufzeichnung, Aufbewahrungsfrist | Speichervolumen je Vorgang und Monat |
| Datenhaltung | Größe und Aktualisierungstakt der herangezogenen Bestände | Kosten je Indexlauf und je gespeichertem Gigabyte |
Entscheidend ist bei jedem dieser Blöcke die Messgröße. Solange ein Block keine eigene hat, erscheint er in keiner Auswertung, und was nicht erscheint, wird auch nicht verhandelt. Häuser, die ihre Modellkosten auf zwei Nachkommastellen kennen und die Prüfminuten ihrer Fachabteilung nicht, führen deshalb eine unvollständige Rechnung, obwohl sie sich gut dokumentiert vorkommen.
Auffällig ist, wie ungleich die Blöcke reagieren. Modellkosten fallen mit jedem Preisschritt der Anbieter, Prüfminuten dagegen fallen nur, wenn die Qualität der Ergebnisse steigt oder jemand die Prüfpflicht aufhebt. Der billiger werdende Teil und der teuer bleibende Teil der Rechnung folgen also verschiedenen Kurven, und im zweiten Jahr eines Betriebs entscheidet der zweite Teil.
Wovon die laufende Rechnung getrieben wird
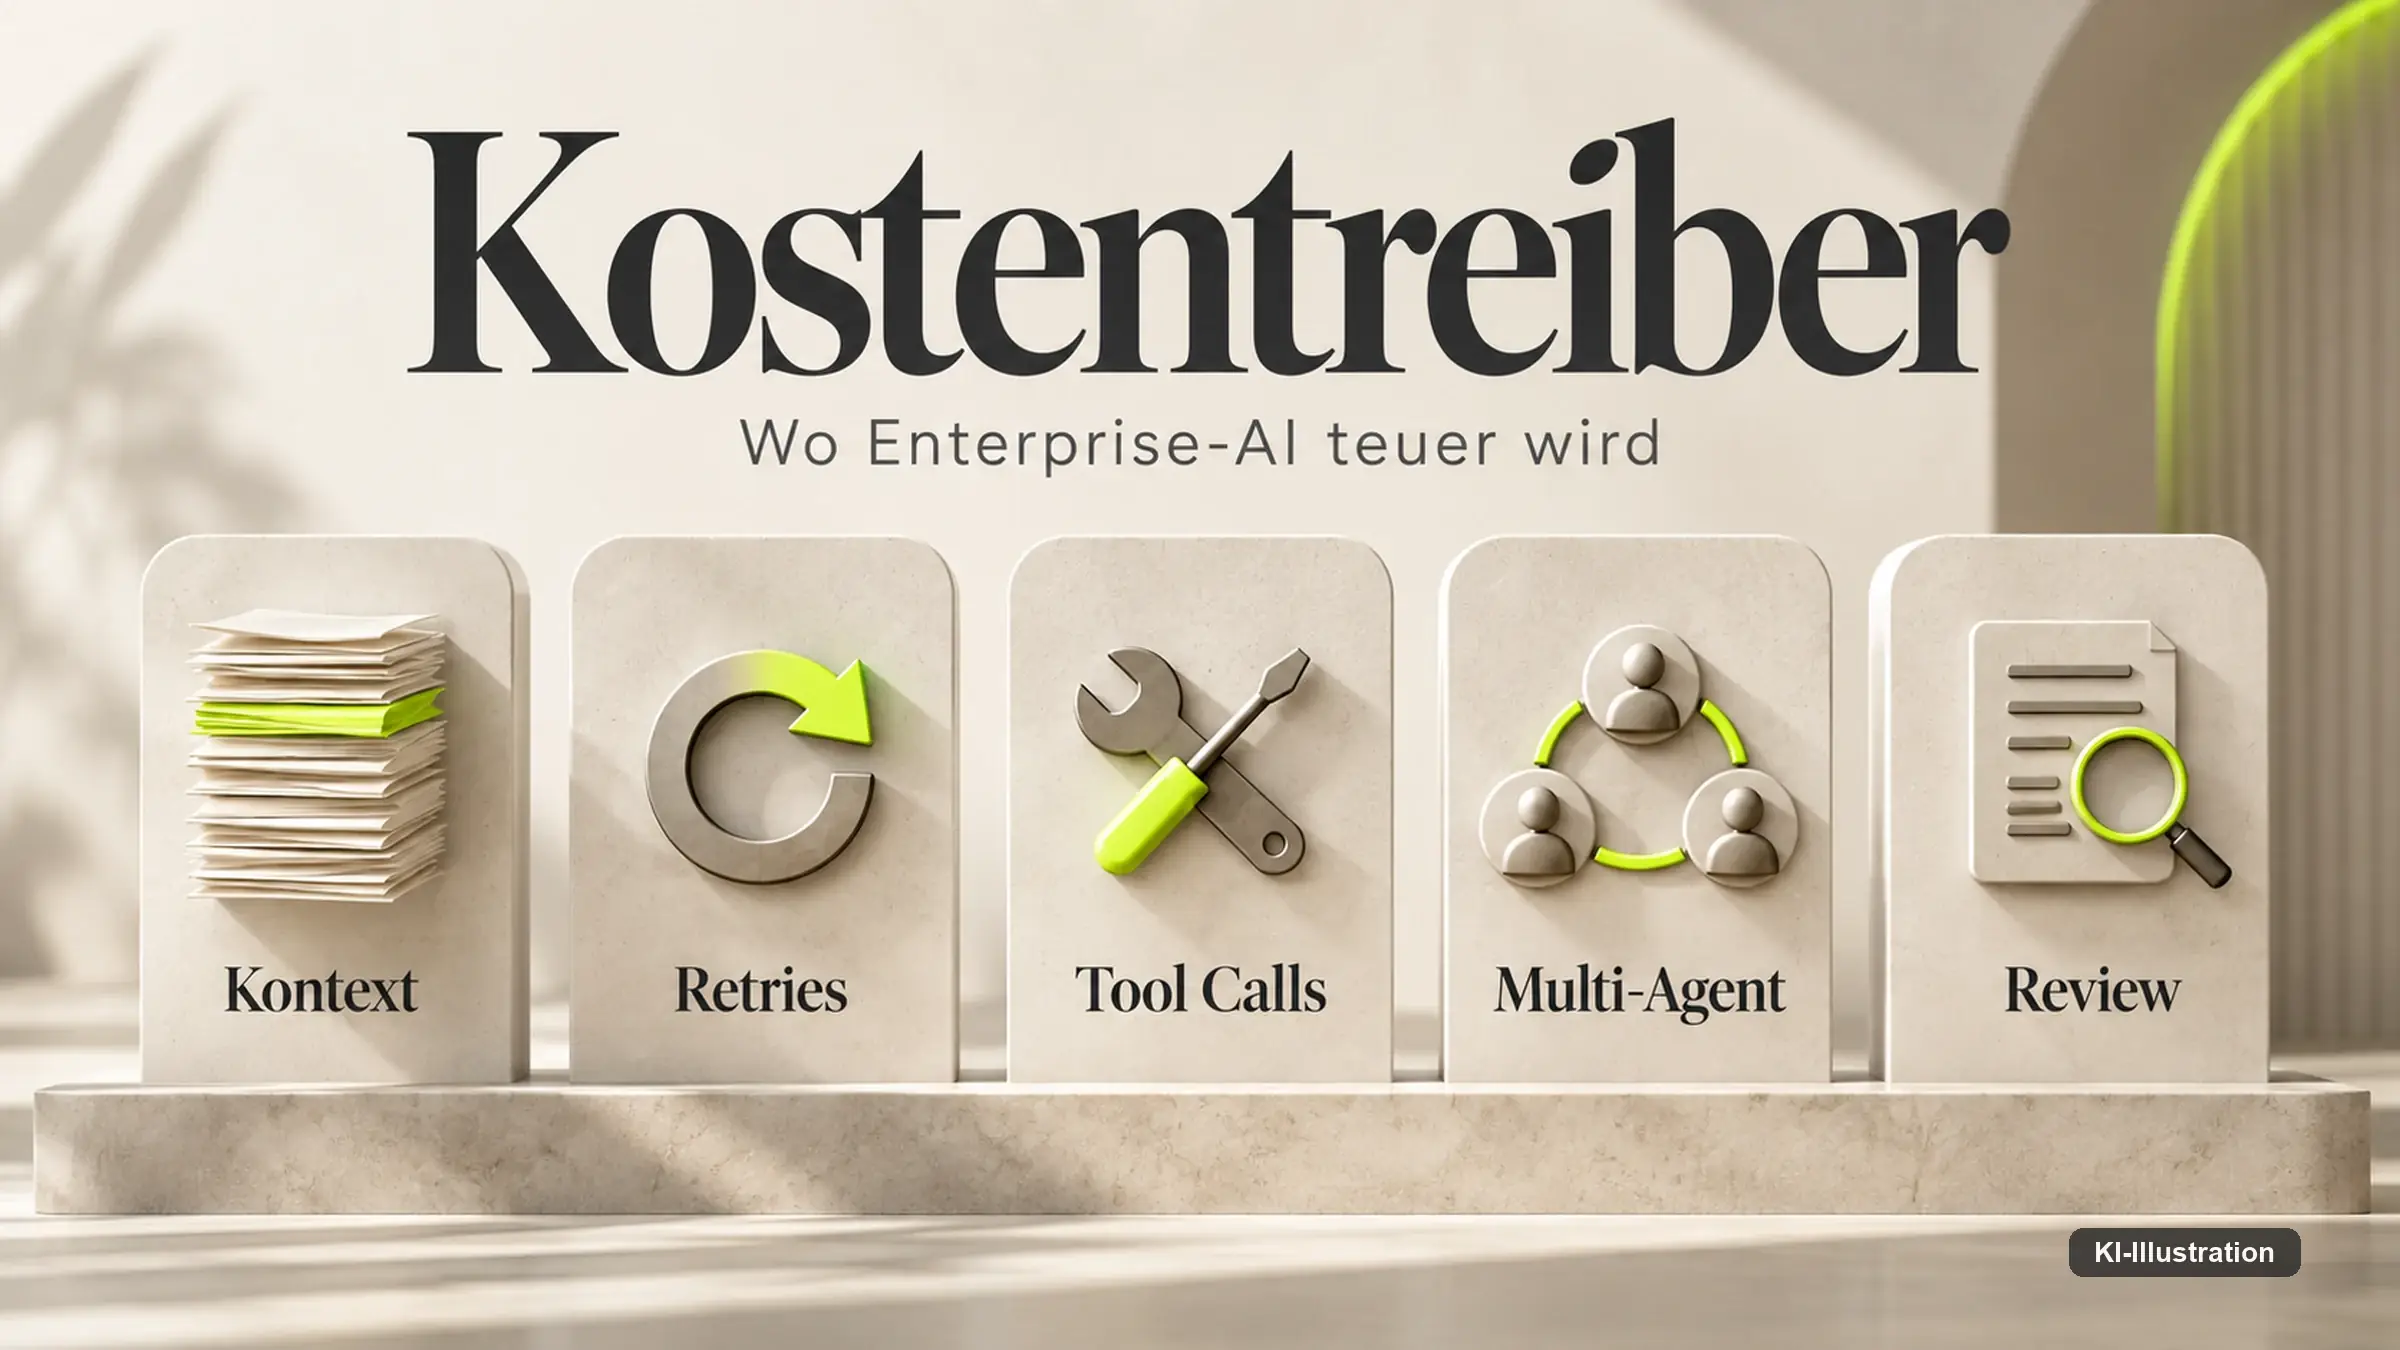
Die Kostenmessung der nachgebauten Firma nennt einen Wert, der leicht überlesen wird: 27,2 Schritte im Mittel je Versuch beim besten System. Ein Schritt ist eine Modellabfrage, und jede Abfrage trägt den bis dahin angesammelten Kontext mit. Die Rechnung wächst deshalb nicht mit der Zahl der Vorgänge, sondern mit der Zahl der Schritte je Vorgang.
Daraus folgt eine Kette, die sich im Betrieb selbst verstärkt. Ein längerer Kontext erhöht den Preis jedes weiteren Schritts, ein fehlgeschlagener Schritt erzeugt einen Wiederholversuch, und der Wiederholversuch verlängert den Kontext erneut. Wer nur die Zahl der bearbeiteten Anfragen hochrechnet, unterschätzt diesen Effekt, weil er linear plant, wo der Aufwand mit der Vorgangstiefe wächst.
Arbeiten mehrere Agenten zusammen, kommt eine Ebene hinzu. Jede Abstimmung zwischen zwei Agenten ist selbst eine Abfrage und wird als solche abgerechnet — das ist keine Messung, sondern eine Folge der Abrechnungslogik, aber sie erklärt, warum Architekturen mit vielen Beteiligten teurer werden, als die Summe ihrer Einzelaufgaben vermuten lässt.
Anbieterseitig gibt es Gegenmittel, und sie sind ernst zu nehmen, obwohl sie von interessierter Seite stammen. Amazon Web Services beschreibt in seiner Handreichung zu serverlosen agentischen Architekturen unter anderem, dass ein nachgeschalteter Prüfschritt die Ausgabe-Token um rund 25 Prozent senkt. Das ist eine Anbieterangabe ohne unabhängige Bestätigung, und sie erkauft die Ersparnis mit einer zusätzlichen Abfrage — ob sich das rechnet, hängt daran, was ein unentdeckter Fehler im eigenen Haus kostet.
Menschliche Prüfung ist kein Restposten
Bei einer Quote von 30,3 Prozent eigenständig gelöster Aufgaben ist die Frage nicht, ob ein Mensch nachsieht. Die Frage ist, wie viele Minuten das kostet und wer sie bezahlt.
Besonders unbequem wird es an der Stelle, an der die gemessenen Agenten am schlechtesten abschneiden: bei der Bedienung von Büro-Oberflächen und in Gesprächen mit simulierten Kolleginnen und Kollegen. Das sind ausgerechnet die Tätigkeiten, die Büroarbeit ausmachen. Wo ein System dort scheitert, fällt die Nacharbeit nicht an einer technischen Schnittstelle an, sondern bei der Fachkraft, deren Zeit der teuerste Posten der ganzen Kette ist.
Dazu kommt ein zweiter Posten, der schwerer zu fassen ist: der Fall, in dem niemand nachsieht und ein falsches Ergebnis weiterläuft. Seine Kosten entstehen verzögert, in einer anderen Abteilung und oft unter einer anderen Überschrift — als Reklamation, als Korrekturbuchung, als Nachverhandlung. Beziffern lässt er sich nicht seriös, sonst stünde er hier mit einer Zahl; ignorieren lässt er sich trotzdem nicht.
Ob sich der Prüfaufwand mittelfristig senken lässt, ist offen. In der McKinsey-Befragung vom 25. August 2026 berichten 80 Prozent der Befragten eine höhere persönliche Produktivität und 50 Prozent bessere Entscheidungen. Das sind Selbstauskünfte über das eigene Empfinden, keine gemessenen Durchlaufzeiten — als Beleg für einen sinkenden Prüfaufwand taugen sie nicht, wohl aber als Hinweis darauf, dass die Wahrnehmung im Haus günstiger ausfällt als die Abrechnung.
Strom, Rechenzentrum und die Grenze dieser Kennzahl
Eine naheliegende Idee ist, die Kosten über den Energieverbrauch zu schätzen. Dafür gibt es gemessene Werte, und sie sind aufschlussreich — nur beantworten sie eine andere Frage als die nach dem Geld.
Eine Arbeit aus der Zusammenarbeit von Hugging Face und der Carnegie Mellon University, veröffentlicht auf der ACM-Konferenz FAccT 2024, hat den Verbrauch je 1.000 Abfragen gemessen: 0,002 Kilowattstunden für Textklassifikation, 0,047 für Textgenerierung, 0,049 für Zusammenfassungen und 2,907 für Bildgenerierung. Bildgenerierung ist damit rund 1.450-mal energieintensiver als Klassifikation.
Die Einschränkungen sind erheblich. Sämtliche Läufe fanden auf einer einzelnen NVIDIA A100 in einer AWS-Region statt, Stand 2023; moderne Verfahren sind darin nicht abgebildet, und die Absolutwerte dürften heute zu hoch liegen. Belastbar bleibt das Verhältnis zwischen den Aufgabenarten, nicht die einzelne Zahl.
Auf der großen Skala liefert die Internationale Energieagentur den Rahmen. In ihrem Bericht vom 10. April 2025 verbrauchten Rechenzentren weltweit 2024 rund 415 Terawattstunden, etwa 1,5 Prozent des globalen Stroms, bei rund 12 Prozent Wachstum jährlich über die vorangegangenen fünf Jahre; im Basisszenario sind es bis 2030 etwa 945 Terawattstunden und knapp 3 Prozent. Das ist eine Modellrechnung, keine Messung, und sie betrifft Rechenzentren insgesamt, nicht allein KI.
Für die eigene Kalkulation folgt daraus vor allem eines: Energie ist ein Argument in der Nachhaltigkeitsberichterstattung und ein Kostentreiber beim Betreiber der Anlage. Wer Modelle über eine Schnittstelle bezieht, zahlt sie eingepreist mit und kann sie nicht getrennt steuern.
Der Widerspruch: Kosten stehen nicht auf der Hinderungsliste
An dieser Stelle steht ein Befund, der der Erzählung dieses Beitrags widerspricht, und er gehört genau deshalb hierher.
Nach Eurostat setzten 2025 rund 19,95 Prozent der Unternehmen in der EU KI ein, nach 13,48 Prozent im Jahr davor. Die Spreizung ist erheblich: 42,03 Prozent in Dänemark gegen 5,21 Prozent in Rumänien, 17 Prozent bei kleinen, 30,36 bei mittleren und 55,03 Prozent bei großen Unternehmen. Als Hinderungsgründe nennen Unternehmen fehlendes Fachwissen mit 70,89 Prozent, Unklarheit über die Rechtsfolgen mit 52,52 Prozent, Datenschutzbedenken mit 48,83 Prozent und mangelnden Nutzen mit 20,68 Prozent. Kosten führt diese Aufstellung nicht auf.
Wer also glaubt, der Engpass in Europa sei der Preis, findet dafür in der amtlichen Statistik keine Bestätigung. Es fehlt nach dieser Erhebung vor allem an Menschen, die es können, und an Klarheit darüber, was erlaubt ist.
Zwei Lesarten liegen nahe, und beide sind Deutung dieser Redaktion, nicht Befund der Statistik. Die eine: Kosten werden zum Thema erst, wenn ein System läuft — wer am fehlenden Fachwissen scheitert, kommt nie so weit, dass ihn die Abrechnung stört. Die andere: Was Unternehmen als Hindernis benennen, hängt davon ab, was sie an sich selbst gelten lassen wollen, denn fehlendes Geld ist eine unangenehmere Auskunft als fehlendes Personal. Ein Posten fehlt in den meisten Aufstellungen: der Prüfaufwand, den kein Datenblatt ausweist.
Für die erste Lesart spricht ein Wert aus der McKinsey-Befragung desselben Zeitraums: 20 Prozent der Befragten geben an, dass die laufenden KI-Betriebskosten einschließlich der Kosten für verarbeitete Token ihren Einsatz begrenzt haben. Das sind Unternehmen, die bereits betreiben. Entschieden ist damit nichts, weil die beiden Erhebungen verschiedene Gruppen mit verschiedenen Methoden befragen — aber die Kostenfrage verschwindet nicht, sie verschiebt sich hinter die Einstiegshürde.
Was sich steuern lässt und wer es steuert
Die Prognose von Gartner vom 25. Juni 2025 nennt drei Gründe, aus denen mehr als 40 Prozent der agentischen KI-Projekte bis Ende 2027 abgebrochen würden: steigende Kosten, unklarer Geschäftswert, unzureichende Risikokontrolle. Steigende Kosten stehen dort an erster Stelle. Es handelt sich um die Prognose eines kommerziellen Analystenhauses, nicht um eine Messung, und ihr Zeithorizont liegt noch vor uns.
Bemerkenswert ist die zweite Zahl derselben Mitteilung. Von mehreren Tausend Anbietern, die sich agentisch nennen, liefern nach Gartner-Schätzung nur rund 130 tatsächlich agentische Fähigkeiten. Wer für eine Funktion zahlt, die im Kern eine Ablaufsteuerung mit angeschlossenem Sprachmodell ist, kauft die Kostenstruktur eines Agenten ohne dessen Leistung.
Auf der Steuerungsseite hat sich eine eigene Praxis gebildet. Die FinOps Foundation, ein Branchenverband aus Anbieter- und Anwenderseite, hält als Grundgedanken fest, das Budget vor dem Start festzulegen statt im Nachhinein zu erklären. Amazon Web Services beschreibt für seine eigene Plattform ein Bündel an Stellschrauben, vom Modellzuschnitt über die Zwischenspeicherung bis zur Begrenzung der Ausgabelänge; das sind Anbieterhinweise für eine Anbieterumgebung, und die zugehörige architektonische Handreichung bleibt ausdrücklich bei Prinzipien, ohne Zahlen zu nennen.
Praktisch entscheidet die Zuordnung im Haus mehr als jede einzelne Stellschraube. Kosten entstehen dort, wo jemand einen Vorgang auslöst, und die Rechnung landet dort, wo die Plattform betrieben wird. Fallen beide auseinander, steuert die eine Seite ein Volumen, das die andere bezahlt — und keine der beiden hat dann einen Anlass, die Schritte je Vorgang zu senken.
Woran eine belastbare Kostenaussage zu erkennen ist
Eine Kostenangabe ist dann belastbar, wenn sie sich auf erledigte Vorgänge bezieht und die Erfolgsquote offenlegt, aus der sie gebildet wurde. Fehlt die Quote, ist die Zahl nicht falsch, sondern bedeutungslos — sie beschreibt einen Versuch, und Versuche sind beliebig vermehrbar.
Die zweite Angabe, nach der sich zu fragen lohnt, ist die Zahl der Schritte je Vorgang. Sie ist die Brücke zwischen Fachlichkeit und Rechnung: Wer sie kennt, kann abschätzen, wie stark die Kosten steigen, wenn ein Vorgang komplizierter wird, ohne auf die nächste Abrechnung zu warten.
Die dritte betrifft die Prüfseite. Welcher Anteil der Vorgänge geht durch menschliche Hände, wie viele Minuten dauert das, und wie oft kommt ein freigegebenes Ergebnis zurück? Diese drei Werte entscheiden über die Wirtschaftlichkeit häufiger als die Wahl des Modells, weil sie den einzigen Posten betreffen, der nicht mit der Preisliste fällt.
Der Rest ist Buchführung mit Verfallsdatum. Angesichts eines Preisverfalls um das Neun- bis Neunhundertfache pro Jahr und angesichts einer Vergleichsmessung, deren Modellstand bereits zurückliegt, hält keine Kostenannahme in diesem Feld ein Geschäftsjahr durch. Jede Annahme trägt deshalb sinnvollerweise ein Abrufdatum und den Modellstand, auf den sie sich bezieht.
Was auf einer Konferenzbühne dazu zu hören sein wird, lässt sich vorher nicht sagen — dieser Beitrag entstand vor Beginn der Veranstaltung und referiert keine Aussage von dort. Belastbar wird die Kostenfrage ohnehin erst mit Zahlen aus dem eigenen Haus. Sobald Betriebsbelege vorliegen und nicht nur Aussagen über den Betrieb, tragen wir sie nach.
Quellen. Alle Adressen wurden am 13. September 2026 geprüft. Wo eine Seite automatisierte Abrufe abweist, wurde sie im Browser geöffnet und der Inhalt gegen die Nennung abgeglichen.
- Epoch AI, LLM inference price trends, 12. März 2025; Listenpreise für ein eingefrorenes Leistungsniveau.
- Stanford Institute for Human-Centered AI, AI Index Report 2025; stützt sich für die Inferenzkosten auf dieselbe Datengrundlage wie Epoch AI.
- Xu et al., TheAgentCompany: Benchmarking LLM Agents on Consequential Real World Tasks, Carnegie Mellon University und Duke University, NeurIPS 2025; Tabelle 1 mit Erfolgsquoten, Schrittzahlen und Kosten je Versuch.
- Luccioni, Jernite und Strubell, Power Hungry Processing: Watts Driving the Cost of AI Deployment?, ACM FAccT 2024; gemessen auf einer NVIDIA A100, Stand 2023.
- Internationale Energieagentur, Energy and AI: Energy demand from AI, 10. April 2025; Szenariorechnung für Rechenzentren insgesamt.
- Eurostat, Use of artificial intelligence in enterprises, Datenstand Dezember 2025.
- McKinsey & Company, The state of AI, 25. August 2026; Befragung mit Selbstauskünften.
- Gartner, Over 40% of Agentic AI Projects Will Be Canceled by End of 2027, 25. Juni 2025; Prognose eines kommerziellen Analystenhauses.
- Amazon Web Services (Anbieterquelle), Cost optimization für serverlose agentische Architekturen, dazu Kostensenkung bei Amazon Bedrock und der Well-Architected Generative AI Lens, der ausschließlich Prinzipien nennt.
- FinOps Foundation (Branchenverband), Setting an AI budget.
- HumanX Europe 2026, Programm; Titel, Zeiten und Beteiligte der angekündigten Programmpunkte.
Die Angaben sind eine redaktionelle Einordnung und keine Anlage-, Steuer- oder Rechtsberatung. Preise und Modellstände ändern sich laufend; alle genannten Werte gelten zum jeweils angegebenen Datum und ohne Gewähr.
Welche Angaben braucht es, damit sich die Kosten zweier Angebote vergleichen lassen?
Drei: die Erfolgsquote über einen längeren Zeitraum, die durchschnittliche Zahl der Schritte je Vorgang und den Anteil der Vorgänge, die durch menschliche Hände gehen. Ohne diese drei Werte lässt sich ein Preis je Abfrage nicht in einen Preis je Vorgang überführen, und nur der Preis je Vorgang ist zwischen zwei Anbietern vergleichbar.
Fallen auch für abgebrochene Durchläufe Kosten an?
Ja. Abgerechnet wird je verarbeitetem Token, unabhängig davon, ob ein Vorgang zum Ergebnis führt. In der begutachteten Messung mit 175 Büroaufgaben brauchte das beste System im Mittel 27,2 Schritte je Versuch — jeder dieser Schritte ist eine bezahlte Abfrage, auch in den Versuchen, die scheitern.
Wie schnell veralten Kostenannahmen für den KI-Betrieb?
Schneller als ein Geschäftsjahr. Für ein festgehaltenes Leistungsniveau fiel der Preis je nach Aufgabe um das Neun- bis Neunhundertfache pro Jahr, und die Modellstände verfügbarer Vergleichsmessungen liegen regelmäßig ein bis zwei Jahre zurück. Jede Annahme sollte deshalb ein Abrufdatum und den Modellstand tragen, auf den sie sich bezieht.
Senkt ein zusätzlicher Prüfschritt die Kosten oder erhöht er sie?
Beides zugleich. Amazon Web Services gibt für serverlose agentische Architekturen an, dass ein nachgeschalteter Prüfschritt die Ausgabe-Token um rund 25 Prozent senkt; das ist eine Anbieterangabe ohne unabhängige Bestätigung. Zugleich ist der Prüfschritt selbst eine zusätzliche Abfrage. Ob er sich rechnet, hängt daran, was ein unentdeckter Fehler im eigenen Haus kostet.
Was bringt Zwischenspeicherung, und warum fehlt sie in den Messwerten?
Die veröffentlichten Kosten je Versuch sind ausdrücklich ohne Zwischenspeicherung gerechnet. Wo sich Kontexte zwischen Vorgängen wiederverwenden lassen, sinkt der Eingabeanteil der Rechnung, weshalb die gemessenen Werte für diesen Posten eher eine Obergrenze darstellen. Wie groß der Effekt im eigenen Haus ausfällt, zeigt allein die Trefferquote des eigenen Zwischenspeichers.
Lässt sich der Stromverbrauch eines KI-Systems in Kosten umrechnen?
Nicht direkt. Die vorliegenden Messungen weisen Energie je 1.000 Abfragen aus, etwa 0,047 Kilowattstunden für Textgenerierung, nicht Geld. Zwischen Kilowattstunde und Rechnung liegen Strompreis, Auslastung und Vertragsform. Wer Modelle über eine Schnittstelle bezieht, zahlt die Energie eingepreist mit und kann sie nicht getrennt steuern.
Gilt der Eurostat-Befund zu den Hinderungsgründen auch für Unternehmen, die KI bereits betreiben?
Das ist offen. Die Eurostat-Aufstellung nennt fehlendes Fachwissen, unklare Rechtsfolgen und Datenschutzbedenken, nicht aber Kosten. In der McKinsey-Befragung geben dagegen 20 Prozent an, laufende Betriebskosten hätten ihren Einsatz begrenzt — das sind Häuser, die bereits betreiben. Die beiden Erhebungen befragen verschiedene Gruppen mit verschiedenen Methoden, ein Widerspruch lässt sich daraus nicht auflösen.
Wer im Unternehmen sollte die Kosten eines Agentenbetriebs verantworten?
Sinnvollerweise die Stelle, die das Volumen auslöst, nicht nur die, auf deren Konto die Rechnung läuft. Fallen beide auseinander, steuert der Fachbereich die Zahl der Vorgänge und die Plattformseite bezahlt sie, und keine der beiden Seiten hat einen Anlass, die Schritte je Vorgang zu senken. Der Branchenverband FinOps Foundation hält als Grundgedanken fest, das Budget vor dem Start festzulegen.
Wie ändert sich die Rechnung, wenn mehrere Agenten zusammenarbeiten?
Sie wächst stärker, als die Summe der Einzelaufgaben vermuten lässt. Jede Abstimmung zwischen zwei Agenten ist selbst eine Abfrage und wird als solche abgerechnet; das ist keine Messung, sondern eine Folge der Abrechnungslogik. Da die Kosten an der Zahl der Schritte hängen und nicht an der Zahl der Vorgänge, verteuert jede zusätzliche Beteiligung denselben fachlichen Vorgang.