News & Markt · Analyse
Warum KI-Piloten scheitern — und was zwischen Machbarkeitsnachweis und Betrieb wirklich fehlt
Kurz gesagt: Ein Machbarkeitsnachweis beweist, dass etwas möglich ist, und sonst nichts — weder den Wert noch die Datenlage, weder die Integration noch die Beherrschbarkeit der Risiken noch die Betreibbarkeit. Daran entscheidet sich hinterher alles. Die härteste Zahl dazu stammt aus der McKinsey-Befragung vom 25. August 2026: Der Anteil der Großunternehmen, die KI-Agenten skalieren, stieg binnen eines Jahres von 27 auf 40 Prozent, während der gemeldete Beitrag zum operativen Ergebnis bei 37 Prozent praktisch unverändert blieb.
Der Nachweis gelingt, und trotzdem passiert nichts
Ein Machbarkeitsnachweis läuft fast immer gut, denn er ist so gebaut, dass er gut läuft: eine ausgewählte Aufgabe, ein aufgeräumter Datenausschnitt, ein kleines Team, das jeden Fehlversuch persönlich kennt und ihn im Vorbeigehen nachbessert. Am Ende steht eine Zahl, über die niemand streitet. Dann beginnt das Jahr, in dem nichts weiter geschieht.
Wer das einmal mitgemacht hat, erkennt es beim zweiten Mal an den Formulierungen: Aus „wir gehen in den Betrieb“ wird „wir erweitern den Piloten“, und irgendwann fragt niemand mehr nach der ursprünglichen Zahl. Vorhaben dieser Art sterben selten an einer Entscheidung, sondern an deren Ausbleiben.
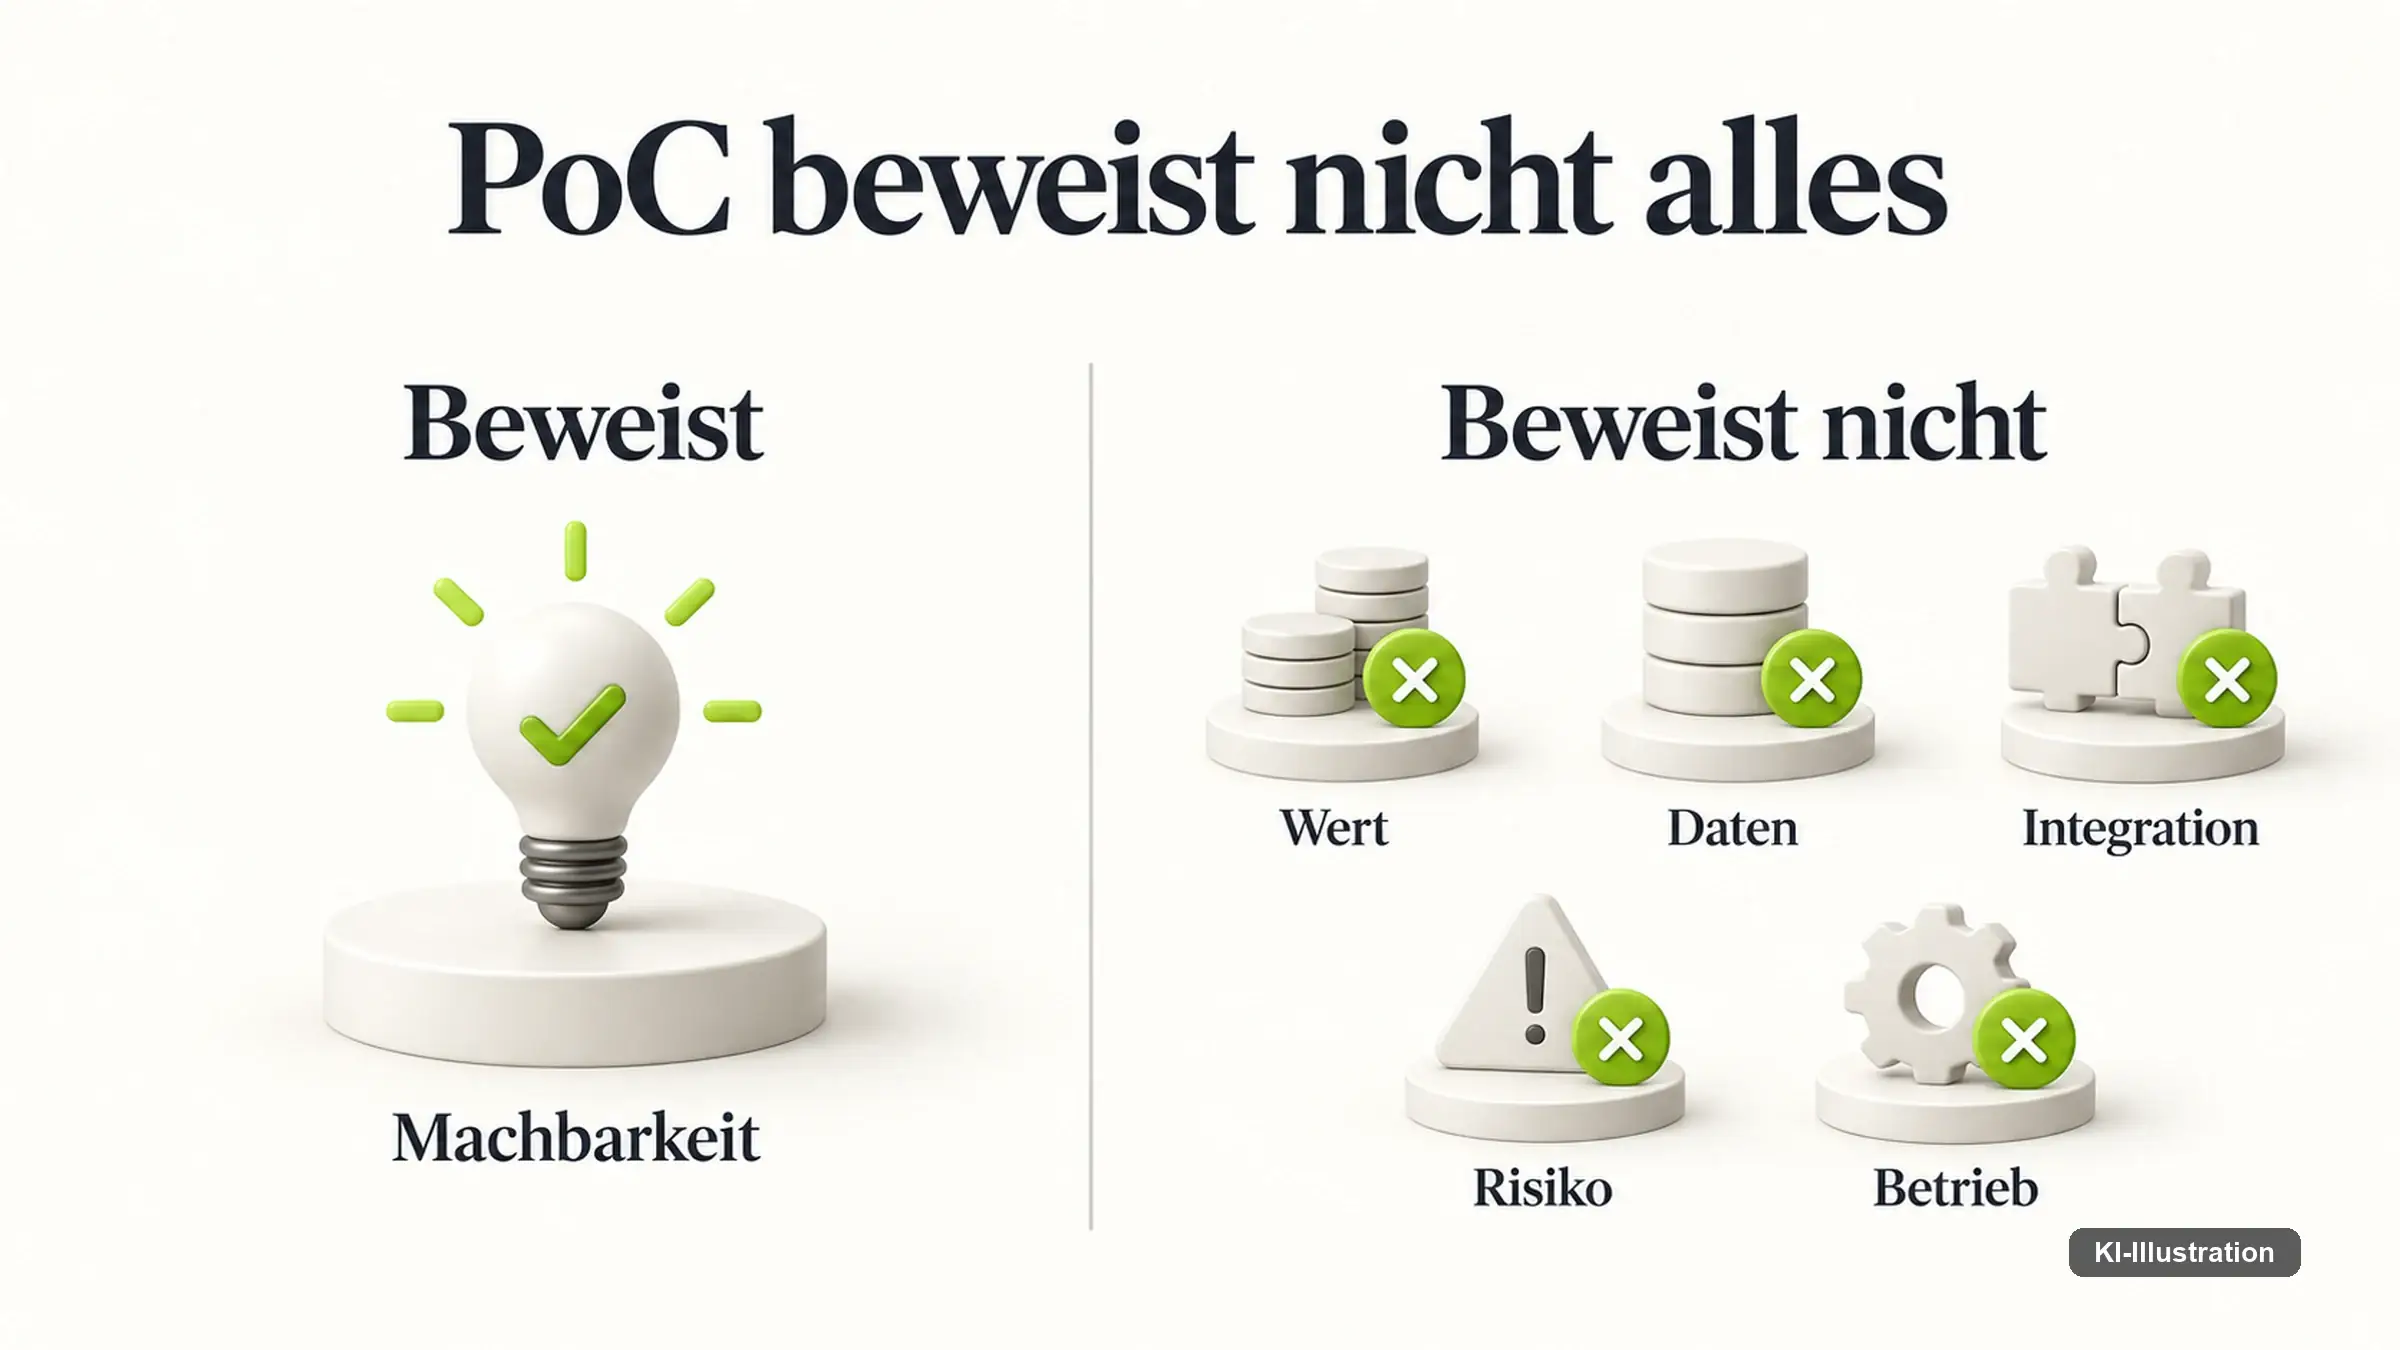
Die These dieses Beitrags ist deshalb unbequem für jeden, der auf einen guten Nachweis stolz ist: Ein Machbarkeitsnachweis beweist Machbarkeit — und sonst nichts. Er beweist weder, dass die Sache Wert schafft, noch dass die Daten außerhalb des Testausschnitts tragen, noch dass sich das System in die vorhandene Landschaft fügt, noch dass die Risiken beherrschbar sind, noch dass irgendjemand den laufenden Betrieb verantworten will. Diese fünf Fragen entscheiden hinterher über alles, und keine davon wird im Pilot gestellt, weil der Pilot dafür nicht gebaut wurde.
Dagegen lässt sich mit gutem Recht einwenden, dass jede neue Technik eine Anlaufzeit hat: Rechenzentren und Warenwirtschaftssysteme brauchten ebenfalls Jahre, bis ihr Nutzen in einer Bilanz sichtbar wurde. Dieser Einwand ist ernst zu nehmen und erklärt einen Teil des Befunds. Er erklärt jedoch nicht, warum ausgerechnet die Häuser, die am weitesten sind, im zweiten Jahr dasselbe berichten wie im ersten.
Mehr Betrieb, gleiches Ergebnis
Am 25. August 2026 hat die Unternehmensberatung McKinsey ihre jährliche Befragung zum Stand der KI veröffentlicht. Zwei Werte daraus gehören nebeneinandergelegt, auch wenn sie in der Darstellung weit auseinanderstehen.
Die eine Zahl: 40 Prozent der befragten Großunternehmen mit mehr als einer Milliarde US-Dollar Jahresumsatz geben an, KI-Agenten zu skalieren, nach 27 Prozent im Jahr davor. Bei kleineren Organisationen liegt derselbe Wert unverändert bei 22 Prozent, der gesamte Zuwachs ist also oben angefallen. Die andere Zahl: 37 Prozent berichten einen Beitrag der KI zum operativen Ergebnis, gegenüber dem Vorjahr praktisch unverändert.
Dreizehn Prozentpunkte mehr Betrieb bei den Großen, null Prozentpunkte mehr gemeldetes Ergebnis. Das ist der härteste Befund, den dieses Material hergibt, und er lässt sich nicht wegdiskutieren, sondern nur deuten.
Mindestens vier Deutungen kommen infrage, und sie schließen einander nicht aus. Ergebnisbeiträge können nachlaufen, weil zwischen der ersten produktiven Woche und einer sichtbaren Zeile in der Kostenrechnung Quartale liegen. Die neu hinzugekommenen Häuser könnten schwächere Fälle skalieren als die Vorreiter des Vorjahres, sodass der Durchschnitt trotz mehr Betrieb stehen bleibt. Möglich ist auch, dass „skalieren“ in einer Selbstauskunft alles Mögliche bedeutet, von einem konzernweit ausgerollten Assistenten bis zu drei Abteilungen mit Zugang. Und schließlich kann der Nutzen real sein, aber an einer Stelle anfallen, die keine Ergebnisrechnung erfasst.
Für die letzte Lesart spricht ein dritter Wert derselben Erhebung: 80 Prozent berichten eine höhere persönliche Produktivität, 50 Prozent bessere Entscheidungen. Zwischen diesen 80 Prozent und den 37 Prozent mit Ergebnisbeitrag klafft der eigentliche Abstand. Gefühlte Entlastung ist keine eingesparte Stunde, und eine eingesparte Stunde ist kein eingesparter Euro, solange niemand entscheidet, was mit der Stunde geschieht.
All das bleibt eine Befragung und damit eine Sammlung von Selbstauskünften, die niemand nachprüft. Dass ausgerechnet der Abstand zwischen zwei Antworten desselben Fragebogens so stabil bleibt, während die Verbreitung springt, ist deshalb aussagekräftiger als jeder Einzelwert.
Was ein Machbarkeitsnachweis belegt und was offen bleibt
Die fünf ungestellten Fragen lohnen den Einzeldurchgang, weil sie sich darin unterscheiden, wie teuer ihre späte Beantwortung wird.
| Feld | Was der Nachweis zeigt | Frage, die im Pilot meist nicht gestellt wurde | Woran die Antwort erkennbar wird |
|---|---|---|---|
| Machbarkeit | Das System löst die gezeigte Aufgabe unter den gezeigten Bedingungen. | Löst es sie auch beim zehnten Anlauf mit fremden Eingaben? | Wiederholte Läufe desselben Vorgangs, ausgezählt statt vorgeführt |
| Wert | Eine Aufgabe wird schneller erledigt. | Wird dadurch anderswo etwas weniger — Kosten, Durchlaufzeit, Fehlerquote? | Eine Kennzahl, die schon vor dem Pilot erhoben wurde |
| Datenlage | Der vorbereitete Ausschnitt reicht für die Aufgabe. | Was geschieht bei Lücken, Dubletten und veralteten Ständen? | Verhalten bei fehlender Information: Antwort oder Enthaltung |
| Integration | Das System greift auf die für die Vorführung geöffneten Quellen zu. | Wer vergibt die Rechte im Regelbetrieb, unter welcher Identität handelt der Agent? | Eigene Kennung mit engstem nötigem Zugriff, nicht die eines Menschen |
| Risiko | Im Testzeitraum ist nichts Schlimmes passiert. | Was passiert, wenn das System falsch liegt, und wer merkt es wann? | Protokoll über jeden Schritt, festgelegter Weg zum Menschen |
| Betrieb | Das Projektteam hält das System am Laufen. | Wer betreibt es in zwei Jahren, mit welchem Budget und welcher Rufbereitschaft? | Eine benannte Zuständigkeit außerhalb des Projektteams |
Die Spalte ganz rechts ist der praktische Teil: Jede dieser Antworten lässt sich mit Aufwand beschaffen, aber keine nachträglich behaupten, weil sie an Daten hängt, die man entweder erhoben hat oder nicht.
Besonders unterschätzt wird die zweite Zeile. Ein Pilot misst fast immer die Fähigkeit des Systems und selten die Veränderung im Haus, und diese beiden Größen fallen weit auseinander: Eine Bearbeitungszeit kann sinken, während die Durchlaufzeit gleich bleibt, weil der Vorgang danach ohnehin drei Tage auf eine Freigabe wartet. Wer keine Kennzahl aus der Zeit vor dem Pilot hat, kann den Unterschied hinterher nicht mehr zeigen.
Wo die Fehler tatsächlich sitzen
Über die Fähigkeit heutiger Agenten gibt es nicht nur Meinungen, sondern auch Messungen. Eine Gruppe der Carnegie Mellon University und der Duke University hat eine vollständige Firma nachgebaut — eigene Chat-Plattform, eigene Dateiablage, simulierte Kolleginnen und Kollegen — und darin 175 realitätsnahe Büroaufgaben stellen lassen. Die Arbeit erschien 2025 auf der NeurIPS-Konferenz und ist begutachtet.
Das beste geprüfte System erledigte 30,3 Prozent der Aufgaben eigenständig bis zum Ende, mit angerechneten Teilerfolgen 39,3 Prozent. Die nächstbesten lagen bei 26,3 und 24,0 Prozent, offene Modelle zwischen 5,7 und 7,4 Prozent. Am schlechtesten schnitten alle dort ab, wo eine Büro-Oberfläche zu bedienen war und wo mit simulierten Menschen gesprochen werden musste — also bei den beiden Tätigkeiten, aus denen Büroarbeit zu weiten Teilen besteht.
Diese Zahlen stammen aus einer nachgebauten Umgebung und lassen sich nicht auf ein konkretes Haus übertragen. Als Größenordnung sind sie trotzdem unbequem: Wenn ein gutes System sieben von zehn realistischen Aufgaben nicht allein zu Ende bringt, lautet die entscheidende Frage nicht, ob ein Mensch nachsieht, sondern wie der Betrieb organisiert wird, in dem er das tut.
Das Sky Computing Lab der University of California in Berkeley hat parallel mehr als 1.600 annotierte Ausführungsspuren aus sieben verbreiteten Rahmenwerken für Multi-Agenten-Systeme ausgewertet und daraus 14 Fehlermodi in drei Kategorien abgeleitet, bei einer Übereinstimmung der Annotierenden von 0,88 nach Kappa. Wichtig ist, was diese Arbeit nicht liefert: Sie ordnet Fehler, sie zählt sie nicht. Aus ihr folgt weder eine Fehlerrate noch die Aussage, mehrere zusammenarbeitende Agenten scheiterten häufiger als ein einzelner.
Der Erkenntnisgewinn liegt anderswo. Dass sich beobachtete Fehlschläge überhaupt in vierzehn wiederkehrende Muster sortieren lassen, spricht dafür, dass ein erheblicher Teil nicht am Modell hängt, sondern am Aufbau darum herum — an unklaren Zuständigkeiten zwischen Komponenten, an abgebrochener Weitergabe, an Abbruchbedingungen, die niemand gesetzt hat. Solche Fehler verschwinden nicht, wenn das nächste Modell erscheint.
Sieben Prüfpunkte vor der Skalierung
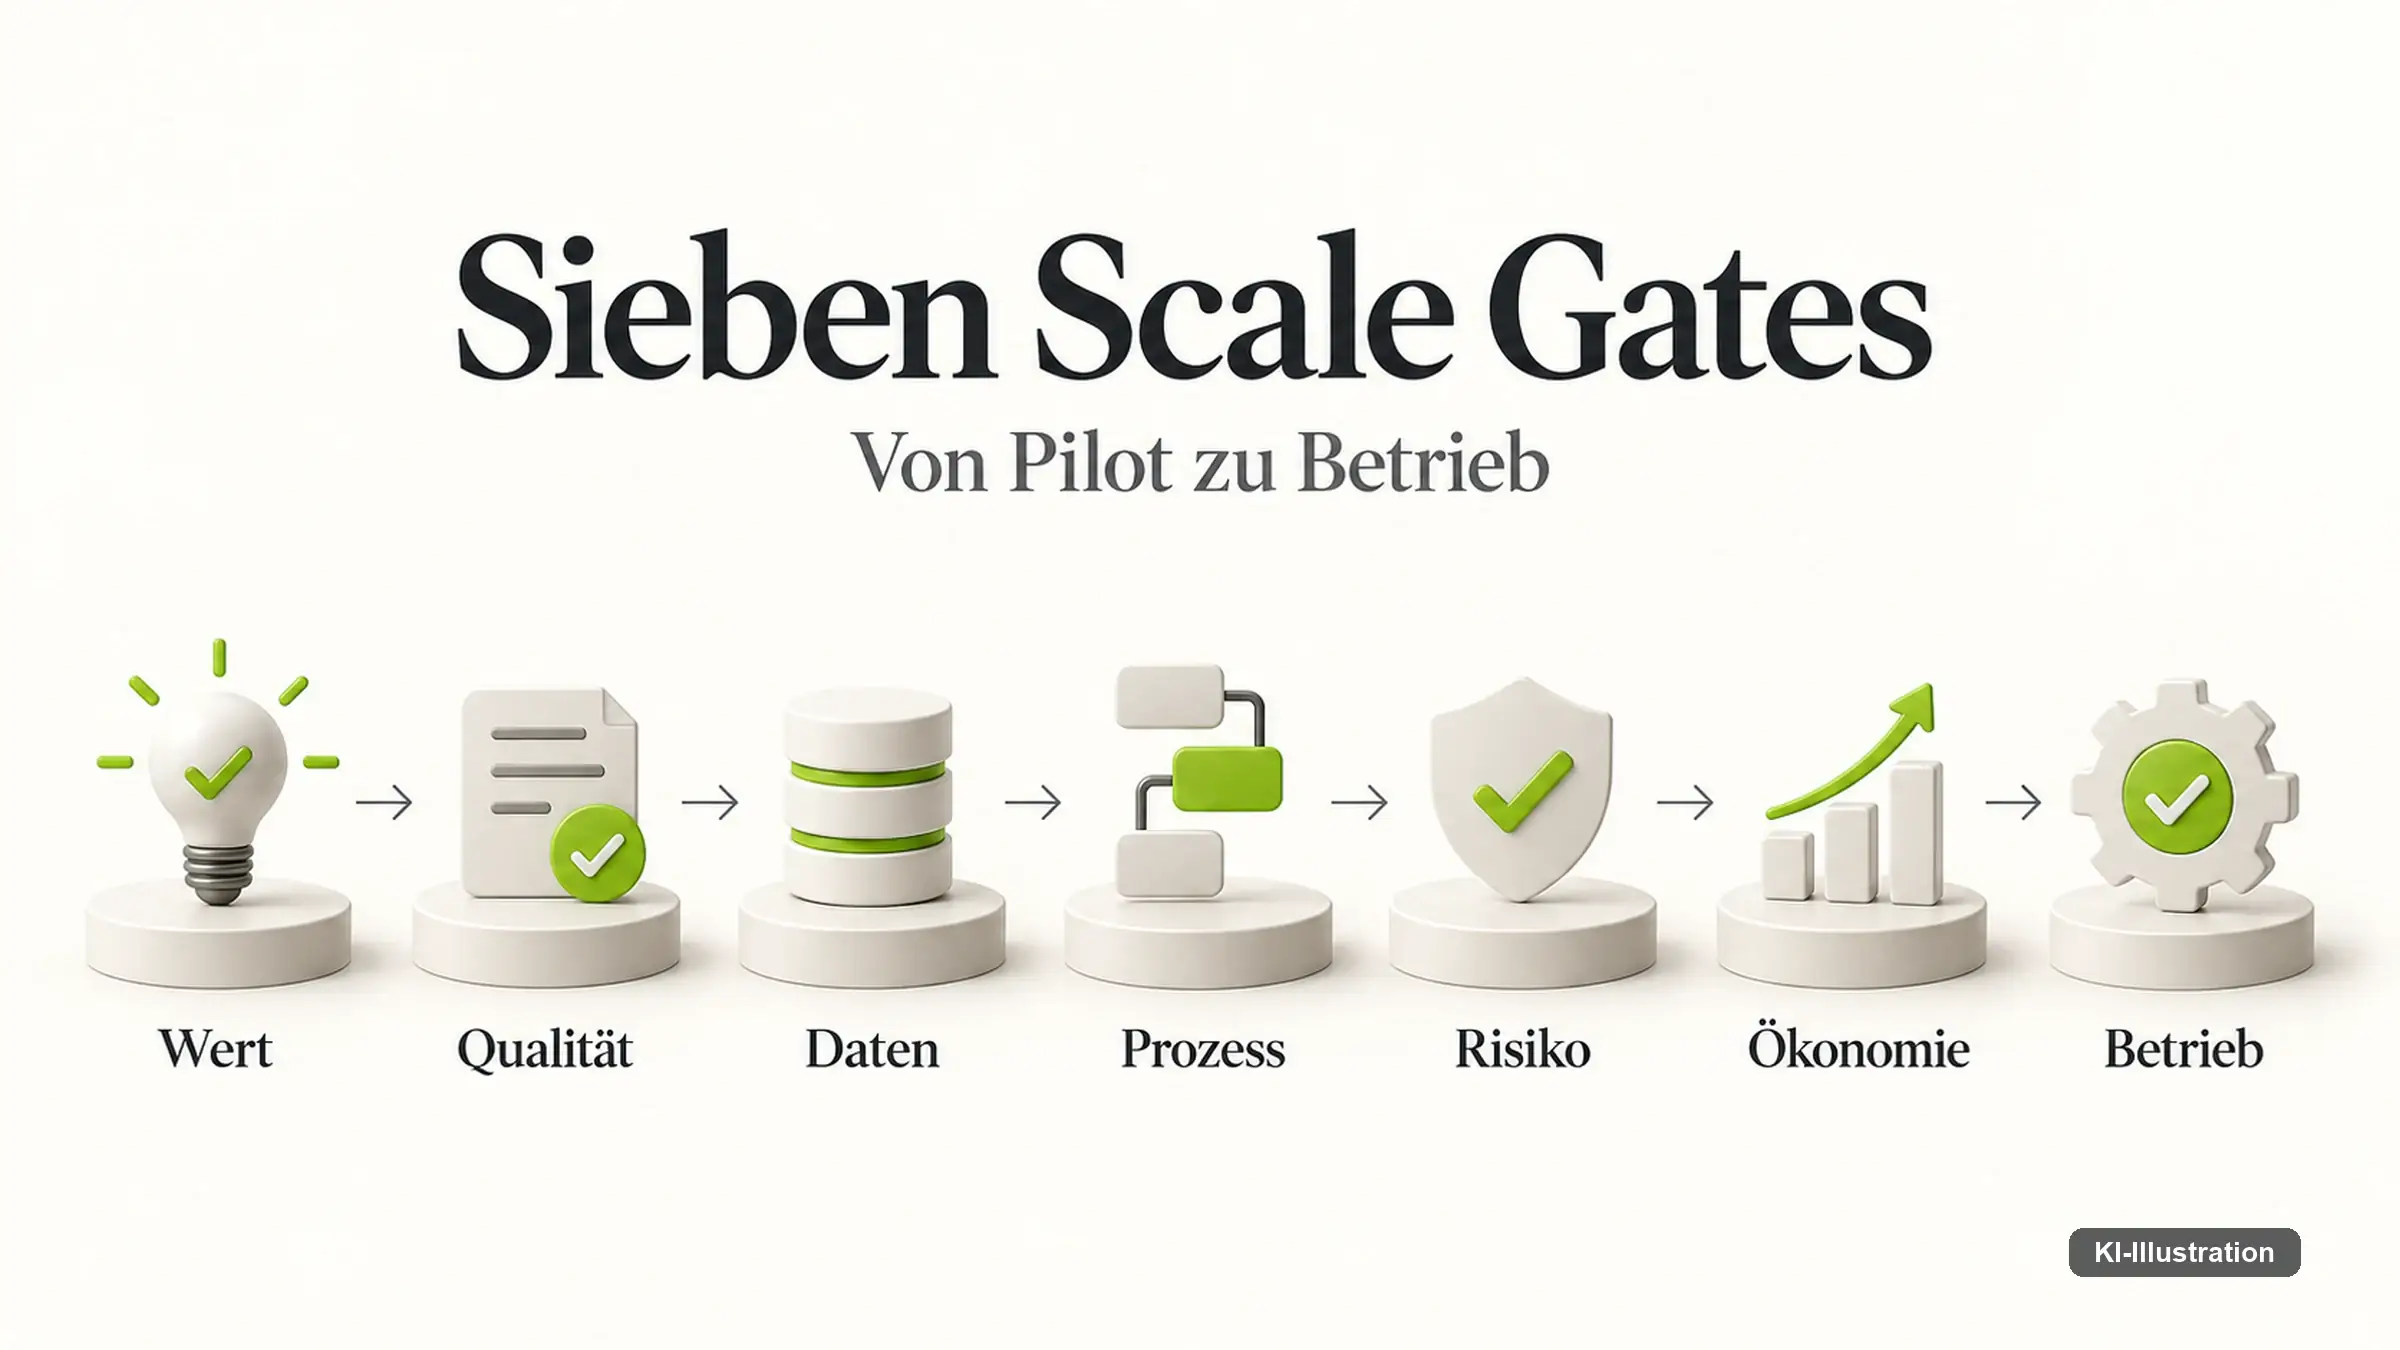
Aus den genannten Arbeiten lässt sich eine Reihenfolge ableiten, die wir als eigene Einteilung dieser Redaktion vorstellen und nicht als Branchenmodell. Sie ordnet die offenen Fragen so, dass die billigen vor den teuren stehen.
Wert. Welche Größe soll sich verändern, um wie viel, bis wann, und wer misst sie heute schon? Ohne Antwort darauf ist jede spätere Erfolgsmeldung unwiderlegbar und damit wertlos.
Qualität. Nicht die beste Ausführung zählt, sondern die Verteilung über viele. Eine Erfolgsquote von 30 Prozent ist nicht das Gegenteil von brauchbar — sie beschreibt eine andere Betriebsform als 95 Prozent, weil sie Nacharbeit als Regelfall voraussetzt.
Daten. Hier entscheidet sich weniger, ob genug vorhanden ist, als ob das System merkt, wenn etwas fehlt. Ein Verfahren, das bei unzureichender Grundlage trotzdem antwortet, erzeugt einen Fehler, den niemand als Fehler sieht.
Prozess. An welcher Stelle des bestehenden Ablaufs sitzt der Agent, was passiert vor ihm, was danach? Viele Vorhaben beschleunigen einen Schritt, der gar nicht der Engpass war.
Risiko. Das US-Normungsinstitut NIST führt in seinem Rahmenwerk für generative KI zwölf neue oder verschärfte Risiken, an zweiter Stelle das freie Erfinden von Inhalten. Das Rahmenwerk ist freiwillig und enthält keine Messwerte, benennt aber auch das Heranziehen abgerufener Dokumente ausdrücklich als etwas, das gegen Informationssicherheit zu bewerten ist — die vermeintliche Absicherung ist selbst eine Angriffsfläche.
Ökonomie. Bezahlt werden alle Versuche, gescheiterte eingeschlossen. In der genannten NeurIPS-Arbeit kostete ein Aufgabenversuch beim besten System 4,20 US-Dollar an reinen Modellabfragen bei durchschnittlich 27,2 Schritten; geteilt durch die Erfolgsquote von 0,303 ergeben sich rund 13,90 US-Dollar je tatsächlich erledigter Aufgabe. Diese Division stammt von uns und nicht aus der Arbeit, und sie enthält weder Infrastruktur noch Aufsicht noch Nacharbeit.
Betrieb. Wer trägt das Ding, wenn das Projekt vorbei ist? Diese Frage steht am Ende, weil sie am häufigsten erst gestellt wird, wenn sie sich nicht mehr verschieben lässt.
Prognosen über das Scheitern haben ein Verfallsdatum
Zu Abbruchquoten gibt es eine Zahl, die derzeit überall zitiert wird. Am 25. Juni 2025 hat das Analystenhaus Gartner prognostiziert, mehr als 40 Prozent der agentischen KI-Projekte würden bis Ende 2027 abgebrochen — wegen steigender Kosten, unklaren Geschäftswerts oder unzureichender Risikokontrolle. Dieselbe Mitteilung schätzt, dass von mehreren Tausend Anbietern mit agentischem Anspruch nur rund 130 tatsächlich entsprechende Fähigkeiten liefern, und nennt das agent washing.
Beides ist die Einschätzung eines kommerziellen Analystenhauses, keine Messung. Der Horizont Ende 2027 liegt noch vor uns, überprüfen lässt sich die Aussage heute also nicht.
Interessanter als diese Zahl ist ihre Vorgängerin. Am 29. Juli 2024 stand eine Prognose desselben Hauses im Raum, die 30 Prozent Abbruch bis Ende 2025 nannte. Dieser Horizont ist verstrichen. Uns ist keine öffentliche Auswertung bekannt, die den eingetretenen Wert gegen die damalige Prognose hält — und die Nachfolgerin, die bis 2027 reicht, wird zitiert, als habe es die erste nie gegeben.
Daraus folgt ein kleiner, aber brauchbarer Befund über die Gattung selbst. Prognosen über das Scheitern von KI-Projekten sind eine Textsorte mit eingebautem Verfallsdatum: veröffentlicht, zwei Jahre lang als Beleg für die eigene Vorsicht herumgereicht, dann von der nächsten Prognose ersetzt, bevor jemand nachzählt. Wer sie zitiert, zitiert keine Erfahrung, sondern eine Erwartung.
Wertlos ist die Zahl deshalb nicht. Die drei genannten Abbruchgründe decken sich auffällig mit dem, was aus den Erhebungen sonst zu sehen ist. Nur ersetzt sie keine eigene Quote: Was in Ihrem Haus abgebrochen wird, wissen Sie erst, wenn Sie es zählen, und dafür brauchen Sie eine Liste aller begonnenen Vorhaben, auch der stillgelegten.
Was Unternehmen selbst als Hindernis nennen
Die europäische Statistikbehörde Eurostat erhebt jährlich, wie viele Unternehmen KI einsetzen und was diejenigen aufhält, die es erwogen und verworfen haben. Zum Datenstand Dezember 2025 setzten 19,95 Prozent der Unternehmen in der EU KI ein, nach 13,48 Prozent im Jahr zuvor.
Die Spreizung darunter relativiert jede Aussage über „die europäischen Unternehmen“: Dänemark kommt auf 42,03 Prozent, Rumänien auf 5,21 Prozent. Nach Größe sortiert liegen kleine Unternehmen bei 17 Prozent, mittlere bei 30,36 Prozent, große bei 55,03 Prozent. Der Größenabstand aus der McKinsey-Befragung taucht hier also wieder auf, gemessen an anderer Grundgesamtheit und mit anderer Methode.
Aufschlussreicher als die Einsatzquoten sind die genannten Hinderungsgründe. Ganz oben steht fehlendes Fachwissen mit 70,89 Prozent, dahinter Unklarheit über die rechtlichen Folgen mit 52,52 Prozent und Datenschutzbedenken mit 48,83 Prozent. Mangelnder Nutzen folgt weit abgeschlagen mit 20,68 Prozent. Kosten führt diese Aufstellung überhaupt nicht auf.
Das widerspricht der Erzählung dieses Beitrags, und der Widerspruch gehört benannt statt weggelassen. Wer gerade gelesen hat, dass gescheiterte Versuche mitbezahlt werden und dass 20 Prozent der von McKinsey Befragten die laufenden KI-Betriebskosten einschließlich der Token-Kosten als Begrenzung nennen, erwartet Kosten an prominenter Stelle.
Eine Auflösung, die beide Befunde stehen lässt, liegt in der Frage selbst. Eurostat fragt Unternehmen, die noch nicht eingestiegen sind — und wer nie angefangen hat, kennt seine Betriebskosten nicht, sondern nur seine Unsicherheit. McKinsey fragt Häuser mitten im Betrieb, und die kennen die Rechnung. Kosten sind demnach kein Einstiegshindernis, sondern ein Skalierungshindernis.
Der Dauerpilot und seine drei Ausgänge
Im englischen Sprachraum trägt der Zustand, in dem ein Vorhaben weder skaliert noch beendet wird, einen Namen: pilot purgatory, wörtlich das Fegefeuer des Piloten. Gemeint ist die Zwischenwelt, in der ein Projekt weiterläuft, ohne je eine Entscheidung zu bekommen.
Böse Absicht steckt selten dahinter. Ein laufender Pilot tut niemandem weh: Er ist budgetiert, produziert freundliche Zwischenberichte, und solange er läuft, muss niemand einräumen, dass die ursprüngliche Erwartung zu hoch war. Ein Abbruch dagegen kostet Gesicht, eine Skalierung kostet Geld und Zuständigkeit.
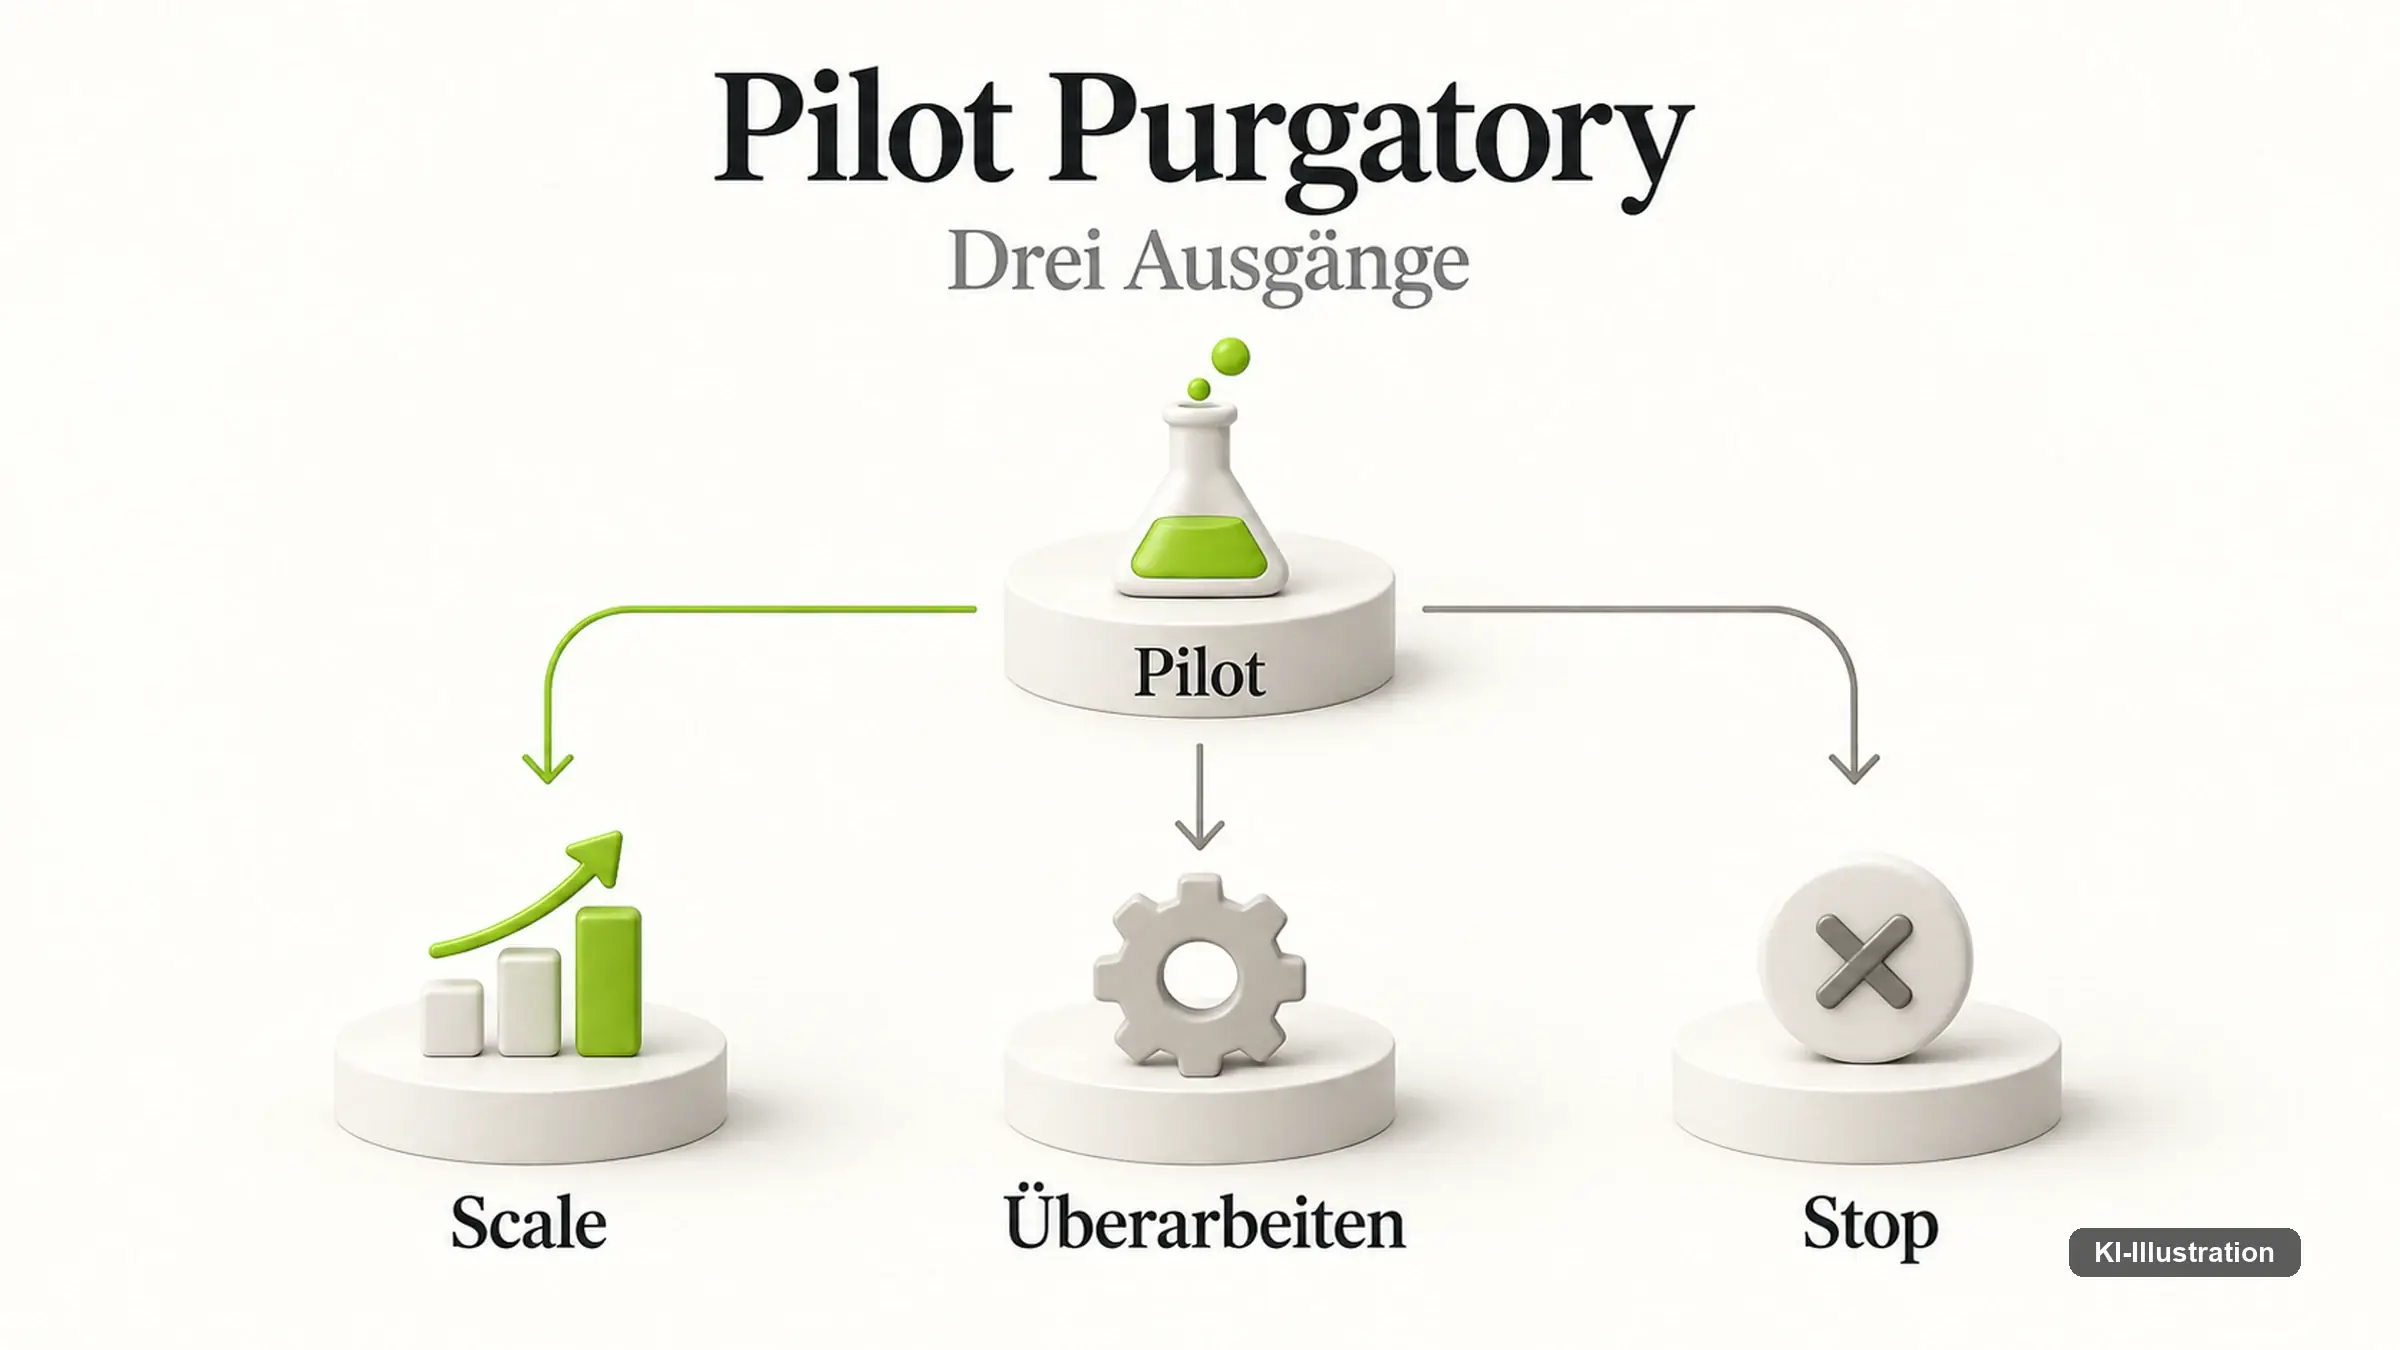
Sauber sind aus diesem Zustand nur drei Ausgänge. Der eine ist die Skalierung, mit Budget, benanntem Betrieb und einer Kennzahl, die danach weiter erhoben wird. Der zweite ist die Überarbeitung: derselbe Anwendungsfall, aber mit engerem Aufgabenumfang oder anderer Datengrundlage, und mit einer Frist, nach der erneut entschieden wird. Der dritte ist das Ende, dokumentiert, mit dem Grund und der Zahl, an der es lag.
Dieser dritte Ausgang wird am meisten unterschätzt. Ein früh beendeter Pilot ist das billigste Ergebnis eines Versuchs, der nicht getragen hat — vorausgesetzt, jemand schreibt auf, woran es lag. Ohne diese Notiz beginnt achtzehn Monate später ein anderes Team denselben Versuch, weil es von der ersten Runde nur die Präsentation findet und nicht den Grund für ihr Ende. Der wirtschaftliche Kern dieser Abbrüche ist seltener fehlende Leistung als Unstetigkeit statt Leistungsschwäche.
Daraus ergibt sich die einzige Vorkehrung, die vor dem Dauerpilot schützt, und sie muss vor dem Start getroffen werden: ein Datum, an dem entschieden wird, und ein Wert, unterhalb dessen beendet wird. Beides gehört in dieselbe Unterlage wie das Ziel, weil es sich später nicht mehr glaubwürdig nachtragen lässt. Wer erst nach sechs Monaten festlegt, was als Erfolg gilt, legt fest, was herausgekommen ist.
Warum das Betriebsmodell der harte Teil ist
Wie sehr sich die Debatte verschoben hat, lässt sich am Programm der HumanX Europe 2026 ablesen, die vom 22. bis 24. September 2026 im RAI Amsterdam stattfindet. Das Programm führt zum 13. September 2026 insgesamt 173 Punkte, darunter 95 Vorträge und 20 Roundtables. Ein Programmpunkt trägt den Titel „The Hard Part of AI: The Operating Model“ — der schwierige Teil, und gemeint ist nicht das Modell, sondern die Art, wie ein Unternehmen arbeitet.
Dazu passt ein Format, das für den 24. September von 13:15 bis 14:00 Uhr angekündigt ist. Der Roundtable „Beyond the Pilot: What It Really Takes to Scale Agentic AI“ hat 19 Plätze und wird von Luca Dell’Orletta moderiert, Global Head of Tech Innovation und Enterprise Architecture bei Nestlé. Ein Gespräch ohne Bühne und mit begrenzter Teilnehmerzahl wählt man nicht, um ein Ergebnis zu präsentieren, sondern wenn die Antwort offen ist und die Beteiligten reden sollen, ohne dass jeder Satz zitierbar wird.
Unmittelbar danach, von 13:55 bis 14:15 Uhr, fragt ein weiterer Programmpunkt unter dem Titel „Rewriting the Operating Model for the AI Era“ nach dem Umbau des Betriebsmodells, angekündigt mit Des Traynor, Jennifer Smith und Luisa Bomke. Drei Programmpunkte innerhalb einer Stunde adressieren damit dieselbe Stelle: nicht die Fähigkeit der Systeme, sondern die Organisation um sie herum.
Dieser Beitrag entstand vor Beginn der Veranstaltung und referiert deshalb keine Aussage von der Bühne. Belegt ist allein, dass diese Fragen in dieser Form gestellt werden — und ein Feld, das über den Umbau seines Betriebsmodells berät, hat den Umbau noch vor sich.
Für die eigene Lage folgt daraus keine Handlungsanweisung, wohl aber eine schärfere Frage. Sie lautet nicht mehr, ob ein KI-System eine bestimmte Aufgabe erledigen kann, denn das beantwortet jeder Pilot mit ja. Sie lautet, wer den Vorgang verantwortet, wenn das System ihn zu sechzig Prozent erledigt und zu vierzig Prozent liegen lässt, woran dieser Jemand die vierzig Prozent erkennt, und was das Ganze je abgeschlossenem Vorgang kostet. Häuser, die darauf belastbar antworten, brauchen keine Prognose über Abbruchquoten. Sie haben ihre eigene Zahl.
Quellen. Alle Adressen wurden am 13. September 2026 geprüft. Wo eine Seite automatisierte Abrufe abweist, wurde sie im Browser geöffnet und der Inhalt gegen die Nennung abgeglichen.
- McKinsey & Company, The state of AI, 25. August 2026; Selbstauskünfte.
- Eurostat, Use of artificial intelligence in enterprises, Datenstand Dezember 2025.
- Xu et al., TheAgentCompany: Benchmarking LLM Agents on Consequential Real World Tasks, Carnegie Mellon University und Duke University, NeurIPS 2025; Erfolgsquoten und Kosten je Versuch aus Tabelle 1.
- Sky Computing Lab, University of California, Berkeley, Why Do Multi-Agent LLM Systems Fail? (Taxonomie MAST); 14 Fehlermodi aus über 1.600 annotierten Ausführungsspuren, keine Ratenmessung.
- NIST, AI 600-1: Generative Artificial Intelligence Profile, Juli 2024; freiwilliges Rahmenwerk ohne Messwerte.
- Gartner, Over 40% of Agentic AI Projects Will Be Canceled by End of 2027, 25. Juni 2025; Prognose.
- Gartner, Prognose vom 29. Juli 2024 mit 30 Prozent Abbruch bis Ende 2025 — hier ohne Adresse geführt, weil für diesen Beitrag nur Datum und Zahl geprüft wurden und der Horizont verstrichen ist.
- HumanX Europe 2026, Programm und Sessionseite zum Roundtable „Beyond the Pilot“; belegt sind Titel, Zeiten, Formate und Beteiligte, keine Inhalte.
Die Angaben zu Rahmenwerken sind eine redaktionelle Einordnung und keine Rechtsberatung.
Wie lange sollte ein Pilot laufen, bevor entschieden wird?
Eine belegte Zahl dafür gibt es nicht, und jede genannte Frist wäre geraten. Tragfähiger ist ein Schwellenwert: Legen Sie vor dem Start fest, welche Kennzahl sich um welchen Betrag bewegen muss und an welchem Datum darüber entschieden wird. Eine Frist ohne Schwellenwert verlängert sich erfahrungsgemäß von selbst.
Warum skalieren große Unternehmen deutlich häufiger als kleine?
Die Erhebungen zeigen den Abstand, nennen aber keine Ursache. In der McKinsey-Befragung liegt der Anteil kleinerer Organisationen, die Agenten skalieren, unverändert bei 22 Prozent, während er bei Großunternehmen von 27 auf 40 Prozent stieg; Eurostat weist für 2025 Einsatzquoten von 17 Prozent bei kleinen und 55,03 Prozent bei großen Unternehmen aus. Naheliegend ist, dass Fachkräfte, Datenhaltung und Rechtsberatung mit der Unternehmensgröße verfügbarer werden — das ist eine Deutung, kein Befund der Erhebungen.
Woran erkenne ich einen Anbieter, der nur agentisch draufschreibt?
Gartner schätzt, dass von mehreren Tausend Anbietern mit agentischem Anspruch nur rund 130 tatsächlich entsprechende Fähigkeiten liefern, und nennt das agent washing. Diese Schätzung beruht auf einer Abgrenzung des Hauses selbst und ersetzt keine eigene Prüfung. Belastbarer sind drei Fragen: eine Erfolgsquote über einen längeren Zeitraum statt einzelner Durchläufe, das Verhalten bei fehlender Information, und ein Protokoll, das jeden Schritt nachvollziehbar macht.
Reicht eine hohe Nutzung als Nachweis, dass sich ein System lohnt?
Nutzung ist ein Hinweis, kein Nachweis. In der McKinsey-Befragung berichten 80 Prozent eine höhere persönliche Produktivität und 50 Prozent bessere Entscheidungen, während 37 Prozent einen Beitrag zum operativen Ergebnis melden. Zwischen beiden Werten liegt die Frage, ob eine eingesparte Stunde irgendwo als eingesparte Stunde ankommt.
Wie kalkuliere ich die laufenden Kosten eines Agentenbetriebs?
Der belastbare Bezugspunkt ist der erledigte Vorgang und nicht die einzelne Abfrage, weil auch jeder Fehlversuch bezahlt wird. In der NeurIPS-Arbeit von 2025 kostete ein Aufgabenversuch beim besten System 4,20 US-Dollar an reinen Modellabfragen; bei 30,3 Prozent Erfolgsquote sind das rund 13,90 US-Dollar je abgeschlossener Aufgabe. Diese Division stammt von uns, nicht aus der Arbeit, und enthält weder Infrastruktur noch Aufsicht noch Nacharbeit.
Scheitern mehrere zusammenarbeitende Agenten häufiger als ein einzelner?
Das lässt sich mit den vorliegenden Arbeiten nicht beantworten. Die Auswertung des Sky Computing Lab in Berkeley ordnet Fehlschläge in 14 Modi und drei Kategorien, misst aber keine Häufigkeiten, weshalb aus ihr kein Vergleich folgt. Sie zeigt lediglich, dass ein erheblicher Teil der beobachteten Fehler in der Abstimmung zwischen Komponenten entsteht und nicht im Modell selbst.
Was gehört in einen Pilotbericht, damit danach entschieden werden kann?
Vier Angaben, die sich nachträglich nicht erzeugen lassen: die Kennzahl aus der Zeit vor dem Pilot, die Erfolgsquote über alle Läufe einschließlich der gescheiterten, die Kosten je abgeschlossenem Vorgang und der Aufwand für Aufsicht und Nacharbeit in Stunden. Dazu gehört, wie der Datenausschnitt zustande kam. Ein Bericht ohne diese Punkte kann jede Entscheidung stützen und stützt deshalb keine.
Lässt sich der Ergebnisbeitrag von KI überhaupt sauber zurechnen?
In den vorliegenden Erhebungen nicht. Die 37 Prozent aus der McKinsey-Befragung sind eine Selbstauskunft; wie ein Haus den Beitrag ermittelt hat, weist die Erhebung nicht aus. Zurechenbar wird der Effekt erst, wenn dieselbe Kennzahl vor und nach dem Einsatz erhoben wird und bekannt ist, was sich im selben Zeitraum sonst verändert hat.