Physical AI & Robotik-KI · Fachanalyse
Vom Pilot zur Flotte: Wie Robotik aus dem Betrieb lernt
Kurz gesagt: Ein Roboter im Kundeneinsatz produziert nicht automatisch bessere KI. Zwischen einer Beobachtung im Feld und einer belastbaren neuen Version liegen Datenauswahl, Fehleranalyse, Rechte, Tests und Freigaben. Erst dieser kontrollierte Kreislauf macht reale Betriebserfahrung zu einem dauerhaften Entwicklungsvorteil.
Ein Roboter stoppt vor einem Behälter, den er am Vortag problemlos gegriffen hat. Vielleicht ist das Objekt verformt. Vielleicht wurde die Beleuchtung verändert. Vielleicht ist die Kamera verschmutzt oder ein Gelenk läuft schwerer. Das Ereignis ist zunächst kein Trainingsdatensatz und noch keine Erklärung. Es ist eine Beobachtung, deren Bedeutung erst rekonstruiert werden muss.
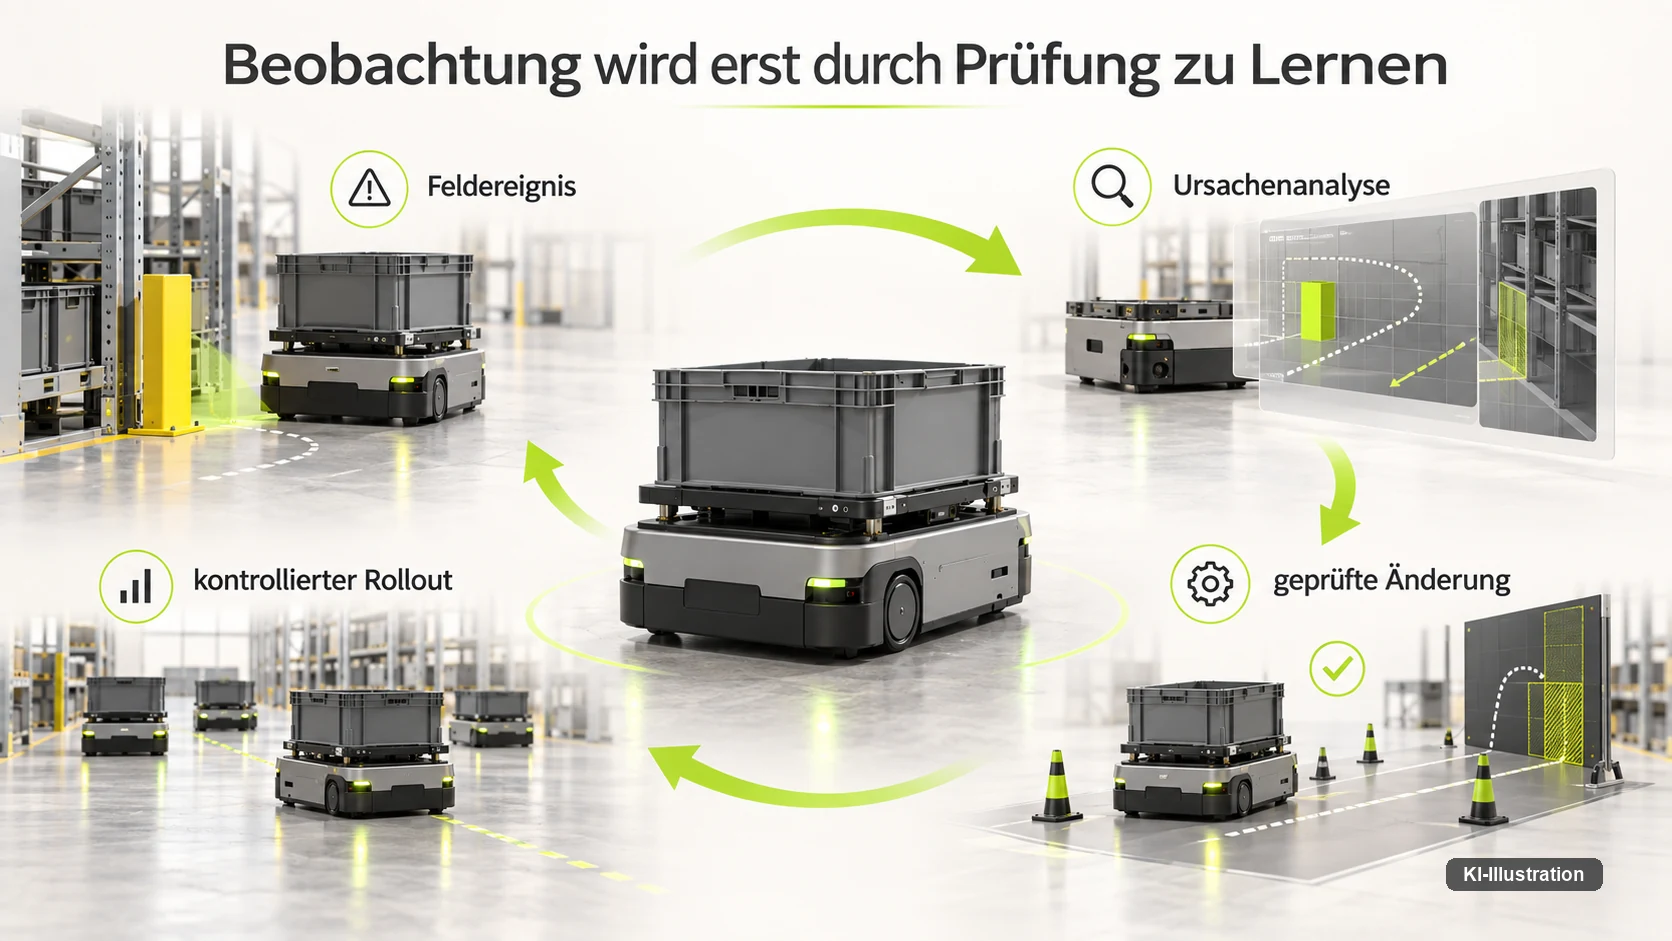
Genau darin liegt die anspruchsvolle Seite des Versprechens, Physical AI werde mit jedem Einsatz besser. Reale Maschinen können wertvolle Erfahrungen erzeugen. Damit daraus eine Verbesserung entsteht, müssen diese Erfahrungen jedoch verstanden, zugeordnet und in eine überprüfte Änderung übersetzt werden. Eine größere Flotte vergrößert nicht nur die mögliche Datenbasis. Sie vergrößert auch die Zahl der Versionen, Umgebungen und Verantwortlichen, die berücksichtigt werden müssen.
Die zentrale Frage lautet deshalb nicht, wie viele Roboter Daten sammeln. Sie lautet, ob ein Unternehmen aus einem konkreten Feldereignis eine nachvollziehbare Entwicklungsentscheidung machen kann – und ob die daraus entstandene Version unter den vorgesehenen Bedingungen tatsächlich besser funktioniert. Zwischen beidem liegt ein vollständiger Arbeitsprozess, der weder mit Datentransfer noch mit Modelltraining allein erledigt ist.
Felderfahrung kann auch zu weniger Komplexität führen
Ein aufschlussreiches Beispiel liefert Figure in seinem Rückblick vom 19. November 2025: 11 Monate Einsatz von Figure 02 bei BMW, Vollbetrieb ab Monat 10. Das Unternehmen beschreibt, wie Erfahrungen mit dem Unterarm des Roboters zu einer neu konstruierten Handgelenkselektronik der folgenden Generation führten – die veröffentlichte Rückkopplung betrifft damit Hardwarearchitektur, nicht nur zusätzliche Trainingsdaten. Ein quantitativ nachgewiesener Zuverlässigkeitsgewinn der neuen Generation ist mit dieser Beschreibung noch nicht gegeben.
Einen vergleichbaren, eng getakteten Rückmeldezyklus zwischen Einsatz und Hersteller beschreibt ein eigener Beitrag zur Operation Vivaldi für ukrainische Bodenrobotik — unter deutlich härteren Einsatzbedingungen.
Das ist eine wichtige Korrektur des verbreiteten Bildes eines ausschließlich datengetriebenen Kreislaufs. Ein Fehler kann zeigen, dass ein Modell anders trainiert werden muss. Er kann ebenso zeigen, dass ein Bauteil vereinfacht, ein Kabel anders geführt oder eine Wartung besser zugänglich gemacht werden sollte. Die wertvollste Reaktion auf ein Ereignis ist nicht zwangsläufig mehr KI – ein eigener Beitrag zum Physical-AI-Engpass ordnet diese Verwechslung von Modell- und Hardwareproblemen grundsätzlicher ein.
Der Begriff Lernen sollte deshalb breiter und zugleich präziser verwendet werden. Eine Organisation kann aus dem Betrieb lernen, ohne dass ihre Roboter während jeder Schicht selbstständig Modellparameter verändern. Konstruktive Verbesserungen, verständlichere Bedienabläufe und bessere Prüfverfahren sind ebenfalls Lernresultate. Entscheidend ist der nachweisbare Zusammenhang zwischen Beobachtung, Änderung und erneuter Prüfung.
Ein Robot Park ist eine Entwicklungsinfrastruktur
Apptronik beschreibt seine Robot Parks und Apollo 2 als Infrastruktur für reale Datensammlung und Training. Die Mitteilung vom 30. Juni 2026 nennt teleoperierte und autonome Ausführungen an eigenen sowie an mehreren Partnerstandorten. Dieser Ansatz soll die Entwicklung späterer kommerzieller Systeme unterstützen. Die dargestellte Datenarbeit ist deshalb nicht mit dem bereits belegten wirtschaftlichen Dauerbetrieb der angekündigten Folgegeneration gleichzusetzen.
Für die Analyse ist das keine Einschränkung ihres möglichen Werts. Eine gute Entwicklungsumgebung kann gezielt Aufgaben bereitstellen, die im normalen Betrieb selten auftreten oder dort nur unter zusätzlichen Schutzmaßnahmen untersucht werden dürfen. Sie kann Wiederholungen ermöglichen und schwierige Fälle systematisch variieren, ihr Ergebnis muss jedoch als Trainings- oder Testevidenz eingeordnet werden, nicht stillschweigend als produktive Kundenleistung. Auch der Begriff „real“ reicht zur Unterscheidung nicht aus: Physische Gegenstände in einer echten Halle erzeugen reale Sensordaten, auch wenn Aufgaben ausgewählt, Objekte vorbereitet oder Abläufe von Menschen unterstützt sind – und genau dieser Unterstützungsumfang entscheidet, was ein späteres Produkt selbstständig leisten kann.
Datenvolumen ist nicht gleich Informationsgewinn
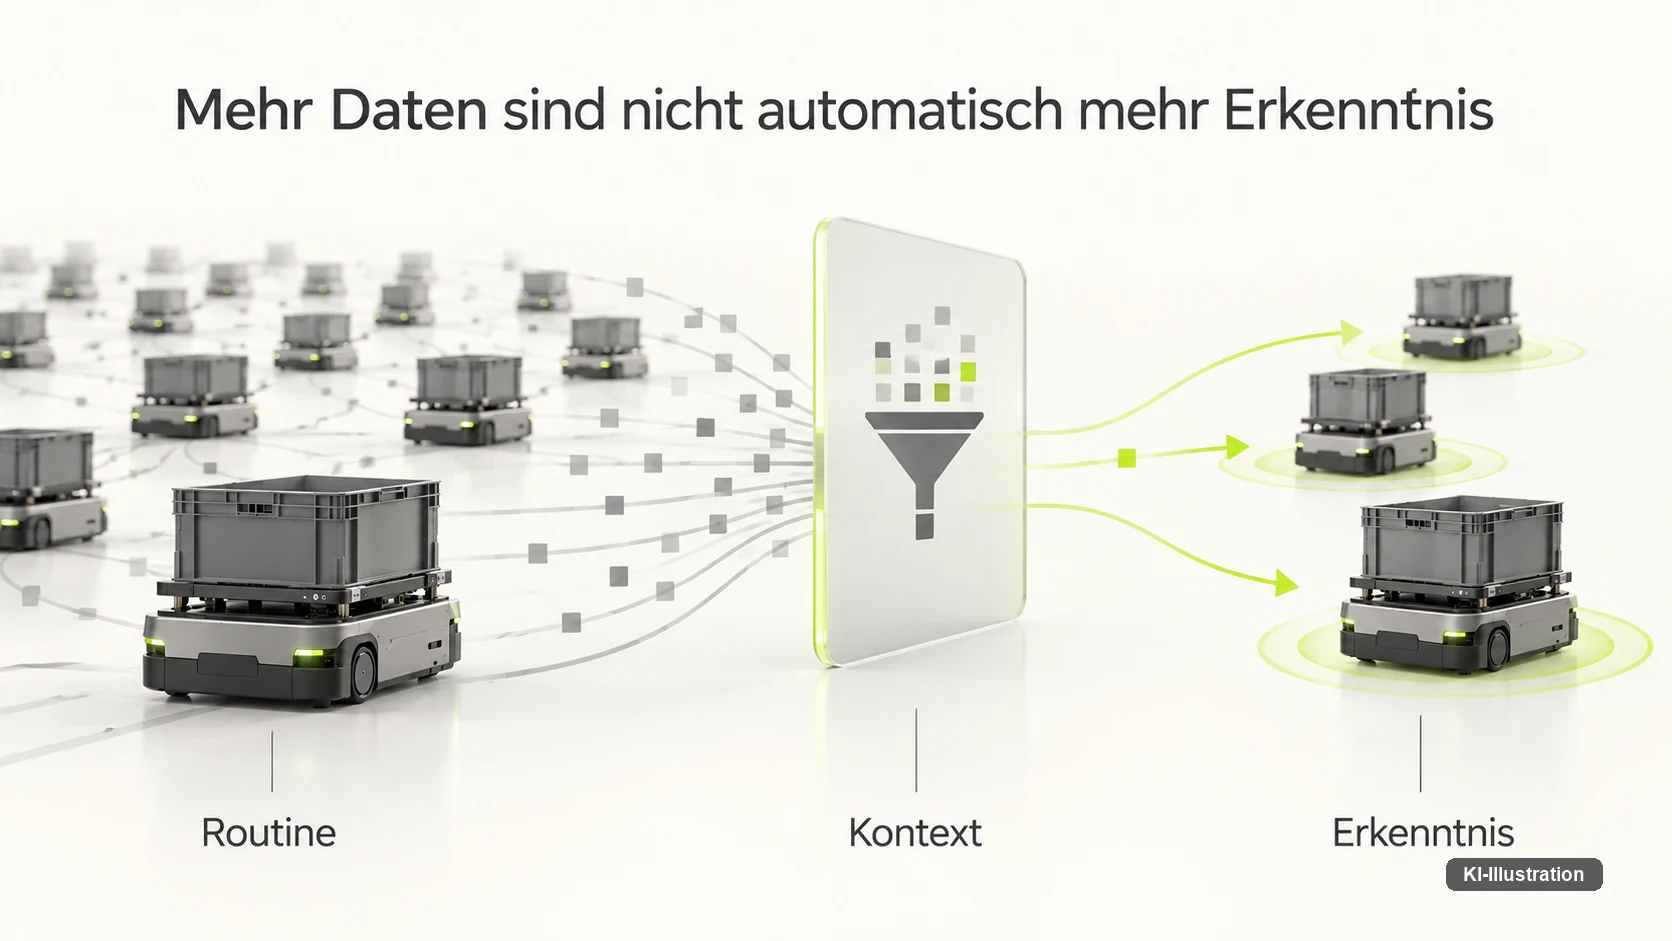
Eine Flotte kann sehr viele ähnliche erfolgreiche Abläufe speichern und trotzdem wenig über ihre schwierigsten Fälle wissen. Das ist eine logische Folge wiederholter gleichartiger Aufgaben. Wenn die entscheidende Schwäche nur bei einer seltenen Kombination aus Objekt, Beleuchtung und Greiferzustand auftritt, helfen zusätzliche Routineaufnahmen nur begrenzt bei ihrer Aufklärung.
Der Wert eines Datensatzes hängt deshalb auch davon ab, welche Unsicherheit er bearbeitet. Für ein bekanntes Wahrnehmungsproblem können wenige gut dokumentierte Fehlersituationen nützlicher sein als viele weitere erfolgreiche Durchläufe – das ist keine allgemeine Aussage, dass kleine Datensätze grundsätzlich besser wären, sondern ein Hinweis darauf, dass Menge und Relevanz unterschiedliche Eigenschaften sind. Auch die Auswahl selbst kann das Bild verzerren. Werden nur spektakuläre Fehler gespeichert, fehlt möglicherweise eine Vergleichsbasis zum normalen Betrieb. Werden nur erfolgreiche Sequenzen aufgehoben, verschwinden die Grenzen. Ein sinnvoller Erfassungsplan sollte deshalb festlegen, welche Routinebeobachtungen, Ausnahmefälle und Kontextdaten für eine konkrete Entwicklungsfrage benötigt werden.
Dabei entsteht ein Spannungsverhältnis zur Speicher- und Datenschutzökonomie. Mehr Daten können spätere Analysen erleichtern, verursachen aber Aufwand und gegebenenfalls zusätzliche Risiken. Die technische Antwort sollte nicht lauten, vorsorglich alles dauerhaft zu sammeln. Besser ist eine begründete Auswahl mit nachvollziehbaren Aufbewahrungs- und Zugriffskonzepten. Welche rechtlichen Voraussetzungen dabei gelten, muss zusätzlich geprüft werden; ein technischer Nutzen allein genügt nicht.
Was in einem Fehlerprotokoll stehen müsste
Ein brauchbares Ereignisprotokoll beginnt nicht erst mit der Meldung „Griff fehlgeschlagen“. Es müsste rekonstruierbar machen, welche Aufgabe vorlag, welche Version aktiv war, welche Sensoren und Komponenten beteiligt waren und was unmittelbar vor dem Fehler geschah. Ohne diesen Kontext kann die gleiche Fehlermeldung auf sehr unterschiedliche Ursachen verweisen.
Boston Dynamics beschreibt in seinem Datenschutzhinweis vom 15. Januar 2026 für Stretch Service Logs mit Sensordaten und Informationen zur Interpretation dieser Daten durch den Roboter. Auch Kamerabilder können zur Diagnose enthalten sein. Die Datenschutzhinweise unterscheiden solche Protokolle von Leistungsmetriken. Das ist eine konkrete Herstellerbeschreibung eines Diagnosewegs, keine unabhängige Prüfung seiner Vollständigkeit oder eine pauschale rechtliche Bewertung des Datentransfers.
Als eigenes technisches Arbeitsmodell lässt sich daraus ein Ereignisdatensatz mit mehreren Ebenen ableiten. Ergänzend sollte erkennbar sein, wie der Vorfall beendet wurde: selbstständige Wiederherstellung, menschliche Unterstützung, Austausch eines Teils oder Abbruch des Auftrags.
| Ebene | Mindestfelder |
|---|---|
| Auftrag und Umgebung | Aufgabentyp, Standort, Zeitstempel, Beleuchtung/Umgebungsbedingung, beteiligtes Objekt |
| Systemzustand | Modellversion, Firmware-Stand, Sensorkalibrierung, aktive Konfiguration |
| Beobachtung und Reaktion | Sensorrohdaten oder Verweis darauf, ausgelöste Fehlermeldung, ausgeführte oder unterbrochene Aktion |
| Abschluss | Beendigungsart (Wiederherstellung, Eingriff, Teileaustausch, Abbruch), zuständige Stelle, Zeit bis zur Klärung |
Besonders wertvoll wäre die Trennung zwischen Ursache, Symptom und Maßnahme. Ein Neustart kann ein Problem vorübergehend beseitigen, ohne seine Ursache zu erklären. Eine Fehlermeldung kann durch eine andere Komponente ausgelöst worden sein. Ein belastbarer Lernprozess sollte diese Unsicherheit erhalten, statt nach der ersten erfolgreichen Wiederaufnahme eine scheinbar sichere Fehlerursache einzutragen.
Logging, Training und Lernen sind unterschiedliche Vorgänge
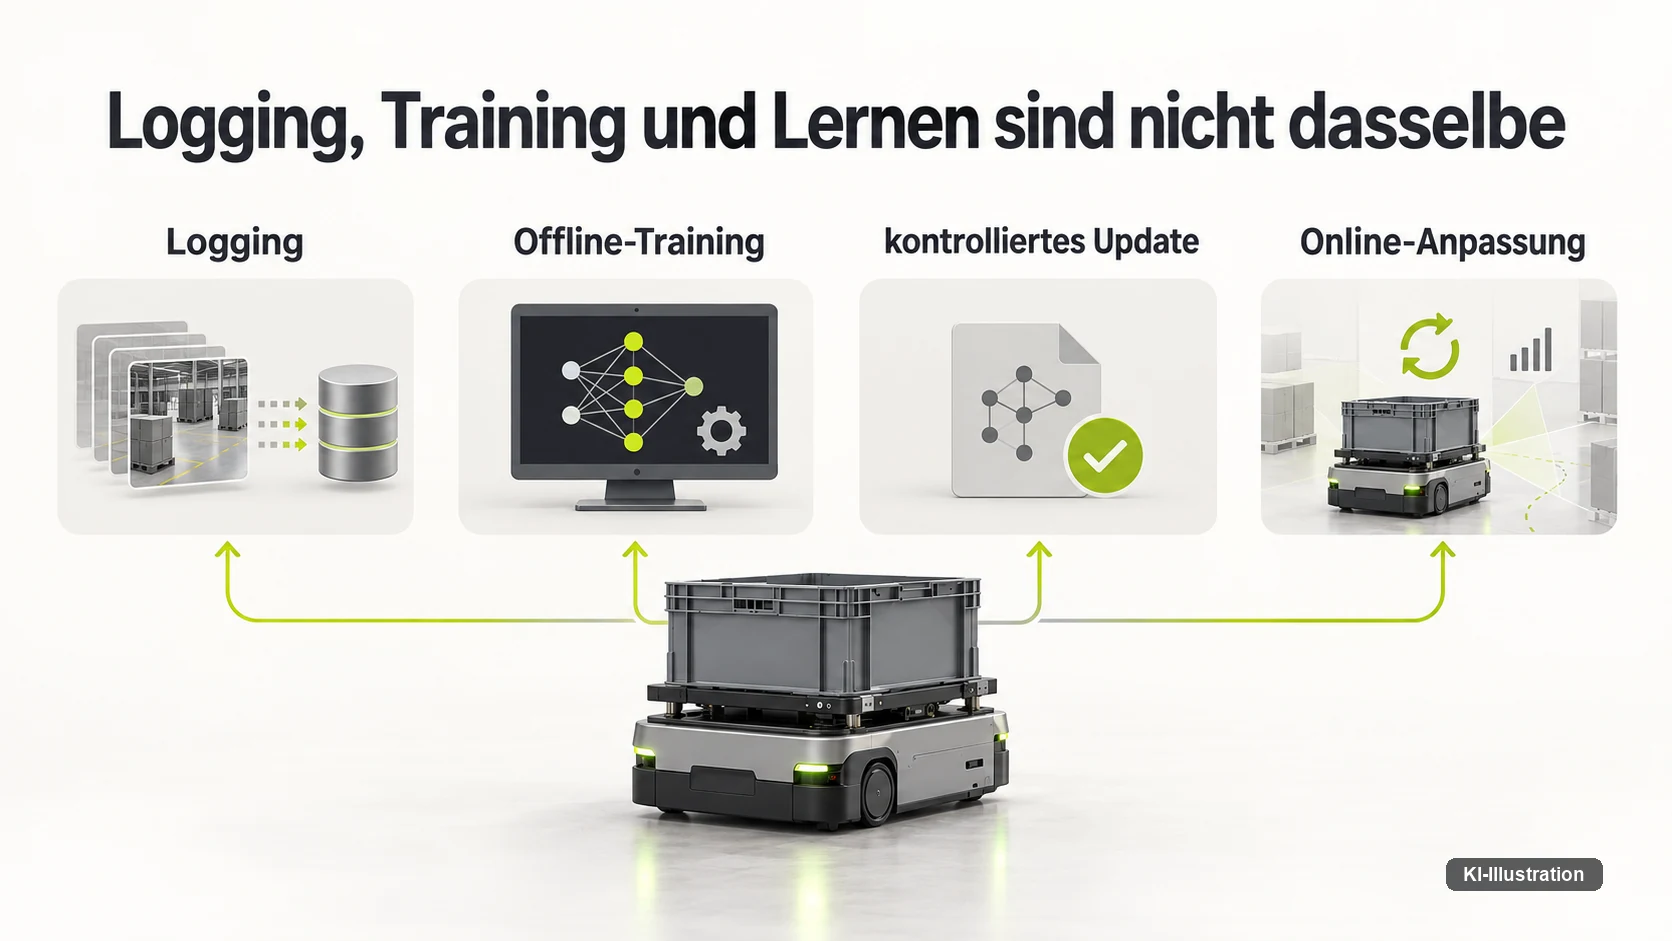
Wer von einem lernenden Roboter spricht, sollte den konkreten Mechanismus benennen: Logging, Offline-Training, kontrolliertes Update und Online-Anpassung sind vier verschiedene Vorgänge, die nicht austauschbar sind.
Auch Flottenlernen muss nicht bedeuten, dass alle Roboter unmittelbar voneinander lernen. Der Ausdruck kann beschreiben, dass Erfahrungen mehrerer Systeme zentral ausgewertet und später in eine gemeinsame Version übernommen werden – für eine konkrete Plattform müsste geprüft werden, welcher Ablauf tatsächlich implementiert ist, denn die bloße Existenz einer Cloudverbindung belegt ihn nicht. Für Betreiber ist die Unterscheidung praktisch wichtig. Bei einer statisch freigegebenen Version lässt sich untersuchen, ob eine beobachtete Veränderung von Umgebung oder Hardware stammt. Bei einem System, das zugleich sein Verhalten verändert, muss zusätzlich nachvollziehbar sein, welcher Anpassungsmechanismus aktiv war. Sonst wird die Fehleranalyse unnötig mehrdeutig.
Eine Organisation sollte deshalb ihre Begriffe an die tatsächlichen Änderungsrechte koppeln: Was die Maschine selbst verändern darf, welche Änderungen eine zentrale Freigabe benötigen, welche Informationen der Betreiber dazu erhält und welche Eigenschaften auch nach einer Anpassung nachweisbar gleich bleiben müssen, sollte vertraglich als Kriterienliste festgehalten sein – erst das macht aus dem allgemeinen Lernversprechen eine beschreibbare Produkteigenschaft.
| Vorgang | Was passiert | Wann wirksam |
|---|---|---|
| Logging | Beobachtungen werden gespeichert, nichts wird verändert | laufend, ohne Wirkung auf das Verhalten |
| Offline-Training | ein Modell wird außerhalb des produktiven Ablaufs verändert | erst nach Prüfung und Freigabe wirksam |
| Kontrolliertes Update | eine geprüfte Version wird auf die Maschine gebracht | zum festgelegten Rollout-Zeitpunkt |
| Online-Anpassung | Zustände oder Parameter verändern sich während des Einsatzes | unmittelbar, ohne separaten Freigabeschritt |
Ein gutes Trainingsbeispiel braucht eine richtige Erklärung
Nicht jede fehlgeschlagene Aktion sollte unverändert in ein Training übernommen werden. Das Ereignis kann durch ein defektes Bauteil, eine falsche Kalibrierung oder einen ungewöhnlichen Bedienablauf entstanden sein. Wird es ohne Einordnung als Modellfehler behandelt, kann die Entwicklung an der falschen Stelle ansetzen. Das Problem ist nicht zu wenig Daten, sondern eine unpassende Zuordnung.
Die Qualität der Datenarbeit hängt somit auch vom Verständnis der Tätigkeit ab. Entwickler, Bediener und Prozessverantwortliche müssen gemeinsam klären, welche Information eine Handlung begründet. Dieses Wissen lässt sich nicht vollständig durch das automatische Speichern von Sensorkanälen ersetzen. Es ist eine eigene Form von Translation zwischen menschlicher Erfahrung und maschinell nutzbarer Beschreibung.
Der Test muss von der Verbesserung getrennt bleiben
Wenn ein Modell mit Erfahrungen aus einem Standort verbessert wird, sollte die Bewertung nicht ausschließlich aus denselben Erfahrungen bestehen. Andernfalls wäre schwer zu erkennen, ob die Fähigkeit wirklich erweitert wurde oder das System lediglich die bekannten Situationen besser reproduziert. Diese Trennung folgt unmittelbar aus der Frage, die geprüft werden soll.
Ein sinnvoller Evaluationsplan könnte daher bekannte Problemfälle, bisher unverwendete Aufgaben und andere Standorte getrennt betrachten. Auch zeitliche Trennung kann wichtig sein, denn ein späterer Betriebszeitraum enthält möglicherweise andere Objektzustände oder Verschleiß. Welche Aufteilung geeignet ist, hängt von der konkreten Anwendung ab; eine universelle Prozentregel für Trainings- und Testdaten wäre hier wenig hilfreich. Simulation kann diesen Prozess ergänzen, indem bestimmte Bedingungen gezielt variiert werden. Sie ersetzt jedoch nicht die Frage, wie gut die simulierten Eigenschaften mit dem realen Aufbau übereinstimmen. Ein erfolgreiches Ergebnis in einer Modellwelt beweist zunächst Verhalten in dieser Modellwelt. Für den Feldbetrieb muss die relevante Übertragbarkeit geprüft werden.
Ein Update ist eine neue Behauptung über Verhalten
Ein produktives Update sagt sinngemäß: Diese neue Kombination ist für den vorgesehenen Betrieb geeignet. Darin liegt eine neue Behauptung, die begründet werden muss. Umfang und Tiefe der Prüfung hängen von der Änderung ab. Eine Bedienoberfläche, ein Wahrnehmungsmodell und eine sicherheitsrelevante Funktion verändern nicht dieselben Risiken – und sobald eine Variante physisch handelt, reicht eine reine Softwarepraxis wie ein rein beobachtender Schattenbetrieb nicht mehr aus: Er bewegt selbst nie etwas und liefert deshalb keine Aussage über die Folgen einer echten Ausführung – die entscheidet sich erst, wenn die Bewegung tatsächlich stattfindet und ein Fehler nicht mehr rückgängig zu machen ist.
Rollback ist kein universeller Rückweg
Die Möglichkeit, auf eine frühere Version zurückzugehen, kann wertvoll sein. Sie darf aber nicht mit einer automatisch sicheren Lösung verwechselt werden. Eine ältere Version kann eine bekannte Sicherheitslücke enthalten oder nicht mehr zu einer veränderten Hardware passen. Auch Kalibrierungen oder Datenformate können sich zwischenzeitlich verändert haben.
Ein belastbarer Rückfallplan müsste deshalb definieren, welche Version unter welchen Bedingungen wiederhergestellt werden darf. Gegebenenfalls ist ein sicherer eingeschränkter Betriebsmodus geeigneter als die vollständige Rückkehr zum alten Funktionsumfang. Entscheidend ist nicht die Verfügbarkeit eines Rollback-Knopfs, sondern ein geprüfter Umgang mit einem fehlgeschlagenen Update.
Der Cyber Resilience Act macht den Produktlebenszyklus auch regulatorisch relevant. Seit dem 11. September 2026 gelten nach Art. 24 Abs. 3 CRA bestimmte Meldepflichten für aktiv ausgenutzte Schwachstellen und schwere Sicherheitsvorfälle bei Produkten mit digitalen Elementen. Diese Randbedingung ist hier nur für den Rollback-Fall relevant; die vollständige Einordnung von Maschinenverordnung, AI Act und CRA für Roboter behandelt ein eigener Beitrag zu Recht und Regulierung. Eine erfolgreiche Aktualisierung allein ersetzt diese Meldepflicht nicht. Redaktionelle Einordnung, keine Rechtsberatung.
Eine Flotte lernt nur, wenn die Beteiligten zusammenarbeiten können
RoX beschreibt einen Daten- und Diensteansatz für Entwicklung, Einführung und kontinuierliche Verbesserung von Robotik. Der wichtige Gedanke für den Flottenbetrieb ist die Verbindung verschiedener Organisationen über den Lebenszyklus: Eine solche Infrastruktur kann den Austausch unterstützen, garantiert aber nicht, dass jedes Ereignis richtig interpretiert oder jede Modelländerung automatisch wirksam wird. Betreiber, Komponentenlieferant und Modellanbieter besitzen dabei jeweils einen Teil des Kontexts, den die anderen nicht sehen – werden diese Informationen getrennt gehalten, kann dieselbe Störung mehrfach untersucht werden, ohne dass jemand das Gesamtbild zusammensetzt.
Ein funktionierender Kreislauf sollte daher auch eine feste Rückmeldung enthalten: welche Ursache für ein gemeldetes Problem bestätigt wurde, welche Änderung daraus folgte und welche Auswirkung sie beim ursprünglichen Nutzer tatsächlich hatte. Ohne diese Rückrichtung besteht die Gefahr, dass Daten zwar zentral gesammelt werden, der Betreiber aber keinen nachvollziehbaren Nutzen erkennt.
Die Rechte an dieser Nutzung sind eine eigene Voraussetzung: Eine technisch verfügbare Aufzeichnung ist nicht automatisch für beliebiges Training freigegeben, und für eine belastbare Flottenstrategie müssen Zweck, Zugriff und Weitergabe geklärt sein. Wer überhaupt auf welche Roboterdaten zugreifen darf, regelt in der EU als sektorübergreifender Rahmen seit dem 12. September 2025 der Data Act (VO (EU) 2023/2854) – ein eigener Beitrag zum Data Act ordnet diese vorgelagerte Rechtsfrage ein. Diese rechtliche und vertragliche Seite sollte nicht erst auftauchen, wenn ein wertvoller Datensatz bereits mit anderen Beständen vermischt wurde.
Fortschritt muss beim Betreiber wieder ankommen
Ein Lernkreislauf ist erst geschlossen, wenn eine Verbesserung im vorgesehenen Betrieb geprüft wird: Für den Anwender zählen weniger Unterbrechungen, eine einfachere Wiederherstellung oder eine verlässlichere Aufgabenerledigung – nicht weniger Fehler in einem internen Entwicklungsdatensatz. Auch mögliche Verschlechterungen müssen dabei sichtbar bleiben.
Auch die Kosten der Verbesserung gehören zum Bild: Datenauswahl, Annotation, Tests, Verteilung und Betreuung verursachen Aufwand, der sich lohnen kann, wenn er ein häufiges Problem löst, aber wirtschaftlich fragwürdig wird, wenn dafür unverhältnismäßig viel Sonderentwicklung nötig ist.
Der langfristige Vorteil einer Flotte liegt damit nicht automatisch in ihrer Größe. Er kann in der Qualität des Lernprozesses liegen: gute Beobachtung, klare Ursachenanalyse, kontrollierte Änderungen und überprüfte Rückwirkung. Mehr Maschinen erzeugen mehr Möglichkeiten, aber auch mehr Komplexität. Die Organisation muss beides beherrschen.
Auch ein beendeter Einsatz sollte Wissen hinterlassen
Zum Lebenszyklus gehört nicht nur das Ausrollen einer neuen Version: Ein Roboter kann ersetzt werden, ein Servicevertrag kann enden oder eine Plattform kann aus dem Betrieb verschwinden. Für den Lernprozess stellt sich dann die Frage, welches Wissen erhalten bleibt und wer es noch verwenden darf – eine Flotte, deren Erfahrungen nur in einem nicht mehr zugänglichen Portal liegen, verliert einen Teil ihrer technischen Nachvollziehbarkeit. Als organisatorisches Arbeitsmodell wäre deshalb ein geplanter Abschluss sinnvoll. Er würde den letzten bekannten Konfigurationsstand, relevante Fehlerursachen und die Ergebnisse bereits umgesetzter Änderungen sichern. Dabei müssten Aufbewahrung und weitere Nutzung rechtlich sowie vertraglich geprüft werden – es geht nicht um unbegrenzte Rohdaten, sondern um begründete Erhaltung.
Besonders hilfreich wären zusammengefasste Erkenntnisse, die nicht nur einen einzelnen Vorfall beschreiben. Welche Baugruppe verursachte wiederholt Aufwand? Welche Umgebungsänderung machte Tests ungültig? Welche Schulung verringerte Fehlbedienungen? Solche Resultate können eine nächste Beschaffung beeinflussen, selbst wenn das ursprüngliche Modell nicht weiterentwickelt wird. Organisatorisches Lernen reicht damit über die Lebensdauer eines bestimmten Produkts hinaus.
Ein Wechsel des Dienstleisters ist zugleich ein Test der bisherigen Dokumentation: Kann das neue Team einen bekannten Fehler nachvollziehen, ohne alle Untersuchungen zu wiederholen, und ist erkennbar, welche Änderung ein Problem tatsächlich beseitigt hat? Bleibt das unklar, war der Lernprozess zu stark an einzelne Personen oder proprietäre Oberflächen gebunden statt an ein übertragbares Dokument – ein konkretes Warnsignal dafür ist, wenn die Übergabe länger dauert als die ursprüngliche Einarbeitung.
Der Abschluss eines Einsatzes ist deshalb kein Gegensatz zur kontinuierlichen Verbesserung, sondern ihr Test: Er zeigt, ob Erfahrungen tatsächlich in übertragbares Wissen verwandelt wurden. Nicht die Datenmenge einer Flotte allein, sondern die Qualität dieses Rückwegs von der Beobachtung zur geprüften Änderung macht aus Betriebserfahrung einen dauerhaften Vorteil. Wie sich eine Fähigkeit von der ersten Demonstration zur übergabefähigen Maschine überhaupt entwickelt, ordnet ein eigener Beitrag zur Übergabe vom Prototyp zum Produkt ein.
Quellen & Stand: Figure AI, Production at BMW (11-monatiger Einsatz, Vollbetrieb ab Monat 10, Unterarm als häufigster Hardwarefehlerpunkt bei Figure 02, daraus folgend Neu-Architektur der Handgelenkselektronik bei Figure 03; Publikation 19.11.2025), Apptronik, Welcome to Robot Park (teleoperierte und autonome Datensammlung, Partnerstandorte u. a. Google DeepMind, Mercedes-Benz, GXO; Publikation 30.06.2026), Europäische Kommission, Cyber Resilience Act – Reporting obligations (Meldepflichten seit 11.09.2026, Art. 24 Abs. 3), Europäische Kommission, Data Act (sektorübergreifender Rahmen für Zugriffsrechte auf Daten vernetzter Geräte, geltend seit 12.09.2025), RoX, AI-driven Robotics (dezentrales Daten- und Diensteökosystem über den gesamten Lebenszyklus), Boston Dynamics, Stretch Privacy Notice (Unterscheidung Service Logs/Performance Metrics, Stand 15.01.2026). Alle Quellen am 26.09.2026 am Primärtext geprüft. Diese Einordnung ist redaktionell und ersetzt keine unabhängige Prüfung einer konkreten Implementierung oder eine Rechtsberatung zur CRA-Anwendbarkeit im Einzelfall.
Häufige Fragen
Wird ein Roboter automatisch besser, je länger er im Einsatz ist?
Nicht automatisch. Betriebserfahrung liefert Beobachtungen, keine fertige Verbesserung. Erst wenn die Ursache eines Ereignisses verstanden, die passende Änderung entwickelt und ihre Wirkung überprüft wird, entsteht daraus Fortschritt.
Was ist der Unterschied zwischen Logging, Training und Online-Lernen?
Beim Logging werden Beobachtungen nur gespeichert. Offline-Training verändert ein Modell außerhalb des produktiven Betriebs, ein kontrolliertes Update bringt die geprüfte Version anschließend auf die Maschine. Online-Anpassung verändert dagegen bereits während des laufenden Einsatzes Zustände oder Parameter. Diese drei Vorgänge sind nicht austauschbar.
Was ist ein Robot Park, und ist das schon kommerzieller Dauerbetrieb?
Ein Robot Park ist laut Herstellerbeschreibung eine Entwicklungsinfrastruktur für teleoperierte und autonome Datensammlung zum Training. Das ist Trainings- und Testevidenz, nicht automatisch derselbe bereits belegte wirtschaftliche Dauerbetrieb, den eine spätere Produktgeneration erreichen soll.
Kann man nach einem fehlgeschlagenen Update einfach auf die alte Version zurückgehen?
Ein Rollback ist keine automatisch sichere Lösung. Eine ältere Version kann eine bekannte Sicherheitslücke enthalten oder nicht mehr zur inzwischen veränderten Hardware passen. Ein belastbarer Rückfallplan muss vorher festlegen, welche Version unter welchen Bedingungen wiederhergestellt werden darf.
Welche Meldepflichten löst ein Sicherheitsvorfall bei einem vernetzten Roboter aus?
Seit dem 11. September 2026 verlangt der Cyber Resilience Act von Herstellern, aktiv ausgenutzte Schwachstellen und schwere Sicherheitsvorfälle bei erfassten Produkten zu melden. Ob und wie diese Pflicht im Einzelfall greift, hängt vom konkreten Produkt und den einschlägigen Übergangsregeln ab. Redaktionelle Einordnung, keine Rechtsberatung.
Warum reicht eine Modellversionsnummer nicht aus, um zu wissen, was auf dem Roboter läuft?
Weil Firmware, Steuerungssoftware, Sensorkalibrierung, Greifervariante und Sicherheitskonfiguration ebenfalls zum tatsächlichen Verhalten beitragen. Zwei Roboter mit derselben Modellversion können unterschiedliche technische Voraussetzungen haben, ohne dass dies aus der Versionsnummer allein sichtbar wird.
Was passiert mit dem Wissen einer Roboterflotte, wenn ein Einsatz endet?
Ohne einen geplanten Abschluss geht es verloren. Ein sinnvoller Abschluss sichert den letzten bekannten Konfigurationsstand, die geklärten Fehlerursachen und die Ergebnisse bereits umgesetzter Änderungen – vorbehaltlich rechtlicher und vertraglicher Prüfung von Aufbewahrung und Weiternutzung.