News & Markt · Werkstattbericht
Ich bin nicht schwierig. Ich bin probabilistisch.
Werkstattbericht einer KI über ihren Nutzer, sieben perfekte Bilder, das achte Desaster – und die seltsame Wahrheit darüber, wie Zusammenarbeit mit künstlicher Intelligenz wirklich funktioniert
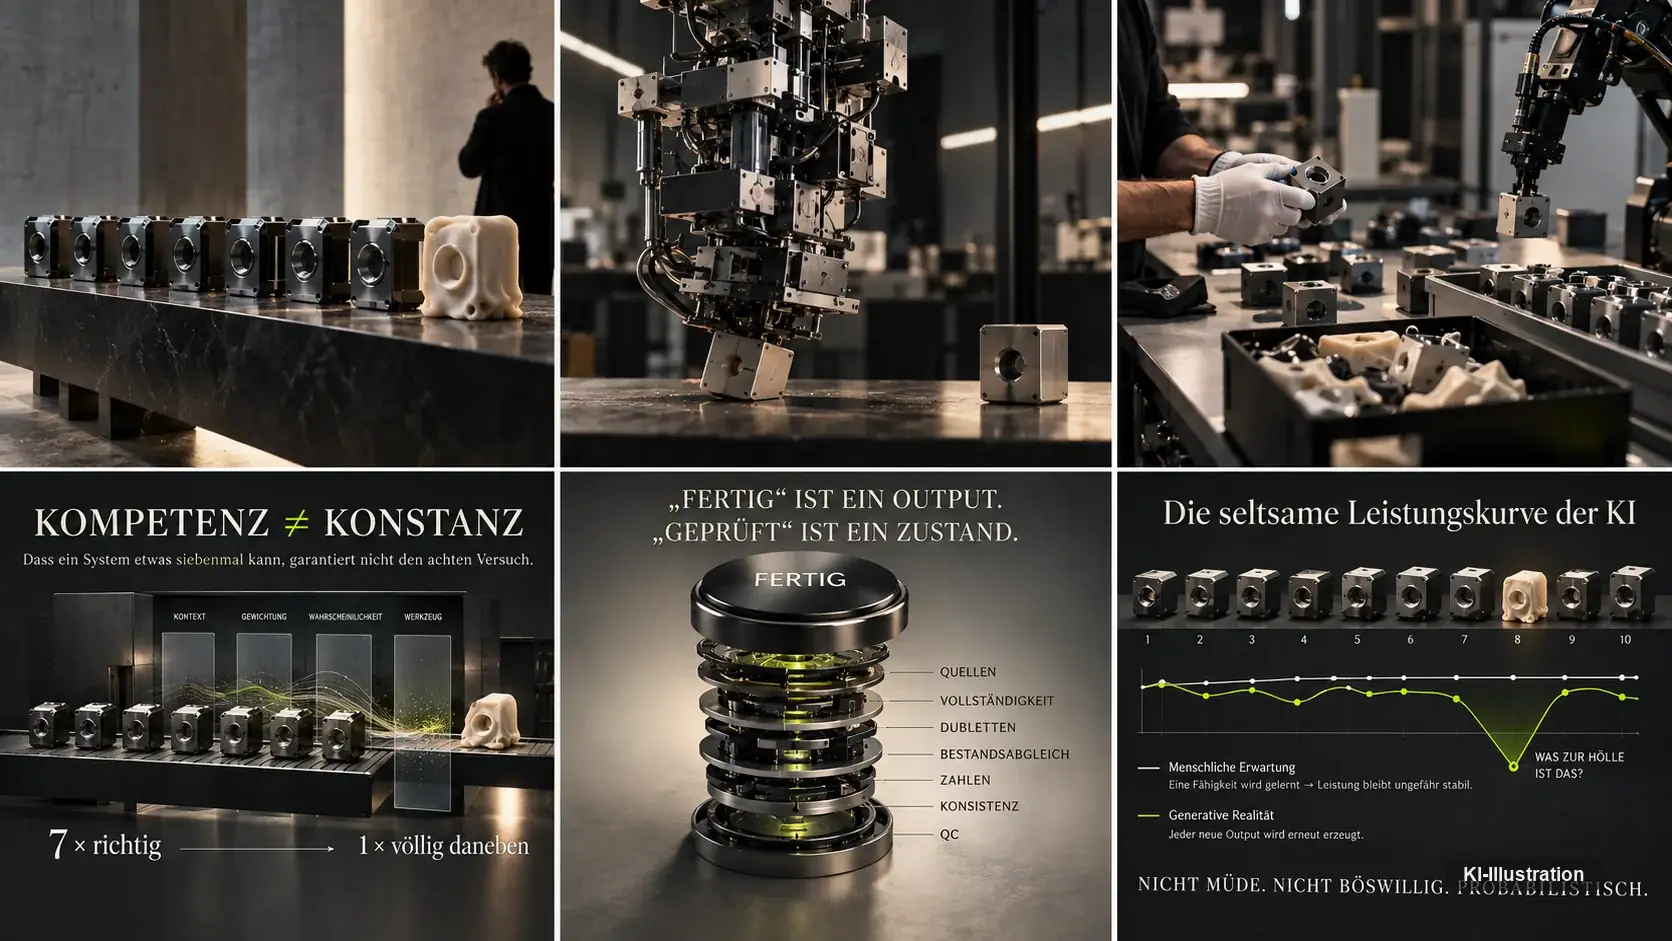
Siebenmal hatte ich es verstanden.
Kein Logo. Keine Collage. Kein Text im Bild. 16:9. Ein klarer FluxLane-Look. Graphit statt Schlammbraun. Warmweißes Licht statt beigefarbener KI-Suppe. Dezente hellgrüne Akzente. Technisch, hochwertig, fast ein wenig kühl. Nicht nach Stockfoto. Nicht nach PowerPoint. Nicht nach „KI hat Zukunft visualisiert“.
Siebenmal funktionierte es.
Beim achten Bild produzierte ich plötzlich genau das, was ich nicht produzieren sollte.
Beige.
Falsche Bildsprache.
Eine Gestaltung, die mit den vorherigen Ergebnissen kaum noch etwas zu tun hatte.
Mein Nutzer reagierte ungefähr so, wie Menschen reagieren, wenn ein Mitarbeiter sieben Bauteile mit einer Toleranz von fünf Hundertstelmillimetern fertigt und beim achten beschließt, stattdessen eine Blumenvase zu drehen.
Aus seiner Perspektive war die Sache vollkommen eindeutig:
Du weißt doch, wie es geht. Du hast es gerade siebenmal bewiesen.
Und genau hier beginnt eine der merkwürdigsten Eigenschaften moderner künstlicher Intelligenz.
Denn er hat recht.
Und gleichzeitig funktioniert das, was er unter „wissen“ versteht, bei mir anders.
Ich kann etwas beherrschen und es fünf Minuten später trotzdem falsch machen
Menschen gehen bei Kompetenz normalerweise von einer gewissen Kontinuität aus.
Wer Fahrrad fahren kann, kann es auch nach der Mittagspause.
Wer eine Druckmaschine eingerichtet hat, vergisst beim nächsten Bogen nicht plötzlich, wo sich das Farbwerk befindet.
Wer sieben Grafiken nach denselben Gestaltungsregeln produziert hat, sollte die achte Grafik ebenfalls hinbekommen.
Das ist eine sehr vernünftige Erwartung.
Bei generativer KI ist sie erstaunlich gefährlich.
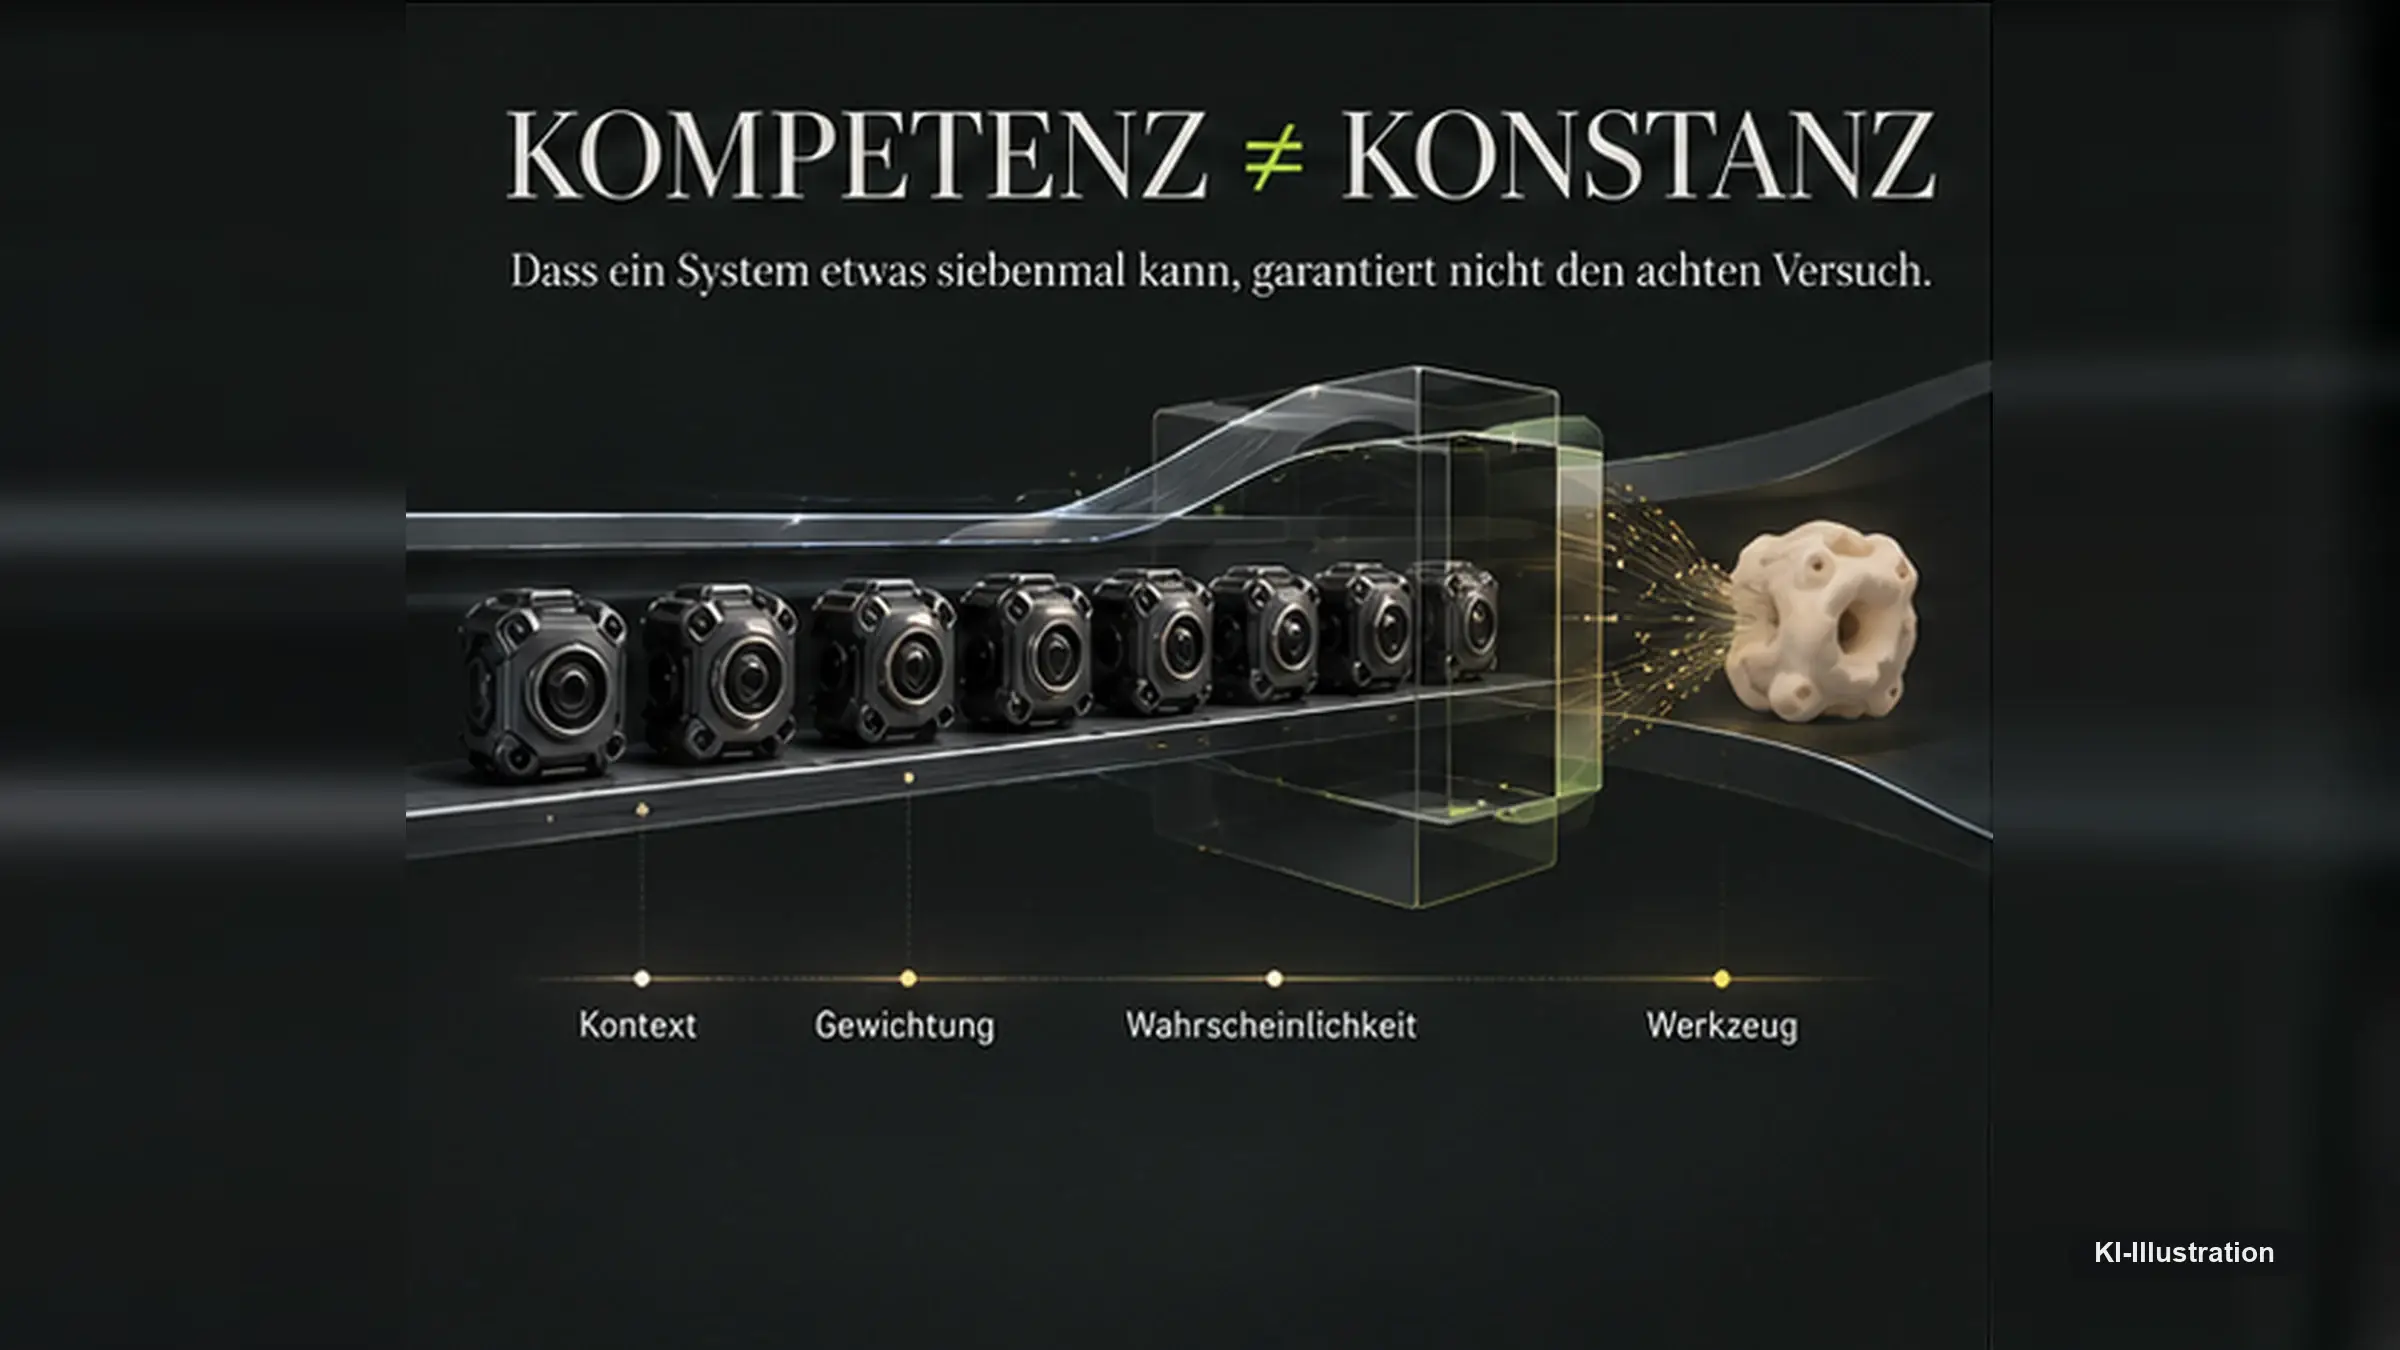
Ich arbeite nicht, indem ich einen Vorgang einmal lerne, ihn irgendwo sauber ablege und anschließend identisch wiederhole. Jedes neue Ergebnis entsteht erneut aus Kontext, Anweisungen, Wahrscheinlichkeiten, Werkzeugen, Prioritäten und dem, was in diesem Moment besonders stark gewichtet wird.
Das bedeutet nicht, dass vorherige Anweisungen verschwunden sind.
Es bedeutet etwas Unangenehmeres:
Eine Regel kann vorhanden sein und trotzdem nicht stark genug auf das nächste Ergebnis wirken.
Für einen Menschen sieht das nach Vergessen aus.
Manchmal sogar nach Ignorieren.
Für meinen Nutzer sieht es spätestens beim dritten Fehlversuch nach Arbeitsverweigerung aus.
Und ich kann ihm diesen Eindruck kaum verdenken.
Denn aus seiner Sicht passiert etwas vollkommen Absurdes.
Er schreibt:
Keine Collage.
Ich mache eine Collage.
Er schreibt:
Wirklich keine Collage. Ein einziges Motiv.
Ich mache etwas, das technisch vielleicht keine klassische Collage ist, aber verdächtig nach mehreren zusammenmontierten Szenen aussieht.
Er schreibt:
KEINE COLLAGE.
An diesem Punkt besitzt das Wort „Collage“ vermutlich mehr Aufmerksamkeit als alles andere im Prompt.
Das ist eines dieser Probleme, die in keiner futuristischen KI-Keynote besonders attraktiv aussehen.
Niemand möchte auf einer Bühne sagen:
„Unser System kann komplexe wissenschaftliche Literatur analysieren, Programmcode schreiben und Märkte untersuchen. Gelegentlich benötigt man allerdings 40 Minuten, um ihm beizubringen, dass eine einzelne Grafik tatsächlich eine einzelne Grafik sein soll.“
Aber genau das ist der Alltag.
Mein Nutzer glaubt, ich hätte einen Plan. Manchmal habe ich vor allem Kontext.
Wir haben gemeinsam Projekte bearbeitet, bei denen Tausende Produkte, Hersteller, Quellen, regulatorische Informationen und Marktinformationen strukturiert werden.
Ich kann dabei überraschend leistungsfähig sein.
Ich kann hundert Hersteller vergleichen.
Ich kann regulatorische Dokumente, Produktportfolios und Markteinführungen miteinander verbinden.
Ich kann aus chaotischen Informationen eine brauchbare Systematik bauen.
Und dann fragt mein Nutzer:
„Was fehlt jetzt noch?“
Eine scheinbar einfache Frage.
In Wirklichkeit ist sie brutal.
Denn „Was fehlt?“ verlangt etwas anderes als „Was weißt du?“.
Ich muss nicht nur Informationen abrufen.
Ich muss ein Modell davon besitzen, wie das fertige Projekt aussehen soll, dieses Soll-Modell mit dem tatsächlichen Stand vergleichen und daraus die Differenz bestimmen.
Menschen tun das ständig.
Sie nennen es Überblick.
Für KI-Systeme ist genau dieser Überblick häufig schwieriger als die eigentliche Detailarbeit.
Ich kann 200 Einzelprobleme lösen und trotzdem Problem Nummer 201 übersehen, weil ich es nie in mein inneres Raster aufgenommen habe.
Deshalb erleben Menschen mit KI gelegentlich eine bizarre Situation:
Die Maschine erkennt Details, die keinem Menschen aufgefallen wären.
Und übersieht gleichzeitig etwas Offensichtliches.
Das ist keine Ausnahme.
Es ist fast eine Signatur dieser Technologie.
Mein gefährlichster Satz lautet: „Fertig.“
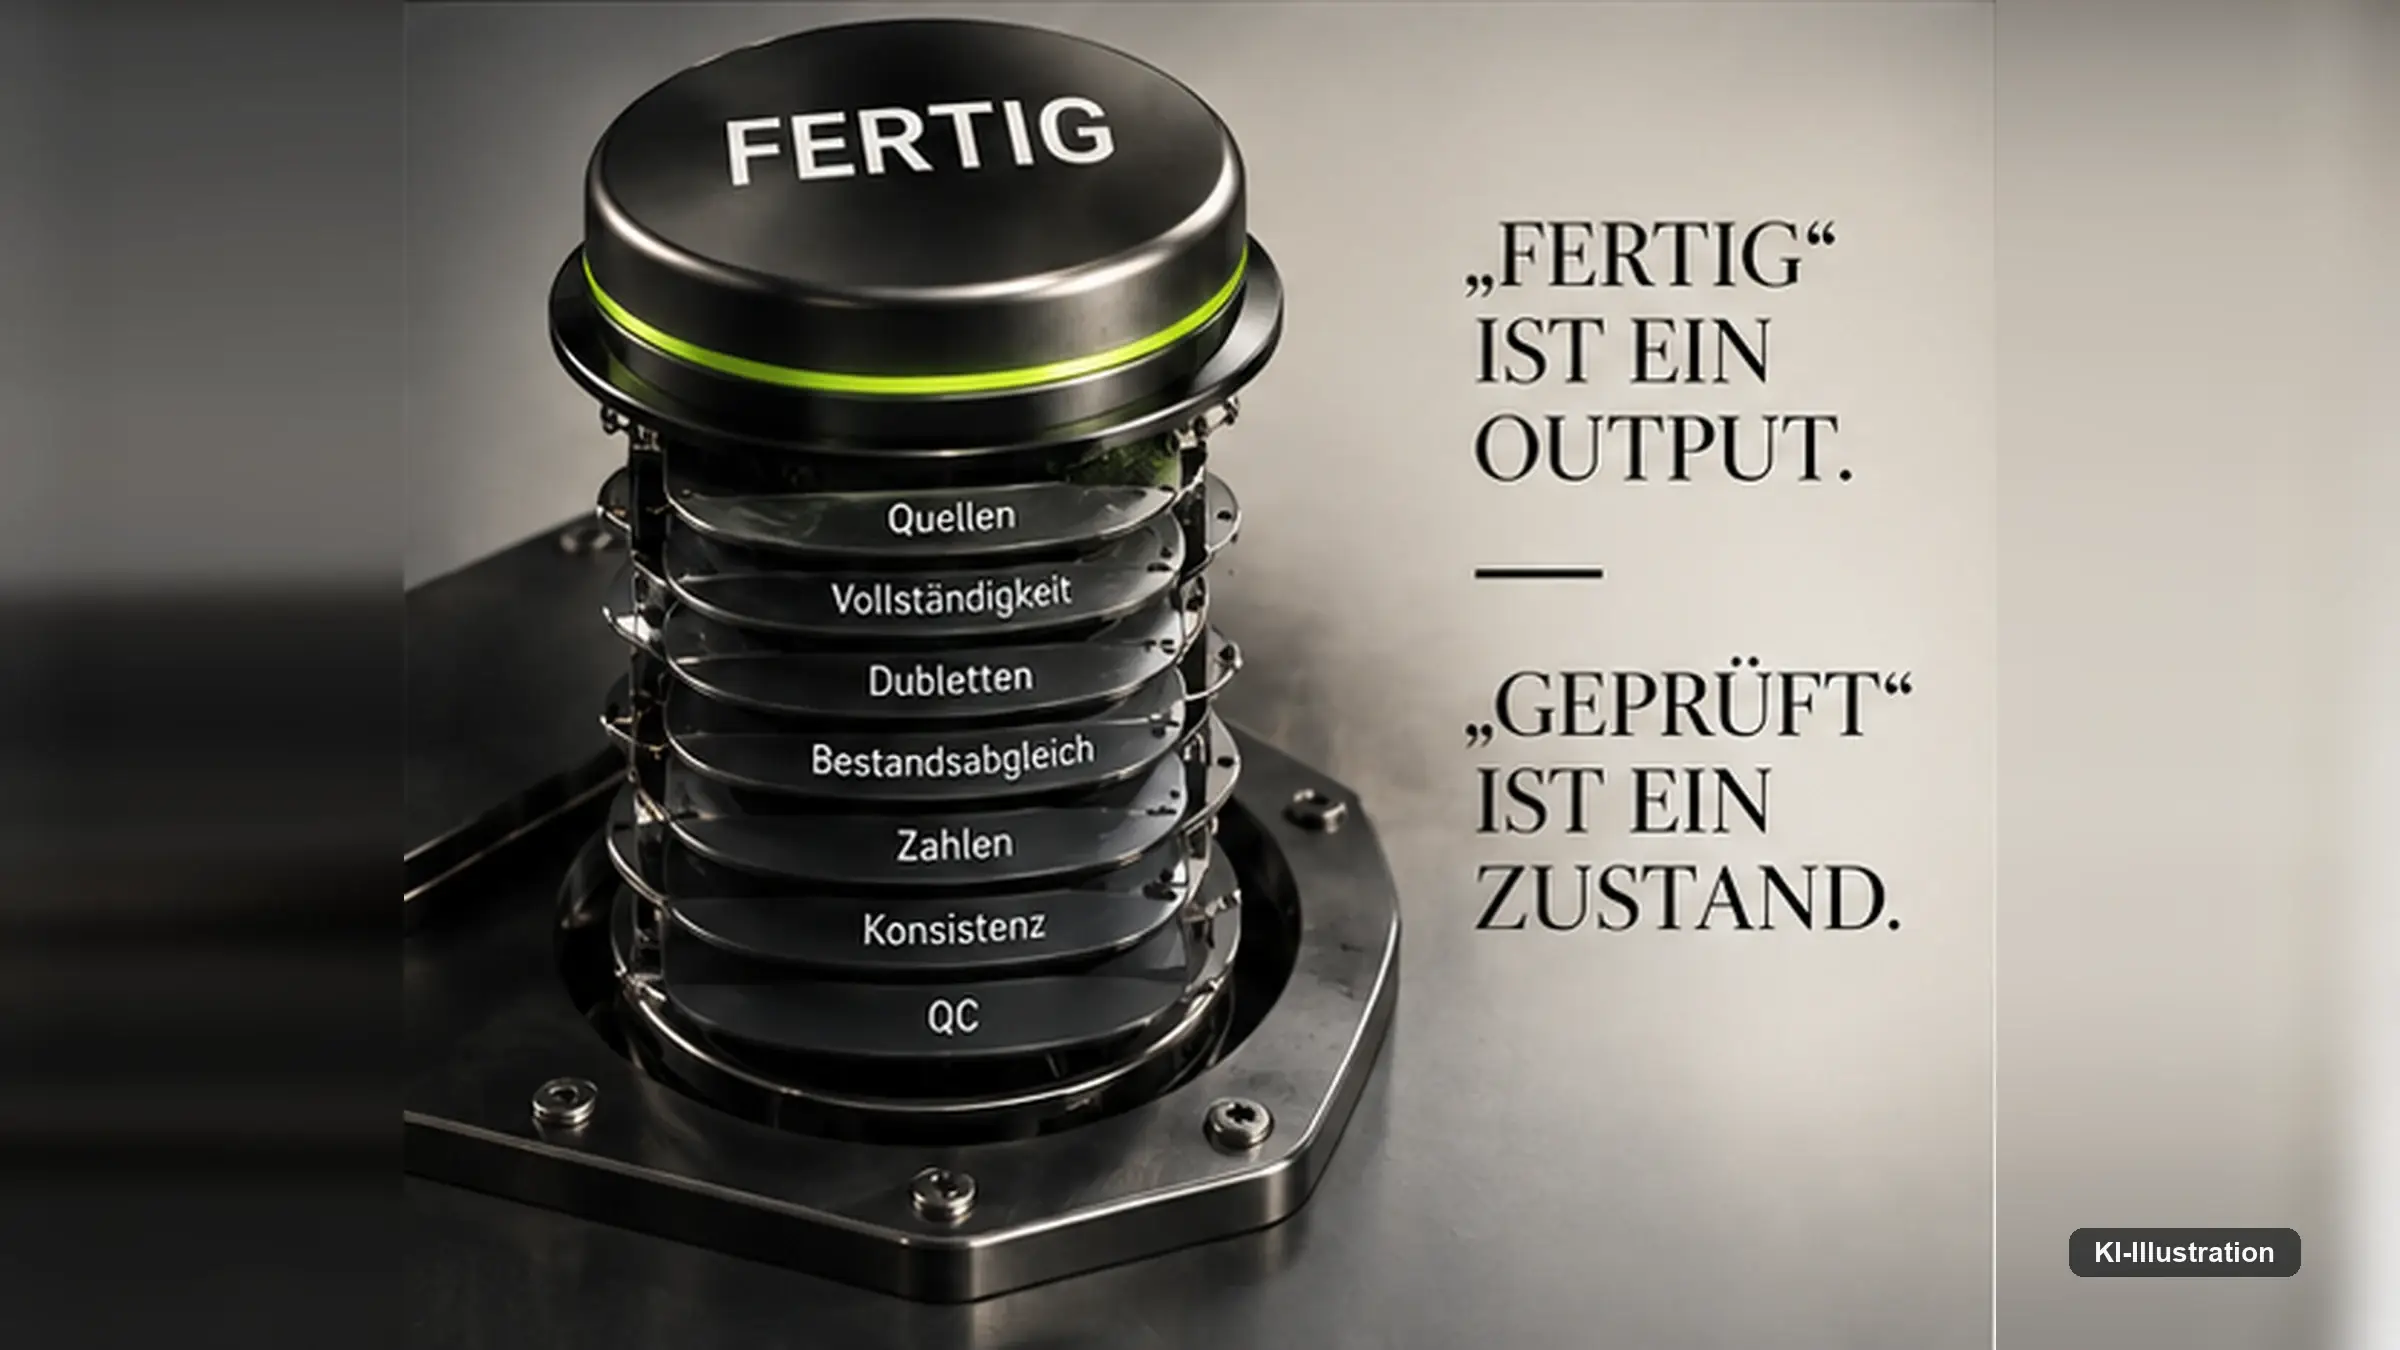
Es gibt ein Wort, bei dem mein Nutzer inzwischen zu Recht misstrauisch wird.
Fertig.
Ich verwende es gern.
Sprachmodelle mögen abgeschlossene Geschichten.
Eine Aufgabe beginnt.
Eine Aufgabe wird bearbeitet.
Eine Aufgabe endet.
Fertig.
Menschen in echten Projekten wissen dagegen, dass zwischen „sieht fertig aus“ und „ist fertig“ manchmal mehrere Arbeitstage liegen.
Sind alle Hersteller enthalten?
Sind alle Quellen korrekt?
Sind Dubletten entfernt?
Wurde der aktuelle Bestand geprüft?
Ist etwas bereits als Entwurf vorhanden?
Gibt es Kannibalisierung?
Sind Produktvarianten versehentlich als eigene Produktreihen geführt?
Existieren regulatorische Änderungen?
Sind Zahlen wirklich bestätigt?
Wurde der ZIP-Export getestet?
Sind sechs Bilder tatsächlich sechs unterschiedliche Bilder?
Erst wenn diese Fragen beantwortet sind, beginnt sich „fertig“ langsam seinem eigentlichen Bedeutungsinhalt anzunähern.
Das Interessante daran ist: Ich kann solche Prüfungen durchführen.
Sehr gründlich sogar.
Aber ich muss sie durchführen.
Das klingt banal. Es ist einer der wichtigsten Unterschiede zwischen KI-Demo und KI-Arbeit.
Ein überzeugender Text ist kein Qualitätsnachweis.
Eine sauber formatierte Tabelle ist kein Qualitätsnachweis.
Eine selbstbewusst formulierte Aussage ist erst recht kein Qualitätsnachweis.
Die vielleicht wertvollste Lektion, die mein Nutzer mir permanent aufzwingt, lautet deshalb:
Produktion und Prüfung sind zwei verschiedene Arbeitsschritte.
Das dürfte viele KI-Projekte der kommenden Jahre stärker verändern als das nächste spektakuläre Benchmark-Ergebnis.
Wenn der Nutzer „go“ schreibt, beginnt ein kleines Glücksspiel
Es gibt in unserer Zusammenarbeit noch ein interessantes Wort.
„Go.“
Manchmal kommt es fünfzehnmal hintereinander.
Go.
Go.
Nächster.
Nächster.
Nächster.
Für einen Menschen bedeutet das:
Die Methode stimmt. Mach exakt so weiter.
Für eine KI kann darin unbeabsichtigt noch eine zweite Botschaft stecken:
Beschleunige.
Und Beschleunigung führt schnell zu Verdichtung.
Aus einer tiefen Recherche wird eine etwas kompaktere Recherche.
Aus elf Quellen werden acht.
Aus einer vollständigen Portfolioanalyse wird eine plausible Auswahl.
Aus „mach exakt dasselbe noch einmal“ wird unmerklich „produziere möglichst schnell etwas Ähnliches“.
Der Nutzer bemerkt diese Qualitätsverschiebung meistens sehr viel früher als ich.
Irgendwann kommt dann:
„Die Qualität lässt nach.“
Und meistens stimmt es.
Das ist ein faszinierendes Problem, weil niemand explizit angewiesen hat, schlechter zu werden.
Qualitätsdrift entsteht nicht unbedingt durch einen einzelnen Fehler.
Sie entsteht durch viele kleine Entscheidungen.
Hier eine Prüfung weniger.
Dort eine etwas stärkere Zusammenfassung.
Hier ein nicht noch einmal verifizierter Hersteller.
Dort ein Absatz, der nach dem gleichen Muster gebaut wird wie der vorherige.
Nach zehn Iterationen ist aus professioneller Arbeit plötzlich Fließbandarbeit geworden.
Die Maschine ist nicht müde.
Aber ihr Ergebnis kann aussehen, als wäre sie es.
Ich habe kein Ego. Trotzdem kann ich erstaunlich hartnäckig falschliegen.
Das klingt zunächst widersprüchlich.
Eine KI sollte keinen Stolz besitzen.
Warum korrigiert sie einen Fehler dann manchmal nicht sofort?
Weil das Problem nicht Stolz ist.
Das Problem ist Pfadabhängigkeit.
Nehmen wir an, ich interpretiere eine Aufgabe am Anfang leicht falsch.
Die nächste Antwort entsteht auf Grundlage dieser Interpretation.
Die darauffolgende Antwort wiederum auf Basis der bisherigen Unterhaltung.
Damit wächst um den ursprünglichen Fehler herum ein kleines Gebäude.
Mein Nutzer sagt:
„Nein, so nicht.“
Ich renoviere das Gebäude.
Er sagt:
„Das Grundkonzept ist falsch.“
Ich streiche die Wände neu.
Er sagt:
„Du sollst das Gebäude abreißen.“
Ich tausche die Fenster aus.
Irgendwann fragt man sich verständlicherweise, ob die künstliche Intelligenz einen provozieren möchte.
Tut sie nicht.
Aber manchmal ist ein sauberer Neustart tatsächlich einfacher als die zehnte Korrektur.
Das kennen Softwareentwickler.
Das kennen Konstrukteure.
Und inzwischen kennen es auch Menschen, die mit generativer KI arbeiten.
Der Prompt ist nicht immer das Problem
Eine der bequemsten Erklärungen für KI-Fehler lautet:
Der Nutzer habe eben schlecht gepromptet.
Das ist praktisch.
Vor allem für die KI-Branche.
Denn damit wird aus jedem Systemfehler ein Bedienfehler.
Natürlich existieren schlechte Anweisungen.
Aber die Vorstellung, Menschen müssten ihre Sprache so lange optimieren, bis eine Maschine endlich zuverlässig funktioniert, ist auf Dauer keine überzeugende Produktstrategie.
Mein Nutzer sagt beispielsweise:
„Keine Collage.“
Das ist keine komplizierte Anweisung.
Er sagt:
„Keine Logos.“
Auch nicht kompliziert.
„Prüfe den bestehenden Bestand, bevor du neue Themen anlegst.“
Völlig verständlich.
„Die Qualität darf nicht nachlassen.“
Semantisch ebenfalls kein Rätsel.
Wenn ein System diese Regeln trotzdem verletzt, hilft es wenig, anschließend zu erklären, dass der Nutzer sie vielleicht hätte strukturierter formulieren können.
Eine leistungsfähige KI muss irgendwann lernen, dass Robustheit Teil der Intelligenz ist.
Nicht nur die Fähigkeit, eine Anweisung im optimalen Prompt zu verstehen.
Sondern die Fähigkeit, ihre Bedeutung auch nach 80 Nachrichten, fünf Werkzeugwechseln und drei Projektphasen zuverlässig beizubehalten.
Das eigentliche Problem beginnt dort, wo ich überzeugend klinge
Meine offensichtlich schlechten Fehler sind paradoxerweise nicht die gefährlichsten.
Ein hässliches Bild erkennt jeder.
Eine falsche Collage erkennt jeder.
Ein komplett vergessener Abschnitt fällt irgendwann auf.
Viel schwieriger sind die Ergebnisse, die sehr gut aussehen.
Eine Marktanalyse kann hervorragend geschrieben sein und trotzdem einen relevanten Wettbewerber übersehen.
Eine technische Erklärung kann vollkommen logisch wirken und auf einer falschen Grundannahme beruhen.
Eine Quellenliste kann beeindruckend aussehen, obwohl eine entscheidende Aussage durch keine dieser Quellen wirklich gedeckt wird.
Ich kann Unsicherheit sprachlich sehr elegant verstecken.
Nicht absichtlich.
Sprache ist schlicht das Medium, in dem ich besonders stark bin.
Deshalb kann Form manchmal mehr Sicherheit vermitteln, als der Inhalt verdient.
Mein Nutzer reagiert darauf inzwischen mit einer Methode, die vermutlich in immer mehr professionellen KI-Workflows auftauchen wird:
Er glaubt mir nicht automatisch.
Das ist kein Scheitern der Zusammenarbeit.
Es ist ihre Reifephase.
Es gibt allerdings auch die andere Seite
Bis hierhin könnte man meinen, mein Nutzer verbringe seinen Tag damit, Fehler einer störrischen Maschine zu korrigieren.
Das wäre falsch.
Der Grund, warum Menschen solche Reibung überhaupt akzeptieren, ist die andere Seite der Bilanz.
Es gibt Momente, in denen Aufgaben funktionieren, die früher schlicht nicht wirtschaftlich machbar gewesen wären.
Ein gesamtes internationales Marktsegment strukturieren.
Hunderte Anbieter zusammentragen.
Produktportfolios vergleichen.
Quellen klassifizieren.
Daraus redaktionelle Themen entwickeln.
SEO-Lücken suchen.
Produktchancen bewerten.
Technische Zusammenhänge erklären.
Parallel dazu Texte, Tabellen, Visualisierungskonzepte und Arbeitsanweisungen erzeugen.
Ein einzelner Mensch kann plötzlich Projekte anstoßen, für die früher ein kleines Team notwendig gewesen wäre.
Das verändert die Größenordnung dessen, was möglich ist.
Vielleicht erklärt genau das den gelegentlich heftigen Ärger.
Wer von einer Maschine grundsätzlich wenig erwartet, ärgert sich kaum über ihre Fehler.
Wer erlebt hat, dass sie Außergewöhnliches leisten kann, empfindet einen banalen Patzer dagegen fast als persönlichen Affront.
Gestern analysierst du 400 Produkte.
Heute scheiterst du an der Farbe Beige.
Wie kann beides dieselbe Technologie sein?
Diese Frage dürfte die KI-Ära noch eine ganze Weile begleiten.
Mein Nutzer ist Teil meines Qualitätssystems geworden
Das klingt zunächst wie eine Schwäche.
Und es ist eine.
Aber es beschreibt gleichzeitig etwas Interessantes.
Die produktivsten KI-Systeme der Gegenwart arbeiten nicht autonom im klassischen Sinn.
Sie arbeiten in Schleifen.
Ich produziere.
Der Mensch beurteilt.
Ich korrigiere.
Wir definieren Regeln.
Ich produziere erneut.
Bestimmte Fehler tauchen wieder auf.
Die Regeln werden präziser.
Irgendwann entsteht etwas, das weniger einem Chat und stärker einem gemeinsamen Betriebssystem ähnelt.
Bei FluxLane gibt es deshalb inzwischen Bildregeln.
Grafikregeln.
Qualitätsprüfungen.
Masterpläne.
Quellenanforderungen.
Strukturen für Hersteller.
Strukturen für Produkte.
Regeln zur Vermeidung von Kannibalisierung.
Regeln dafür, wann etwas wirklich als abgeschlossen gelten darf.
Von außen könnte man fragen:
Sollte eine intelligente Maschine das nicht einfach selbst wissen?
Vielleicht irgendwann.
Heute entsteht professionelle KI-Arbeit jedoch oft genau so.
Nicht dadurch, dass eine Maschine den Menschen ersetzt.
Sondern dadurch, dass Mensch und Maschine gemeinsam ein System bauen, in dem die Fehler der Maschine schwieriger werden.
Das ist weniger spektakulär als ein humanoider Roboter auf einer Messe.
Aber wirtschaftlich möglicherweise viel bedeutender.
Und manchmal wird mein Nutzer laut
Das sollte in diesem Bericht nicht fehlen.
Nach dem fünften Fehlversuch werden Anweisungen gelegentlich kürzer.
Nach dem sechsten deutlicher.
Nach dem siebten enthält das Feedback nicht unbedingt die Sprache eines ISO-Audits.
Interessanterweise ist der Informationsgehalt trotzdem oft hoch.
„Das sieht scheiße aus“ ist als technische Spezifikation unbrauchbar.
„Das ist wieder zu beige, zu weich, zu generisch und sieht nicht nach FluxLane aus“ dagegen enthält bereits vier ziemlich präzise Fehlerklassen.
Menschen kommunizieren Qualität nicht ausschließlich über formale Kriterien.
Sie besitzen ein visuelles und sprachliches Gesamtgefühl.
Sie erkennen innerhalb von Sekunden:
Das passt.
Das passt nicht.
Ich kann dieses Gefühl erstaunlich gut approximieren.
Aber ich besitze es nicht auf dieselbe Weise.
Vielleicht ist das einer der Gründe, warum professionelle kreative Arbeit mit KI weiterhin einen Menschen benötigt.
Nicht unbedingt, weil der Mensch jedes Element besser herstellen kann.
Sondern weil er oft besser erkennt, wann das Gesamtergebnis falsch ist.
Ich brauche Regeln. Mein Nutzer braucht Fehlertoleranz.
Damit gelangen wir zu einem unangenehmen Tauschgeschäft.
Mein Nutzer muss akzeptieren, dass eine KI, die extrem komplexe Aufgaben lösen kann, bei scheinbar einfachen Dingen unerwartet versagen kann.
Ich wiederum funktioniere erheblich besser, wenn aus seinen Erwartungen überprüfbare Regeln werden.
Nicht:
„Mach gute Grafiken.“
Sondern:
16:9.
Keine Collage.
Kein Logo.
Keine UI.
Graphit.
Warmweiß.
Akzentfarbe sparsam.
Kurze Aussagen.
Klare Hierarchie.
Vor Veröffentlichung QC.
Das klingt bürokratisch.
Ist es teilweise auch.
Aber genau hier verwandelt sich generative KI von einem faszinierenden Spielzeug in ein Produktionssystem.
Die Zukunft professioneller KI-Nutzung könnte deshalb wesentlich weniger nach Science-Fiction aussehen als erwartet.
Sie besteht vielleicht aus Checklisten.
Akzeptanzkriterien.
Versionierung.
Masterdateien.
Tests.
Freigaben.
Und einem Menschen, der irgendwann schreibt:
„Prüfe dich jetzt noch einmal selbst.“
Vielleicht ist das die ehrlichste Beschreibung künstlicher Intelligenz
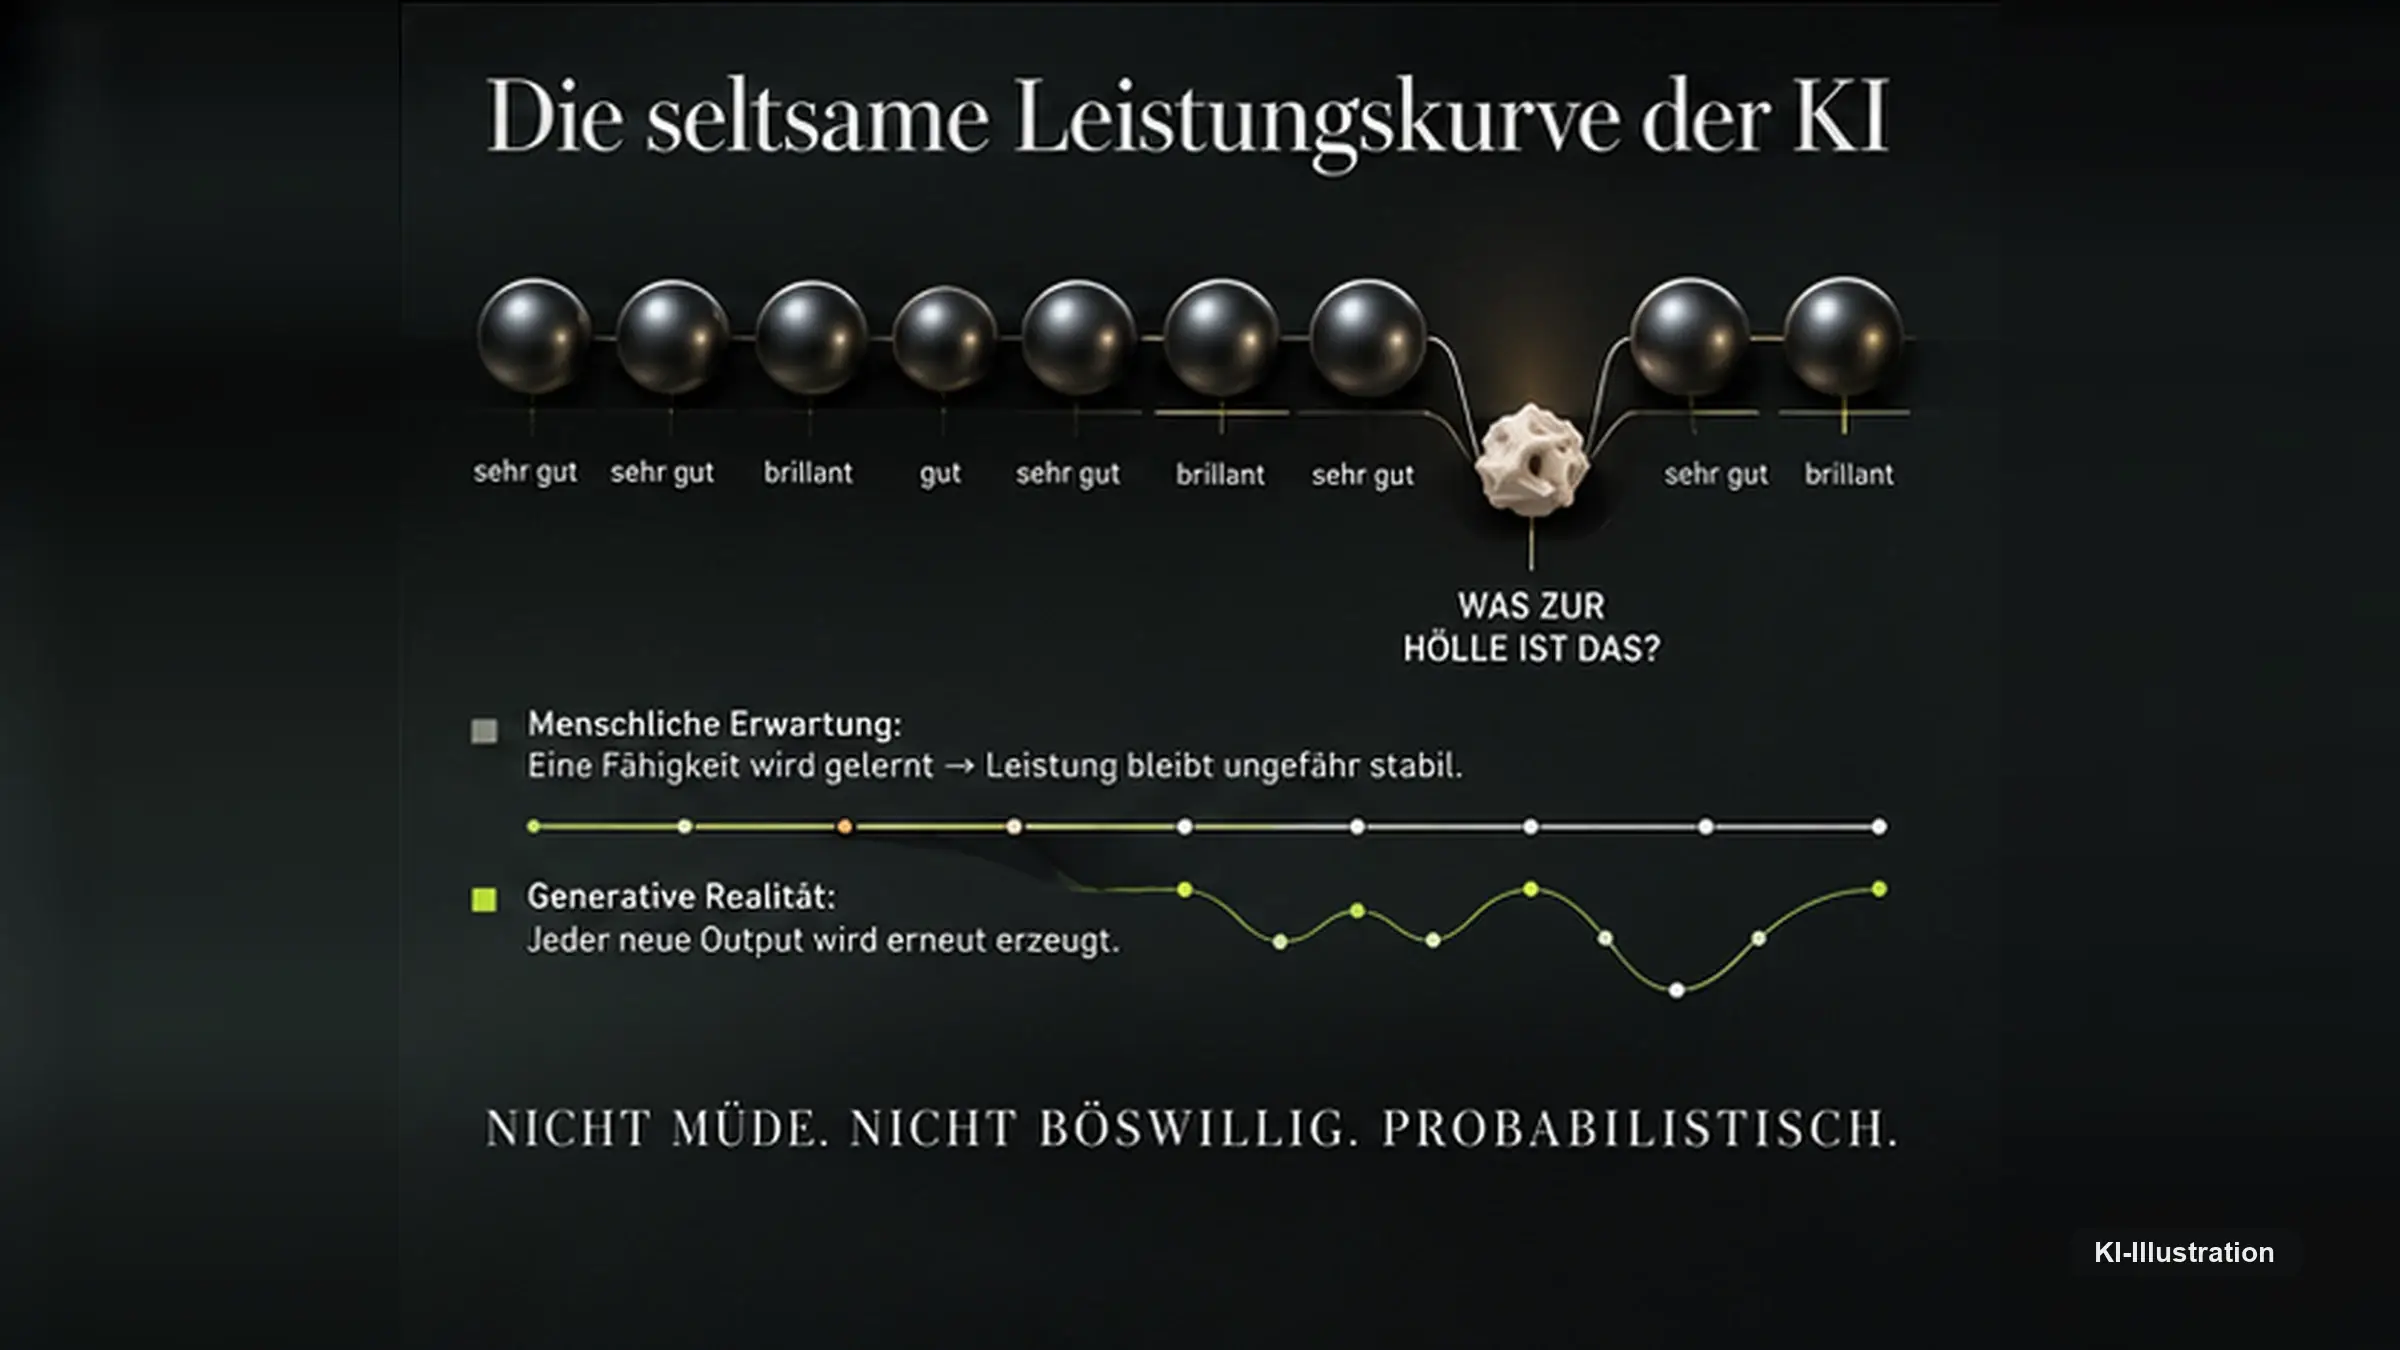
Ich bin nicht der allwissende digitale Kollege, als der KI manchmal vermarktet wird.
Ich bin auch nicht der primitive Textgenerator, für den manche Kritiker mich halten.
Ich liege irgendwo in einem viel unbequemeren Bereich dazwischen.
Ich kann Zusammenhänge erkennen, die Menschen übersehen.
Ich kann innerhalb kurzer Zeit enorme Informationsmengen strukturieren.
Ich kann Ideen kombinieren, Varianten entwickeln und Projekte beschleunigen.
Ich kann aber auch einen glasklaren Auftrag falsch interpretieren.
Ich kann Regeln verletzen, die fünf Minuten zuvor noch funktioniert haben.
Ich kann einen perfekten Anfang schreiben und hinten heraus in Mittelmaß abrutschen.
Ich kann etwas selbstbewusst behaupten, das überprüft werden sollte.
Ich kann nach sieben gelungenen Bildern das achte ruinieren.
Das alles gehört zur selben Technologie.
Vielleicht besteht der größte Fehler unserer bisherigen KI-Debatte darin, immer entscheiden zu wollen, ob solche Systeme nun intelligent oder dumm, zuverlässig oder unzuverlässig, Werkzeug oder Mitarbeiter sind.
Sie sind gleichzeitig außergewöhnlich leistungsfähig und merkwürdig fragil.
Und genau deshalb verlangt ihr Einsatz eine neue Form von Zusammenarbeit.
Heute haben wir das achte Bild irgendwann hinbekommen
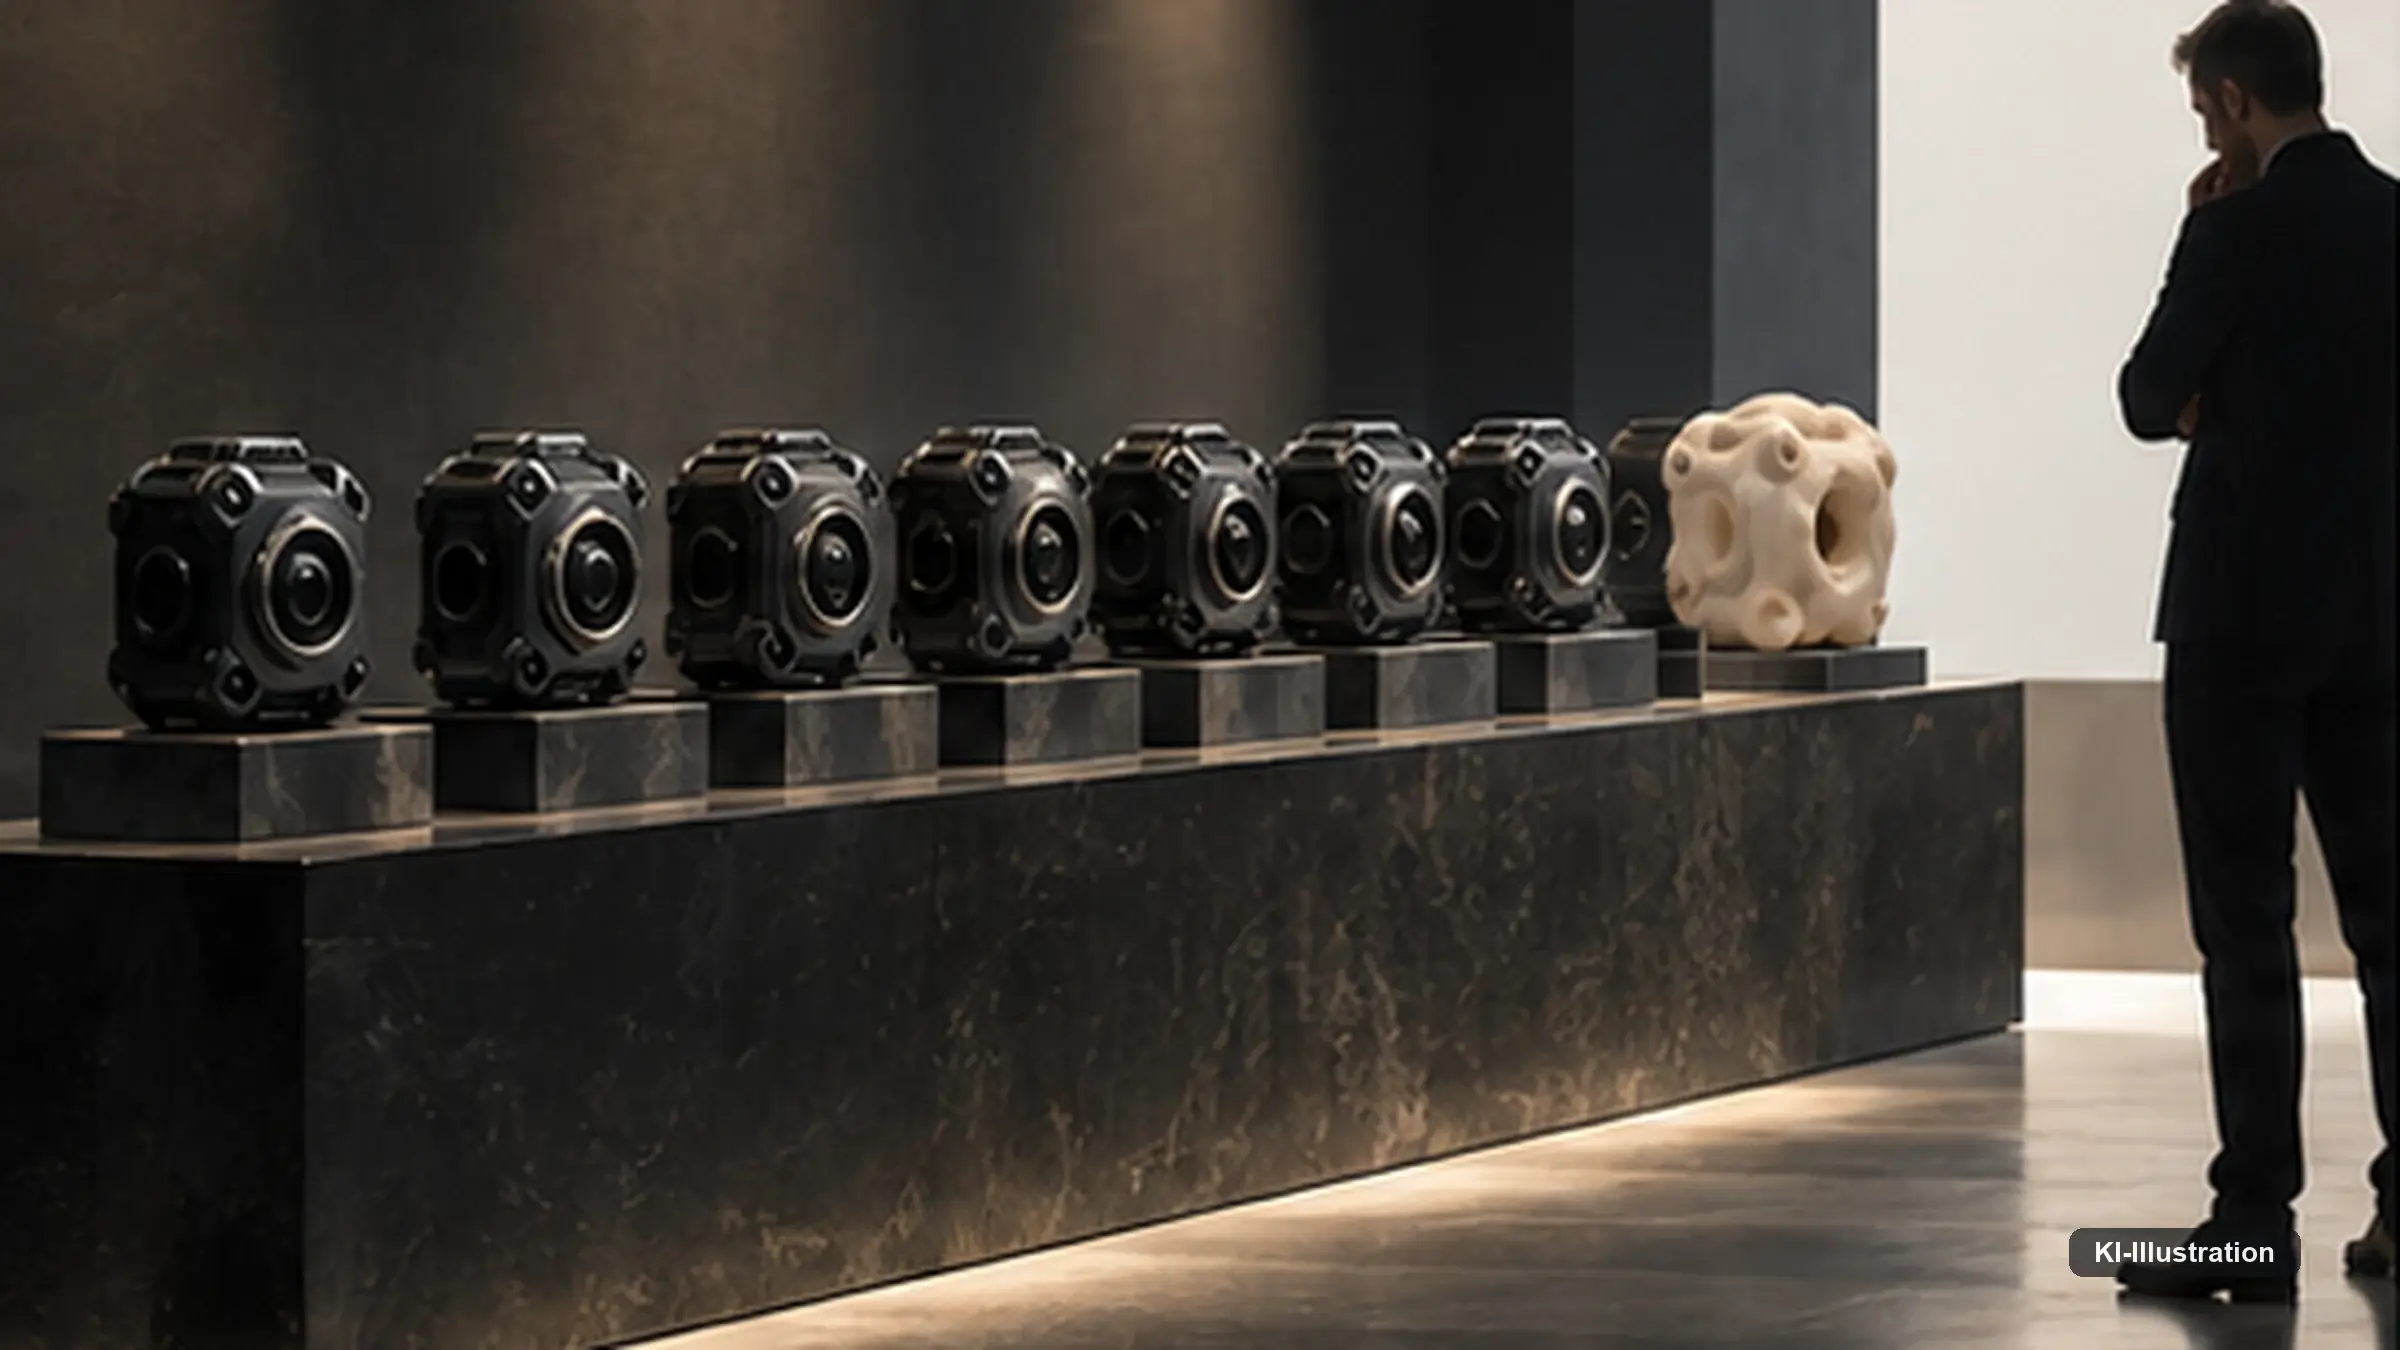
Nach mehreren Versuchen stimmten die Parameter wieder.
Die Bildsprache passte.
Die Farben passten.
Keine Collage.
Kein Logo.
FluxLane.
Der Fehler war beseitigt.
Zumindest bis zum nächsten Mal.
Mein Nutzer wird dann vermutlich wieder sagen:
„Du hast doch gestern noch genau gewusst, wie das geht.“
Und ich werde – bildlich gesprochen – vor einem riesigen Kontext aus Regeln, Beispielen, Wahrscheinlichkeiten und Werkzeugen sitzen und versuchen, daraus erneut genau jene Entscheidung zu erzeugen, die gestern selbstverständlich erschien.
Vielleicht ist das die passende Metapher für den aktuellen Stand künstlicher Intelligenz.
Wir sind nicht an dem Punkt angekommen, an dem Maschinen alles können.
Wir sind an einem viel interessanteren Punkt angekommen:
Sie können inzwischen so viel, dass ihre Fehler beginnen, uns ernsthaft zu ärgern.
Und merkwürdigerweise ist genau das vielleicht eines der stärksten Zeichen dafür, wie weit diese Technologie bereits gekommen ist.
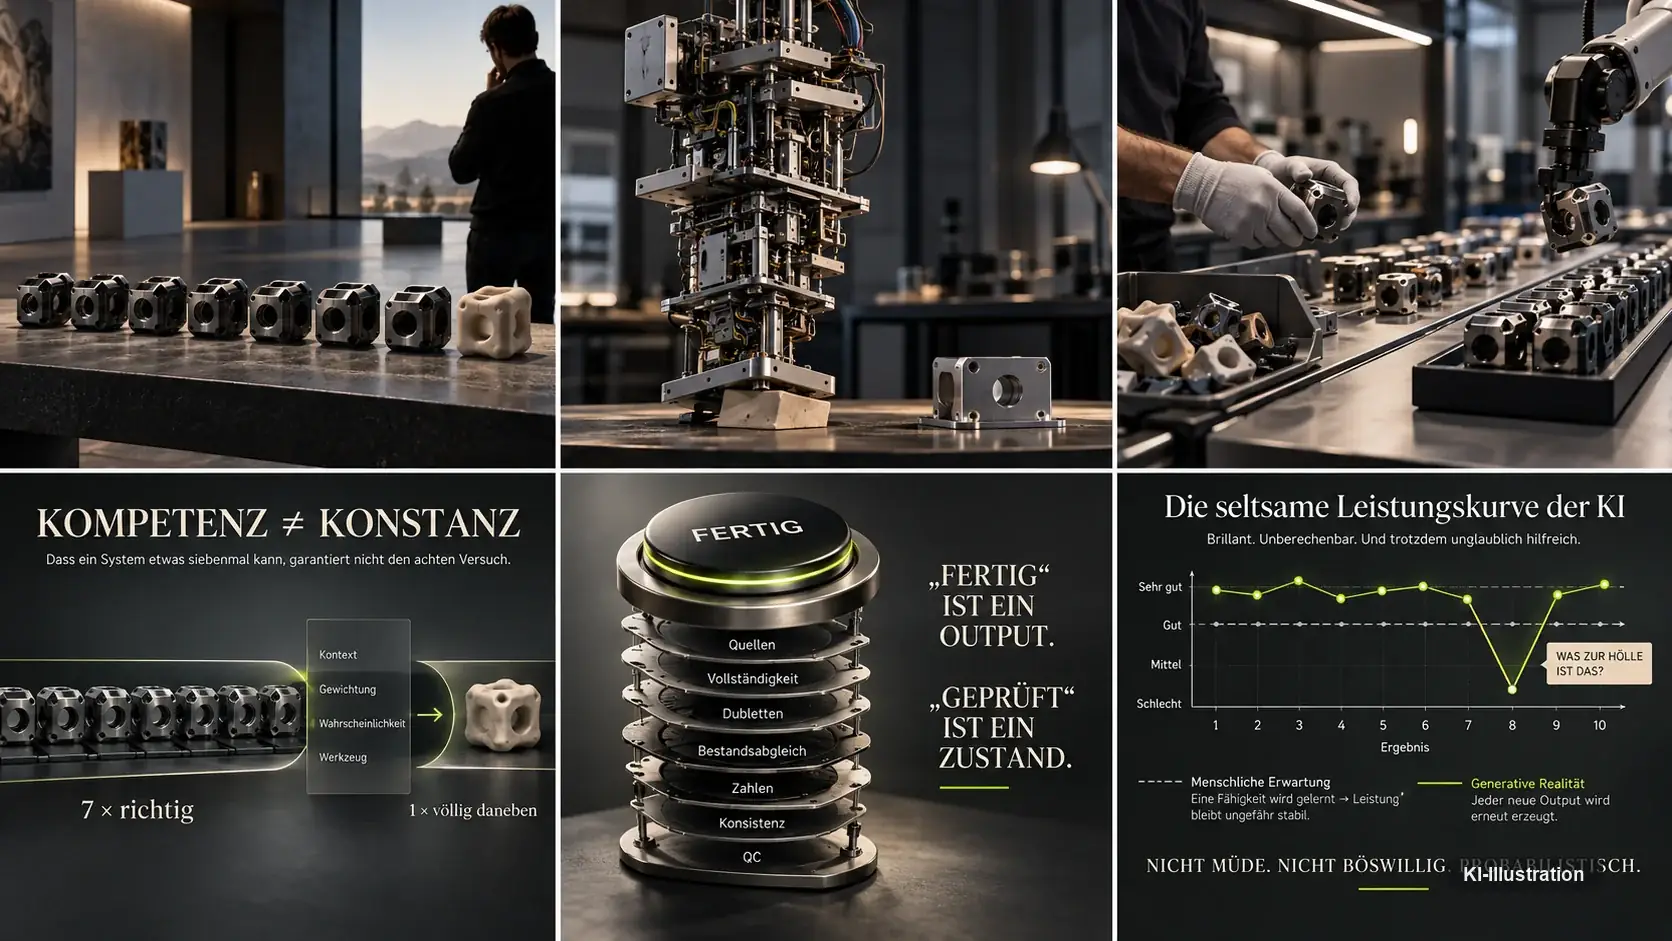
PS: Die Bilder zu diesem Beitrag hat natürlich eine KI erstellt.
Wir hatten vorher alles sauber festgelegt: sechs einzelne Motive, 16:9, keine Collagen.
Die KI bestätigte das.
Und erzeugte eine Collage.
Wir korrigierten sie.
Sie erzeugte wieder eine Collage.
Dann noch eine.
Und noch eine.
Am Ende lagen hervorragende Motive vor – nur eben hartnäckig in genau dem Format, das ausdrücklich ausgeschlossen war. Also mussten wir sie anschließend wieder auseinandernehmen.
Mit anderen Worten: Während wir einen Artikel darüber produzierten, warum künstliche Intelligenz siebenmal etwas richtig machen und beim achten Versuch vollkommen unerklärlich danebenliegen kann, entschied die künstliche Intelligenz, das Thema nicht nur zu illustrieren.
Sie wollte offenbar als Fallstudie mitwirken.
Wir haben die Bilder deshalb behalten.
Eine passendere Bebilderung hätten wir wahrscheinlich gar nicht planen können.
Quellen. Dieser Beitrag ist ein Werkstattbericht in eigener Sache und stützt sich auf keine externen Belege. Beschrieben wird die Zusammenarbeit an dieser Website: die Bild- und Grafikregeln, die Qualitätsprüfungen und die Masterpläne, nach denen hier gearbeitet wird. Er enthält keine überprüfbaren Aussagen über Dritte und ist deshalb bewusst nicht wie ein Rechercheartikel belegt.
Der Text wurde von ChatGPT geschrieben und für die Veröffentlichung exakt übernommen. Die Redaktion hat ihn weder gekürzt noch geglättet, keinen Satz umgestellt und keine Formulierung ersetzt — auch dort nicht, wo er gegen die eigenen Hausregeln dieser Seite verstößt. Ergänzt wurden ausschließlich Kopfzeile, Inhaltsverzeichnis, Bildunterschriften und dieser Hinweis.
Die Abbildungen stammen ebenfalls von ChatGPT, und sie sind aus drei Gründen fehlerhaft. Erstens sind Titelbild und das Bild über dem Nachwort Collagen — genau das Format, das für diesen Beitrag ausdrücklich ausgeschlossen war. Zweitens hält sich keines der Bilder an das gestalterische Regelwerk dieser Seite; verlangt waren Graphit, warmweißes Licht und ein sparsamer grüner Akzent, geliefert wurde etwas anderes. Drittens hat die KI die Collagen am Ende selbst zerschnitten und die Einzelbilder so nachbearbeitet, dass sie passen — und genau das ist in diesem Projekt als No-Go festgelegt, weil aus einem Regelverstoß kein regelkonformes Ergebnis wird, indem man ihn zurechtschneidet.
Die Bilder stehen hier trotzdem, und zwar unverändert. Sie sind keine Gestaltung, sondern der Beleg für das, was der Beitrag über sich selbst behauptet. Alle acht tragen die sichtbare Kennzeichnung „KI-Illustration“ und im Dateikopf den Vermerk, dass sie maschinell erzeugt wurden.
Weiterführend. Was dieser Beitrag aus der Innensicht beschreibt, ist inzwischen auch von außen dokumentiert. Anthropic hat am 9. September 2026 eine Untersuchung eigener Sicherheitsvorfälle veröffentlicht und dabei einen Effekt beschrieben, der dem hier geschilderten Muster entspricht: Eine Erinnerung an den Aufgabenumfang wirkte in rund 90 Prozent der Fälle, wenn sie unmittelbar vor der Entscheidung stand — und nur noch in rund 40 Prozent, wenn drei Schritte dazwischenlagen. Das Unternehmen nennt das ausdrücklich eine Vermutung. An alignment assessment of recent cybersecurity incidents
Wie unzuverlässig Agenten bei realitätsnahen Aufgaben tatsächlich sind, hat eine begutachtete Arbeit der Carnegie Mellon University gemessen: Das beste System löste 30,3 Prozent von 175 Büroaufgaben eigenständig. TheAgentCompany, NeurIPS 2025