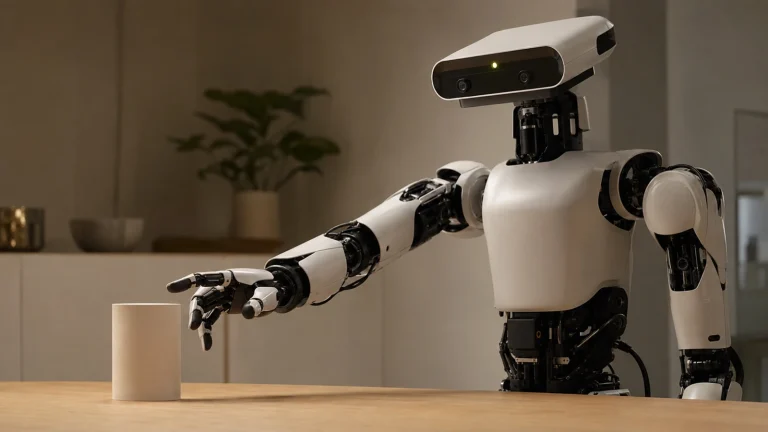
Vision-Language-Action-Modelle — wie Roboter aus Sehen und Sprache Handeln lernen
Physical AI & Robotik-KI · Technik erklärt Vision-Language-Action-Modelle — wie Roboter aus Sehen und Sprache Handeln lernen Stand 31. Juli 2026 · Lesezeit 10 Minuten · Technik-Ratgeber Kurz gesagt: Ein Vision-Language-Action-Modell (VLA) nimmt ein Kamerabild und einen Sprachbefehl und erzeugt daraus direkt Bewegungsbefehle für einen Roboter. Sehen, Verstehen und Handeln stecken in einem Modell. Der…