Physical AI & Robotik-KI · Hersteller-Deep-Dive
Mecka AI: die Datenschicht für Physical AI — belegte Technik, unbelegtes Geschäft
Kurz gesagt: Mecka baut keine Roboter und nennt sich selbst den Integrator zwischen menschlicher Erfahrung und Physical AI — verkauft werden Datenzugang, Auftragserfassung, Modellbewertung und Einsatzunterstützung. Belegt sind ein Konsortialdatensatz namens EgoVerse, eine eigene Erfassungs-App, Finanzierungen über 8 und 60 Millionen US-Dollar sowie eine vom Unternehmen projizierte Jahres-Run-Rate von 100 Millionen US-Dollar auf Basis unterschriebener Verträge. Unbelegt bleibt genau das, worauf eine Beschaffung ankommt: kein benannter Kunde, kein öffentlich messbarer Modellzuwachs, kein deutscher Standort und kein Preis. Wer über Zukauf oder Eigenaufbau entscheidet, prüft deshalb die Kette, nicht die Stundenzahl.
Ein Robotikunternehmen ohne Roboter
Mecka baut keine Roboter. Keine Hände, keine Beine, kein Serienprodukt, das auf einer Messe über eine Bühne läuft. Genau deshalb ist das Unternehmen für den aktuellen Robotikmarkt interessant.
Auf der eigenen Website beschreibt sich Mecka als Daten- und Deployment-Schicht für Physical AI und formuliert ungewöhnlich direkt, man baue keine Roboter, sondern sei der Integrator. Das ist mehr als eine Bescheidenheitsformel. Mecka positioniert sich damit weder als klassischer Datenhändler noch als reiner Sammler egozentrischer Videos, sondern will die Infrastruktur kontrollieren, die aus menschlicher Tätigkeit trainierbare, auswertbare und einsatzfähige Systeme macht.
Diese Geschichte ließe sich leicht als Kategorie-Hype abtun, wäre da nicht die Geschwindigkeit, mit der Kapital, Forschungspartner, Datenmenge und Personal entstanden sind. 2025 wurde ein Seed über 8 Millionen US-Dollar öffentlich, im Juni 2026 folgte die Offenlegung von 60 Millionen, und im September 2026 berichtete TechCrunch über eine weitere, noch nicht abgeschlossene Runde bei einer Bewertung um 500 Millionen US-Dollar. Für ein Unternehmen, das keine Roboter verkauft, sind das außergewöhnliche Signale.
Wenn Sie in einem Robotik- oder Grundlagenmodell-Team über Zukauf oder Eigenaufbau der Datenschicht entscheiden, ist die nüchterne Frage deshalb nicht, wie beeindruckend die Finanzierung aussieht. Sie lautet: Was besitzt Mecka, das Sie nicht selbst aufbauen können — und woran erkennen Sie, ob es funktioniert?
Was belegt ist und was Projektion bleibt
Die Mecka-Akte besteht aus ungewöhnlich gut belegten technischen Signalen und ungewöhnlich schwach belegten kommerziellen. Wer beide Ebenen vermischt, überschätzt das Unternehmen; wer die erste ignoriert, unterschätzt es.
| Baustein | Was öffentlich belegt ist | Belegstatus | Was fehlt |
|---|---|---|---|
| EgoVerse | Publikation vom April 2026 mit 1.362 Stunden, 80.000 Episoden, 1.965 Aufgaben, 240 Szenen und 2.087 Demonstrierenden; Explorer am 17. September 2026 mit über 4.108 Stunden, über 446.000 gefilterten Episoden und über 28.000 Aufgaben | Primärquellen; die Explorer-Werte sind datierte Untergrenzen und wachsen weiter | Aufschlüsselung, welcher Anteil von Mecka selbst erhoben wurde |
| Erfassungswerkzeuge | iOS-App unter Carbon Based Technology Corp., auch im deutschen App Store; Web-Werkzeuge zum Durchsuchen, Visualisieren, Abfragen und für Inferenz | Primärquellen | Preise, Nutzungsbedingungen für Unternehmen, Schnittstellenumfang |
| Finanzierung | 8 Millionen US-Dollar Seed (August 2025, geführt von Neo); 60 Millionen US-Dollar aus einer Series A über 25 und einer Erweiterung über 35 Millionen, offengelegt im Juni 2026, geführt von Framework Ventures | Primär- und Fachpresse | Mittelverwendung, Anteil Hardware und Operations |
| Umsatzangabe | projizierte Jahres-Run-Rate von 100 Millionen US-Dollar auf Basis bereits unterschriebener Verträge, genannt vom CEO gegenüber Fortune | Unternehmensprojektion, kein testierter Umsatz | Vertragsstruktur, Laufzeiten, Kundenzahl, realisierter Umsatz |
| Gemeldete neue Runde | Bericht vom 11. September 2026 über eine von Sequoia geführte Runde bei rund 500 Millionen US-Dollar Bewertung; Konditionen ausdrücklich nicht final | sekundär, nicht abgeschlossen; auf der eigenen Website nicht genannt | Abschluss, Rundengröße, Konditionen |
| Kunden | keine öffentlich benannten Kunden; beide berichtenden Redaktionen halten die Liste für nicht offengelegt | Nullbefund | ein benannter Fall mit messbarem Ergebnis |
| Deutschland | kein deutscher Standort unter den 18 offenen Stellen, keine Preisseite, Unternehmensanfragen nur über Kontaktformular, Abruf 22. September 2026 | Nullbefund auf geschlossenem Suchraum | lokale Ansprechstelle, Servicezusage, europäische Preislogik |
Aus dieser Aufstellung ergibt sich die Leitfrage des Beitrags. Mecka hat technische Substanz, die sich nachlesen lässt, und eine kommerzielle Geschichte, die man derzeit glauben oder abwarten muss.
Firmenname, Gründungsjahr und vier Gründer ohne Robotiklebenslauf
Rechtlich firmiert Mecka als Carbon Based Technology Corporation, geschäftlich tätig als Mecka AI. Das steht in der eigenen Datenschutzrichtlinie und wird durch den App-Store-Eintrag bestätigt. Beim Gründungsjahr wird es unübersichtlich: TechCrunch beschreibt Mecka im September 2026 als 2024 von vier Unternehmern mitgegründet, Fortune formuliert dagegen, die vier Gründer hätten 2025 nach einer längeren Phase eigener Datensammlung entschieden, dass genug Zugkraft für einen Start vorhanden sei.
Beides lässt sich zusammenbringen, ohne ein Datum zu erfinden. Die frühen Arbeiten können 2024 begonnen haben, die formale Markteinführung als heutiges Unternehmen 2025 erfolgt sein. Für eine Akte reicht die belastbare Chronologie: Projektwurzeln ab 2024, ab 2025 als operativ skalierendes Unternehmen sichtbar.
Die vier Gründer sind Josh Gao als CEO, Mogen Cheng, Jason Chong und Duy Nguyen. Gao und Cheng hatten zuvor ein Unternehmen für Restaurantzahlungen aufgebaut und 2023 verkauft, Chong ein eigenes Startup an Coinbase, Nguyen wird als operationsorientierter Mitgründer beschrieben. TechCrunch hebt ausdrücklich hervor, dass keiner der vier einen klassischen Robotikhintergrund hat.
Das kann man als Schwäche lesen, denn auf der anderen Seite des Tisches sitzt kein Marketingteam, sondern Robotikforschung und Autonomieentwicklung. Man kann es aber auch als Erklärung der Strategie lesen: Mecka denkt Robotik nicht vom Aktuator aus, sondern wie ein Daten- und Operationsunternehmen. Fachbiografie und Unternehmensaufbau sind zwei verschiedene Fähigkeiten, und Robotikkompetenz lässt sich einstellen — die Forschungsnähe über EgoVerse liefert dafür die Glaubwürdigkeit, die eine Gründerbiografie hier nicht liefern könnte.
Der Mensch als Datengenerator statt des Roboters
Klassische Daten für Roboterlernen entstehen am Roboter. Ein Mensch teleoperiert, das System sieht seine eigenen Kameras, kennt seine Gelenkzustände, und die Demonstration liegt direkt im Aktionsraum der Maschine. Qualitativ ist das attraktiv, weil nichts übersetzt werden muss. Nur skaliert es schlecht: Ein Roboter kostet Geld, ein Teleoperator braucht Vorbereitung, ein Labor hat begrenzte Hardware.
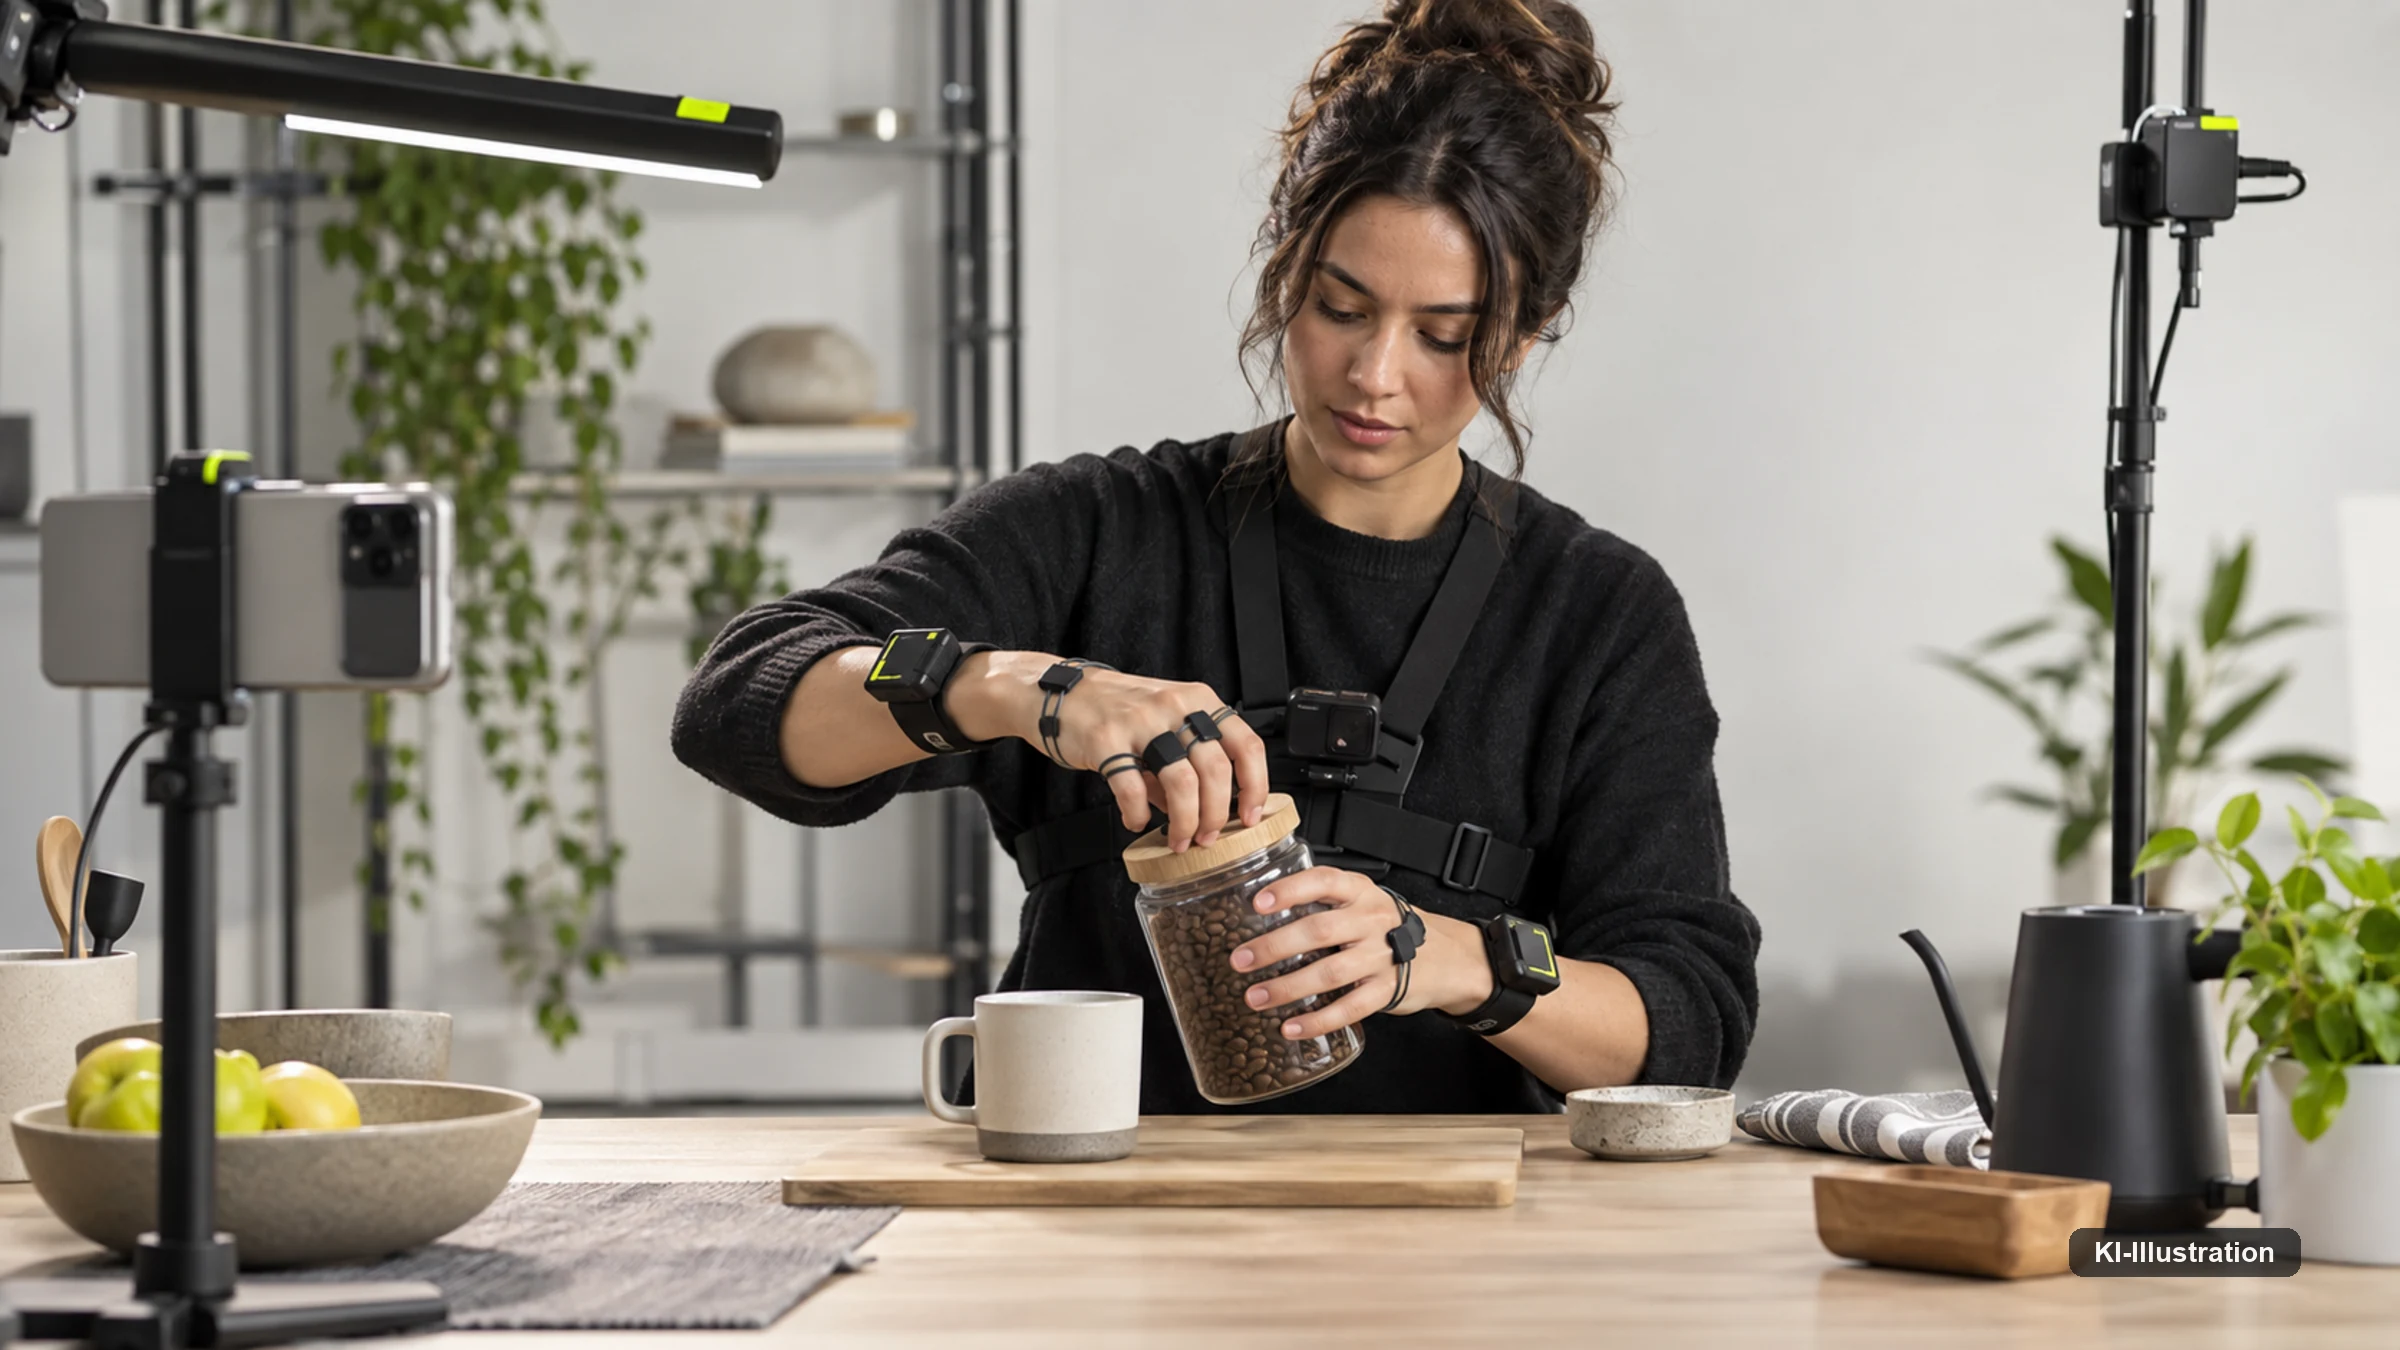
Mecka setzte früh auf den Gegengedanken. Menschen erledigen täglich Milliarden reale Manipulationsaufgaben — Kaffee kochen, Werkzeuge benutzen, Kisten öffnen, Geräte bedienen, Autos reparieren. Gao und seine Mitgründer begannen deshalb, menschliche Tätigkeit mit Bewegungssensorik und Smartphones aufzuzeichnen.
Das klingt einfacher, als es ist, denn Menschen und Roboter teilen keine Kinematik. Andere Gelenke, andere Kraftverteilung, andere Finger, andere Kameraposition, andere Reichweite: Eine menschliche Demonstration ist keine Robotertrajektorie. Der Kern der Wette liegt deshalb nicht im Sammeln, sondern in der Darstellung — menschliche Daten müssen so repräsentiert und verarbeitet werden, dass ein Robotermodell trotzdem davon profitiert.
Genau diese Debatte wird häufig zu binär geführt, als stünde menschliche Aufzeichnung gegen Teleoperation. In der Praxis braucht ein starkes System beides. Menschliche Daten liefern Verhaltensbreite, natürliche Objektinteraktion, günstige geografische Skalierung und lange zusammenhängende Handlungsfolgen. Teleoperation liefert roboterspezifische Aktionen, echte Einschränkungen des Körpers, Kontakt im Zielsystem und die Fehlerbilder der realen Maschine. Einsatzdaten liefern anschließend die Fehler, die niemand vorhergesehen hat. Ob Meckas Schicht alle drei Welten verbinden kann, ist die eigentliche Prüffrage.
EgoVerse ist mehr als ein Mecka-Datensatz
EgoVerse ist der wichtigste öffentliche Beleg dafür, dass diese Idee mehr ist als ein Pitchdeck — und zugleich die Stelle, an der am häufigsten falsch zitiert wird. Die Publikation vom April 2026 beschreibt 1.362 Stunden, 80.000 Episoden, 1.965 Aufgaben, 240 Szenen und 2.087 unterschiedliche Demonstrierende, getragen von mehreren akademischen Laboren und Industriepartnern. In den Projektunterlagen werden auf akademischer Seite unter anderem Georgia Tech, Stanford, UC San Diego und die ETH Zürich genannt; Industrieunterstützung kam unter anderem von Meta Reality Labs Research, Mecka AI und Scale AI.
Mecka ist damit ein bedeutender Partner eines Konsortialdatensatzes, und das Unternehmen bezeichnet EgoVerse im eigenen FAQ als seinen großen Datensatz menschlicher Interaktion. Beide Aussagen stehen nebeneinander, und nur eine davon wäre irreführend: EgoVerse ist nicht Meckas Alleineigentum.
Warum investiert ein kommerzielles Unternehmen dann in ein offenes Forschungsökosystem? Weil Standards und Verbreitung wertvoll sind. Wenn viele Labore ähnliche Datenstrukturen, Pipelines und Übersetzungsmethoden von Mensch zu Roboter verwenden, wächst das Ökosystem — und Mecka erhält Forschungserfahrung, Werkzeuge, ein Reputationssignal, Datennähe, Rückmeldungen und Zugang zu Teams, die später Kunden werden können. Offene Daten dienen hier als Vertriebsweg, nicht nur als Forschungsausgabe.
Wichtig ist der zweite Zahlenstand. Der laufende Explorer zeigte am 17. September 2026 mehr als 4.108 Stunden, mehr als 446.000 gefilterte Episoden und mehr als 28.000 repräsentierte Aufgaben. Das ist kein Widerspruch zur Publikation, sondern ein wachsendes System. Wer heute noch 80.000 Episoden nennt, ist veraltet — und wer 446.000 ohne Datum nennt, wird denselben Fehler in einigen Monaten wiederholen.
Ein großer Robotikdatensatz ist ein Softwareprodukt
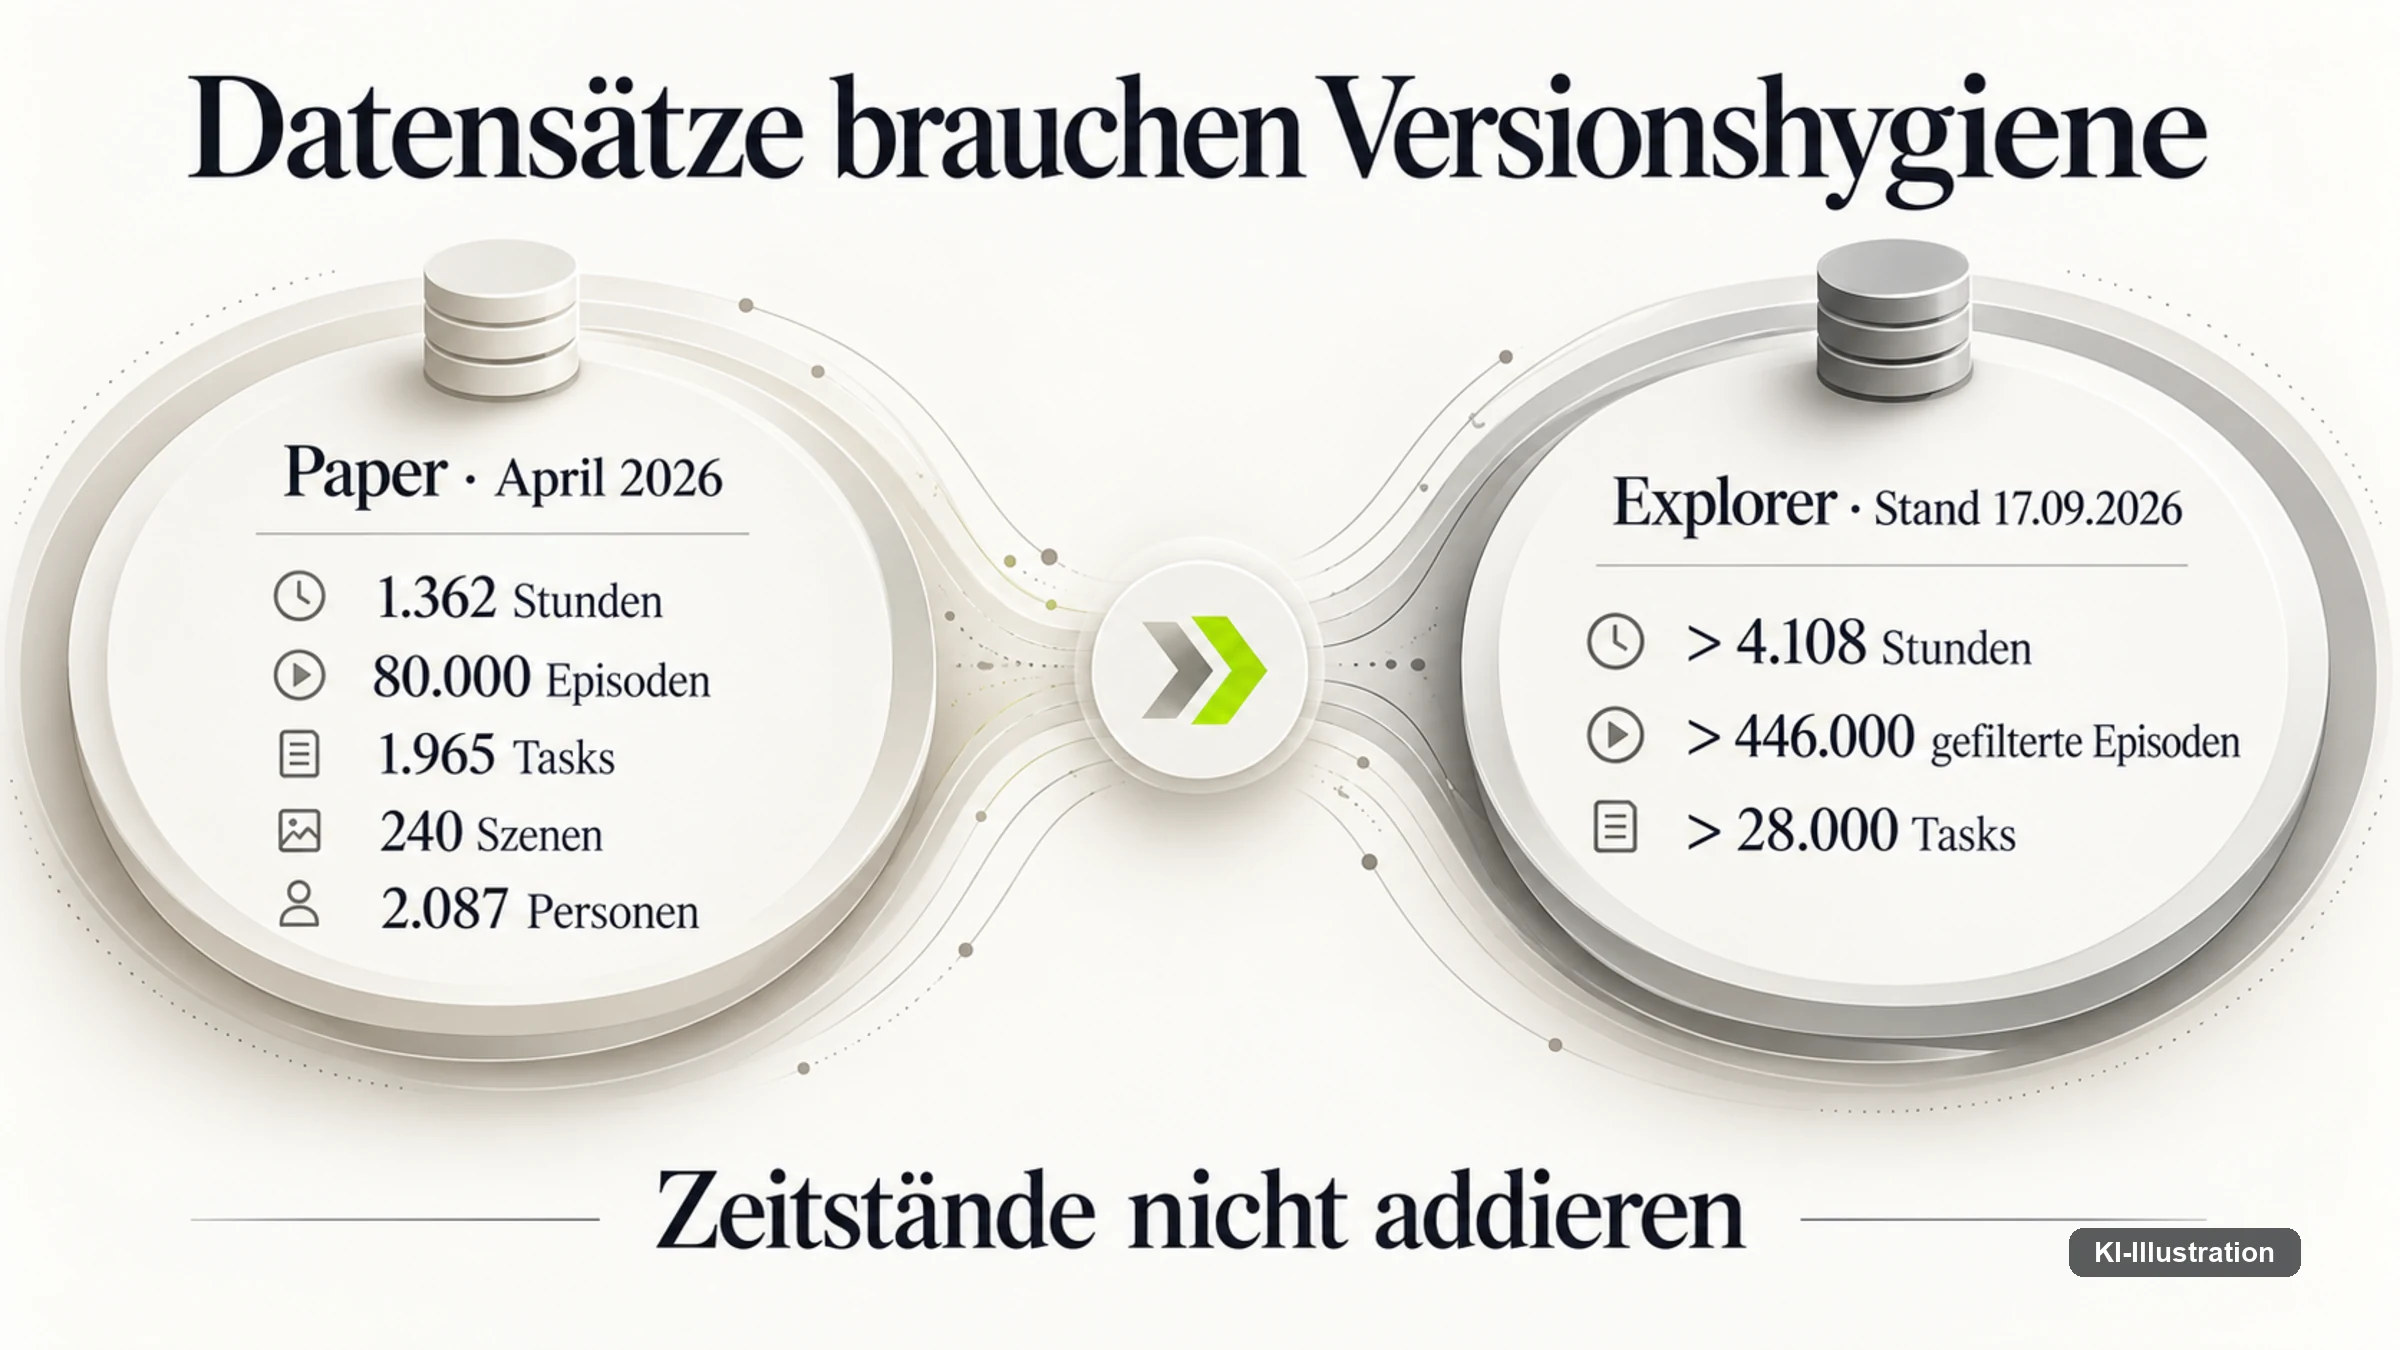
Noch aussagekräftiger als die Größe ist die Änderungshistorie. Das öffentliche Repositorium zeigt im Laufe des Jahres mehrere tiefgreifende Eingriffe: Kameraintrinsiken wurden verpflichtend, Bezeichnungen der Roboterkörper vereinheitlicht, Orientierungen korrigiert, alte Daten mussten neu heruntergeladen werden, und Mecka-Daten wurden neu verarbeitet, wobei minderwertige Episoden entfernt und durch bessere ersetzt wurden.
Das ist kein peinlicher Makel, sondern der ehrlichste Teil der Geschichte. Ein großer Robotikdatensatz braucht Versionierung, Migration, Neuverarbeitung, Qualitätssicherung, Schemapflege und Rückwärtskompatibilität — also alles, was man von einem Softwareprodukt erwartet und von einer Videosammlung nicht.
Genau dort kann ein Vorsprung entstehen. Wer nur Menschen mit Smartphones bezahlt, hat kaum einen Vorsprung, denn das können viele. Wer Aufnahmen organisiert, Sensoren synchronisiert, Qualität automatisch erkennt, Bewegung rekonstruiert, Datensätze durchsuchbar macht, unterschiedliche Roboterkörper normalisiert und Inferenz sowie Bewertung anschließt, baut Infrastruktur. Und Infrastruktur lässt sich schwerer kopieren als Stunden.
App, Kameras, taktile Handschuhe: Instrumentierung der menschlichen Welt
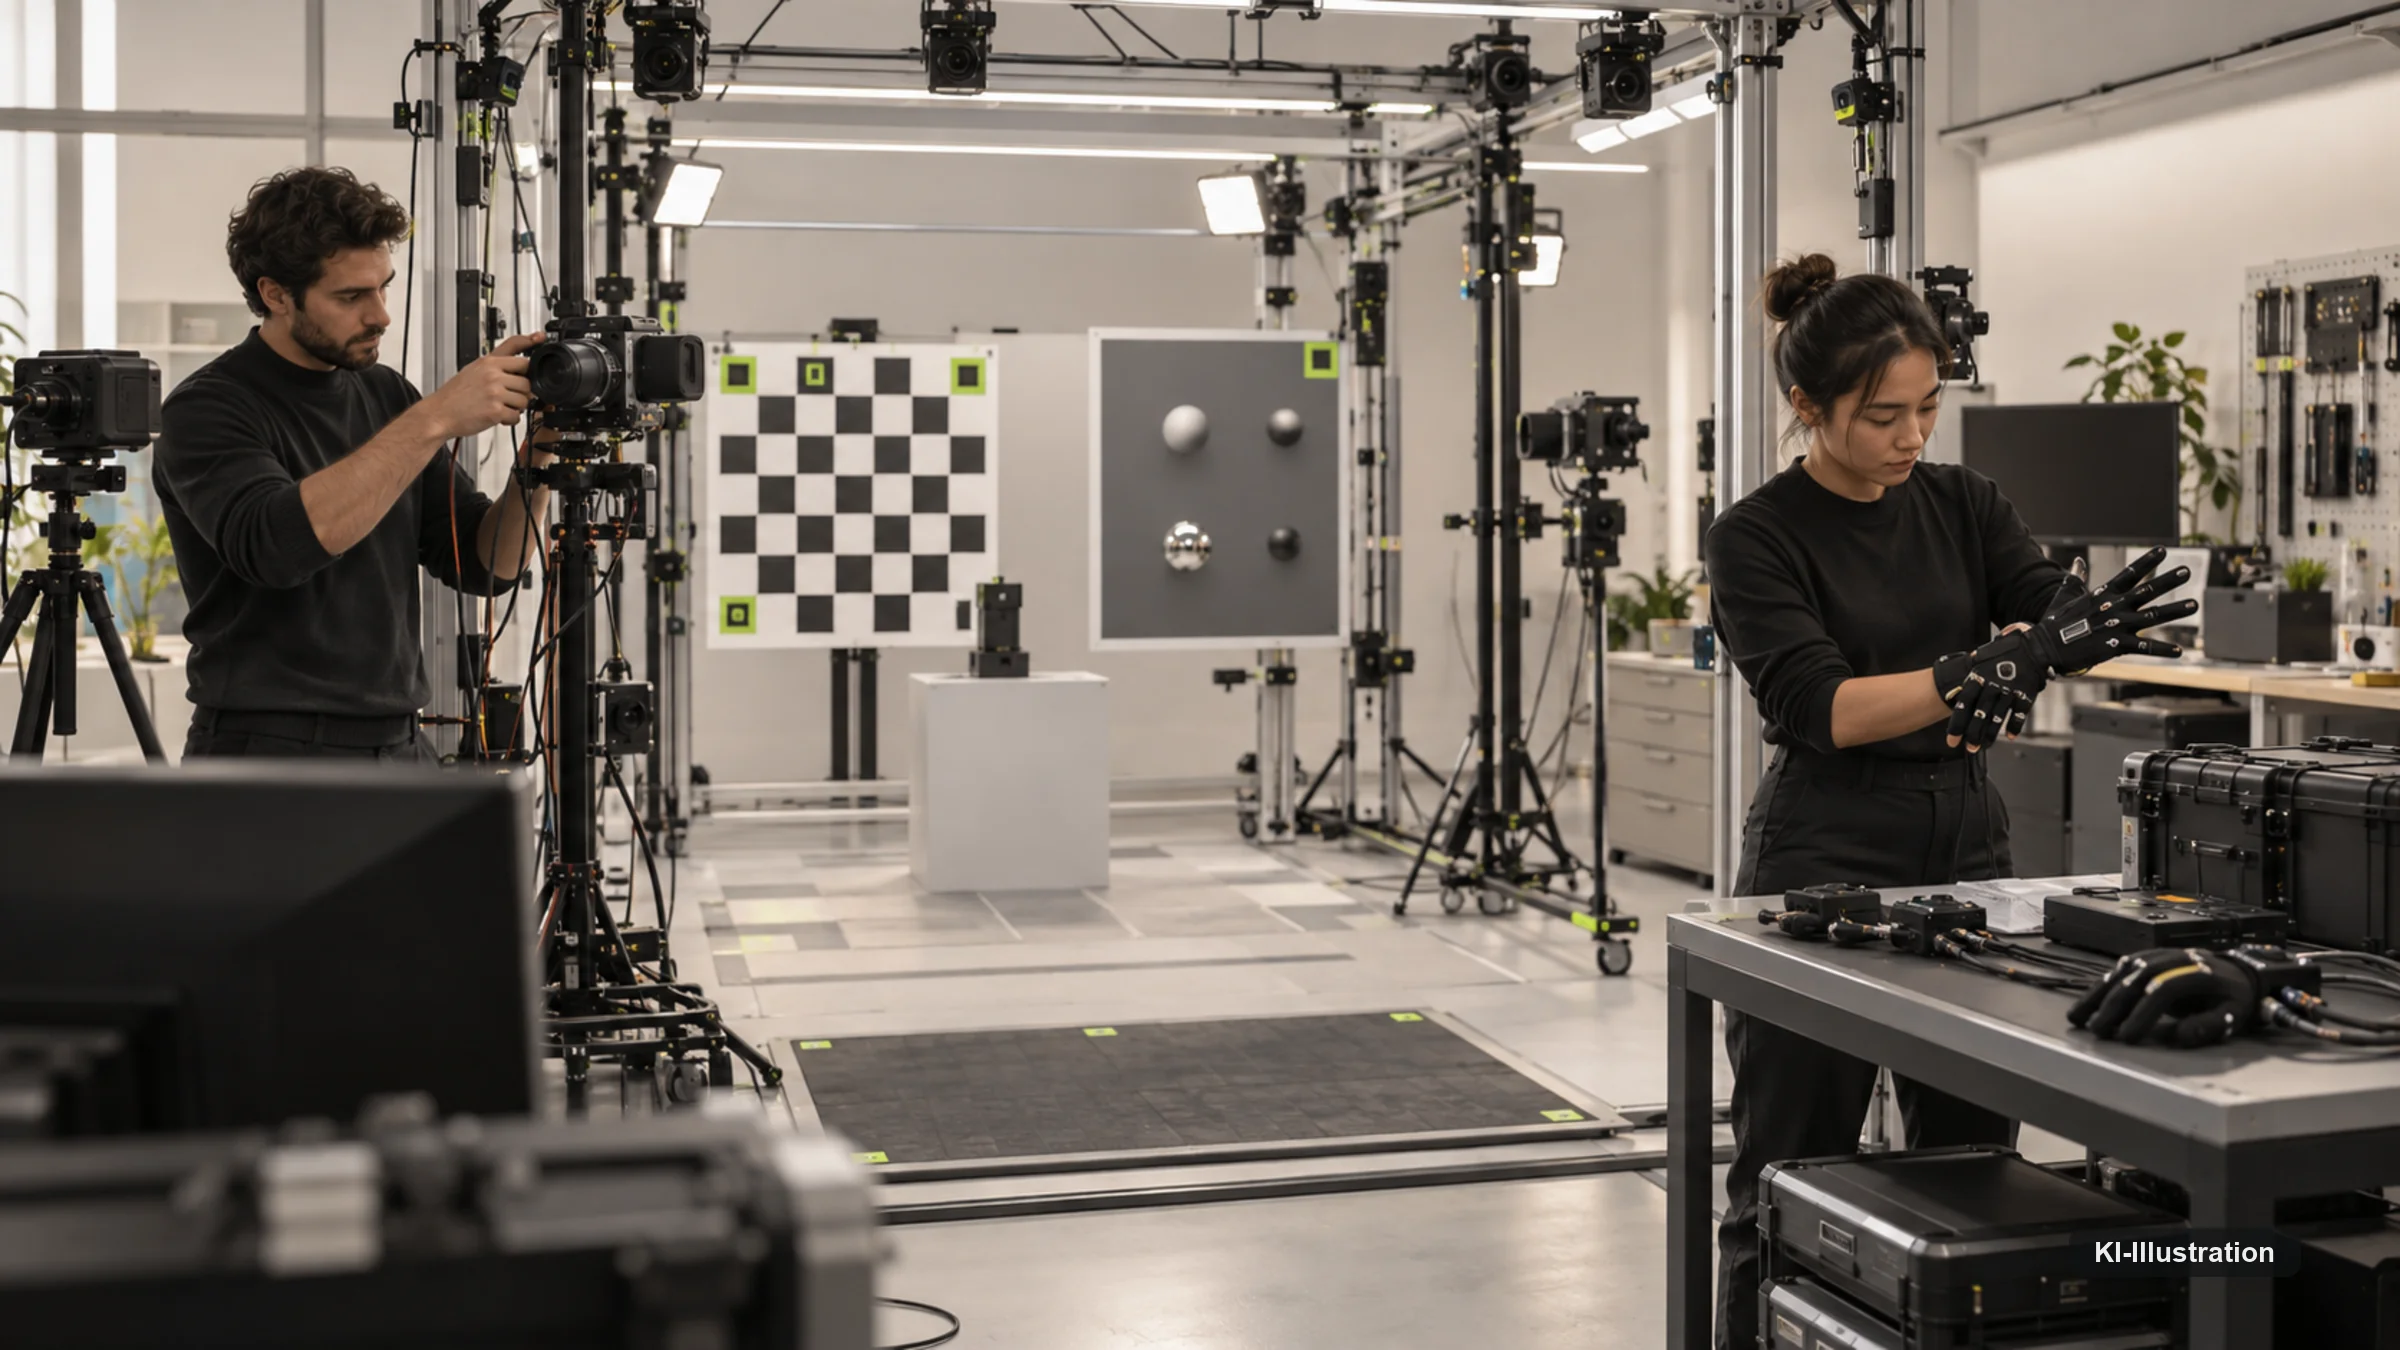
Die iOS-App ist deshalb wichtiger, als sie aussieht. Sie wird von Carbon Based Technology Corp. veröffentlicht, ist auch im deutschen App Store verfügbar und bewusst schlicht gehalten: automatischer Start, wenn Hände ins Bild kommen, Aufgabenverwaltung, schnelle Uploads, wenig Bedienschritte. Die Beschreibung richtet sich ausdrücklich an interne Robotikforschung und Labore, nicht an Endkunden.
Strategisch steckt darin eine Kostenrechnung. Ein teures Aufnahmegestell maximiert Datenqualität, ein Smartphone maximiert Verbreitung. Meckas ursprüngliche These trägt nur, wenn der gesamte Erfassungsprozess günstig bleibt — automatische Aufnahme, automatischer Upload, automatische Qualitätsprüfung, standardisierte Aufgabenbriefings, wenig Betreuung. Je mehr Spezialhardware nötig wird, desto stärker nähert sich menschliche Aufzeichnung wieder einem instrumentierten Laborprozess. Die App ist damit kein Bequemlichkeitswerkzeug, sondern ein Mechanismus zur Kostensenkung der Datenerzeugung.
Der Erfassungsstapel endet allerdings nicht beim Smartphone. Fortune beschreibt zusätzlich kundenspezifische Hardware und Körpersensorik, und Stellenprofile deuten auf eigene Programme für Kameras, Sensoren und taktile Handschuhe hin: In Shenzhen suchte Mecka unter anderem Rollen für Hardware-Deployment und eine Programmleitung für taktile Handschuhe, mitsamt Lieferantensteuerung, Prototypen- und Serienreifephasen, Produktionsqualität und Kalibrierung. Mecka baut also durchaus Hardware — nur nicht als Endprodukt für die Fabrik, sondern als Instrumentierung der menschlichen Welt.
Sobald feinere Kontaktkräfte oder präzise Handdaten erfasst werden sollen, kippt die Rechnung teilweise zurück: mehr Hardwarekosten, Kalibrierung, Versand, Reparatur, Sensordrift, Nutzerschulung, Rücklogistik. Die sinnvolle Erfassungsarchitektur wird deshalb aufgabenabhängig sein — Smartphone für grobe Alltagsbewegung, Wearables für Feinmanipulation, Teleoperation für den direkten Aktionsraum. Dass Shenzhen als Standort für diese Hardware auftaucht, ist naheliegend; eine Einstellungsanzeige ist allerdings keine rechtliche Niederlassung, und als solche sollte man sie auch nicht führen.
Vier Wege der Zusammenarbeit — und vier Unternehmenstypen
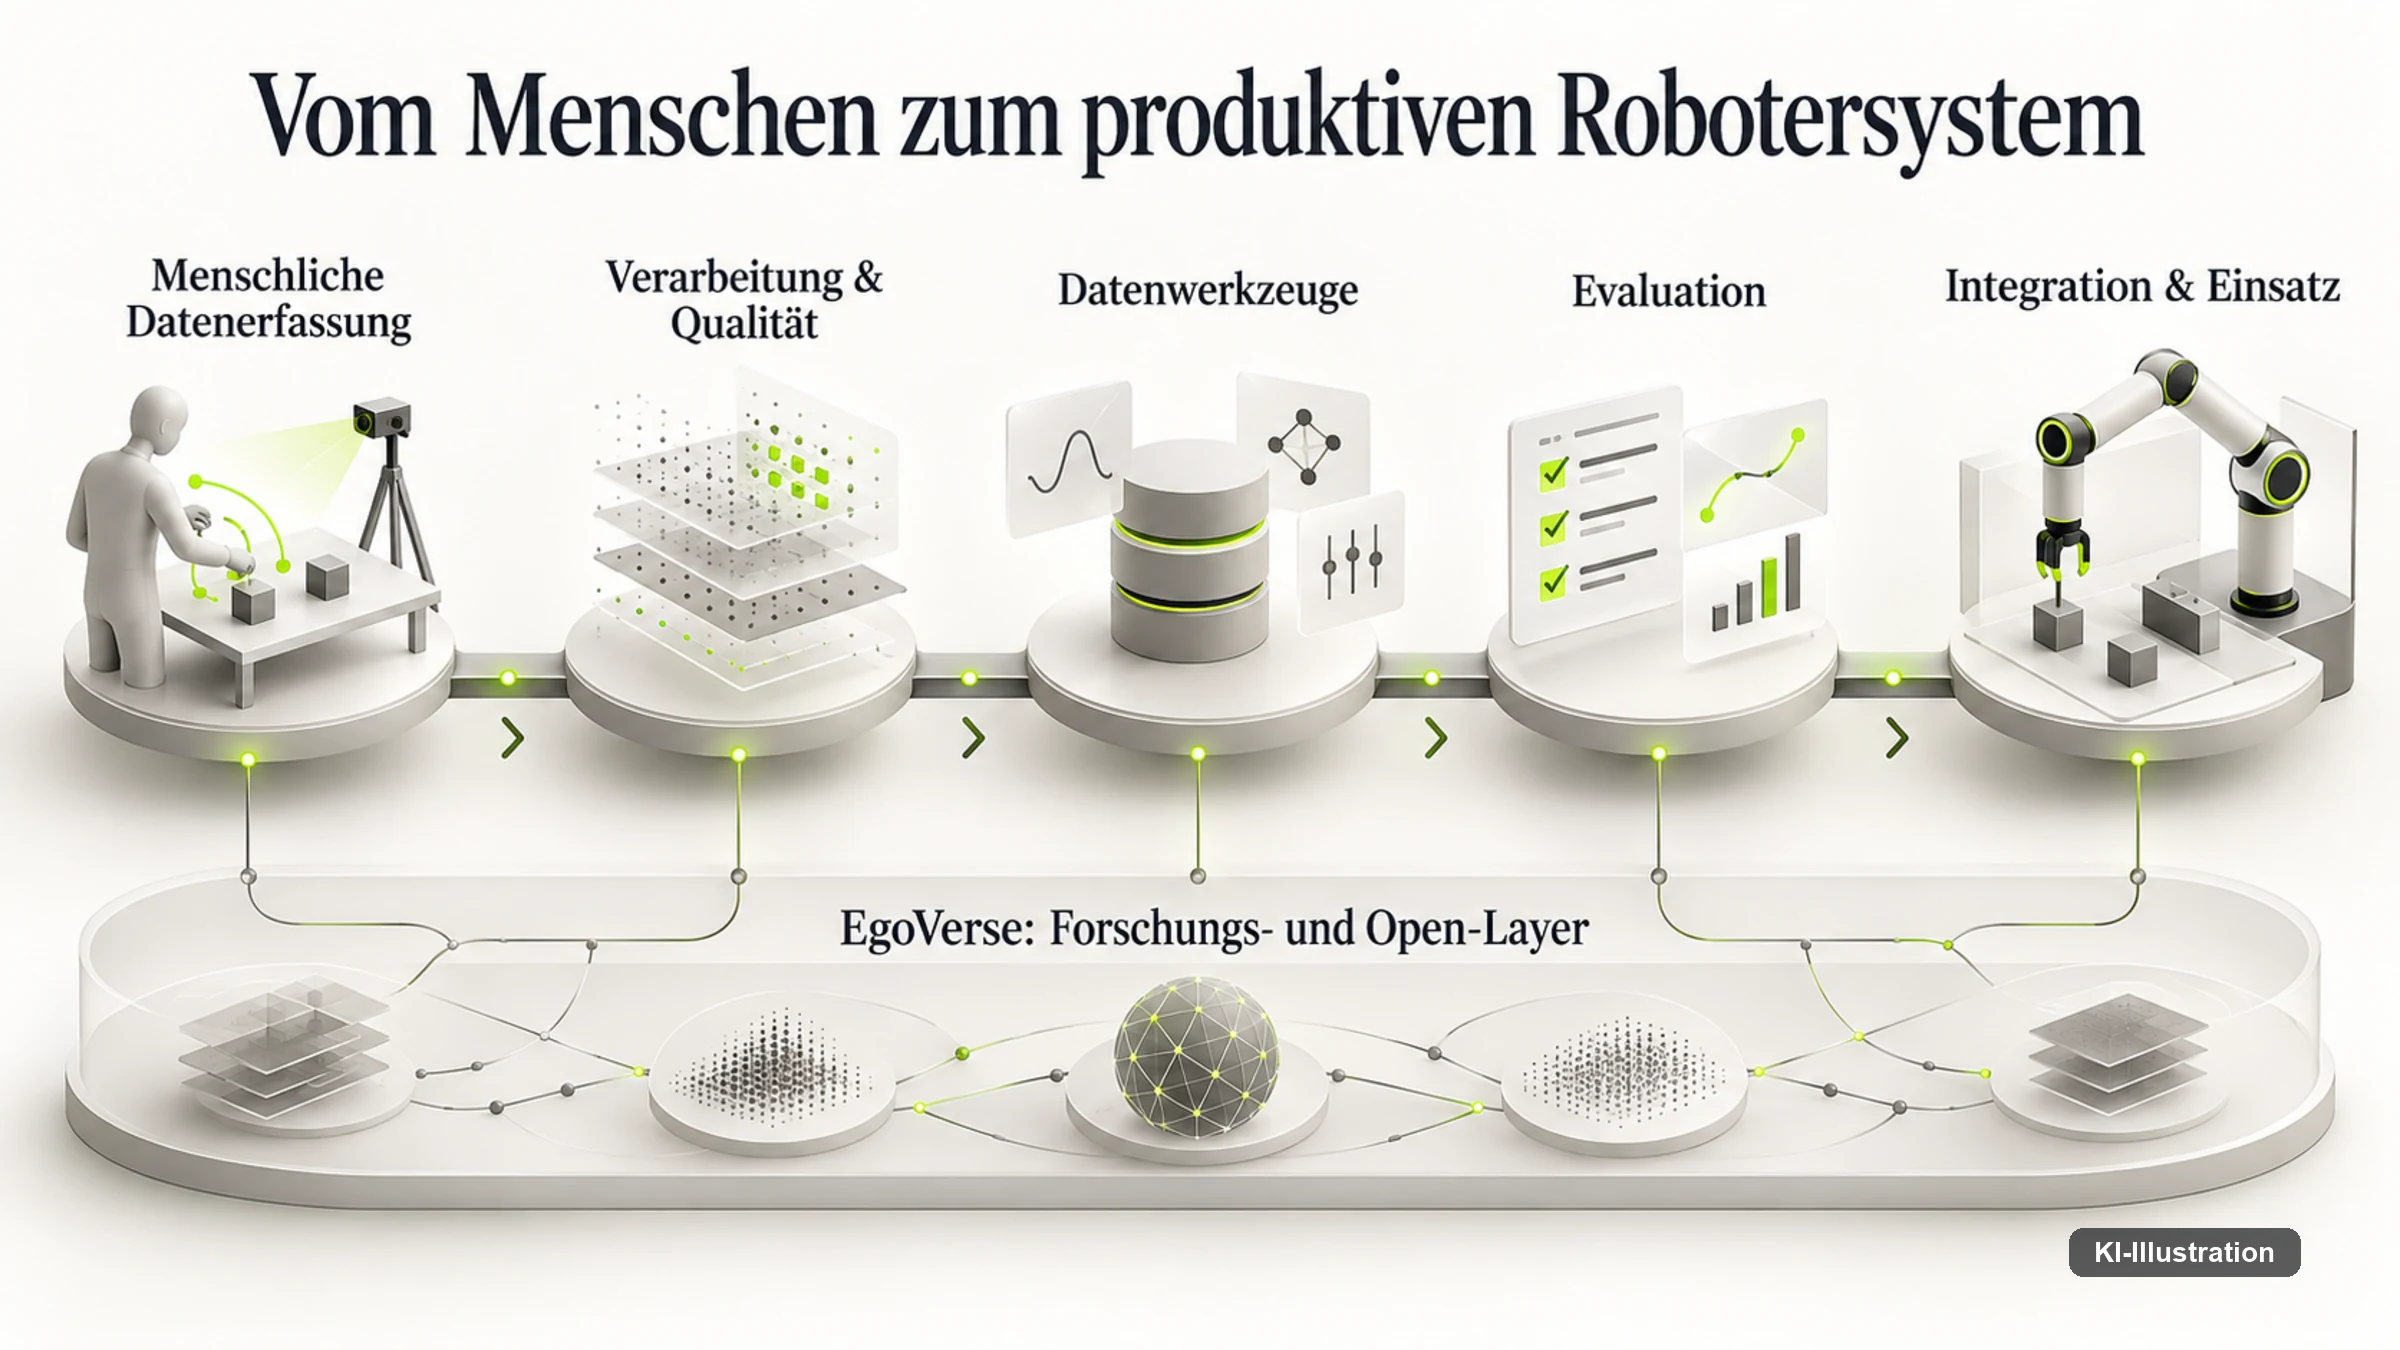
Die Website beschreibt vier Wege, mit Mecka zu arbeiten: Zugang zu bestehenden Datensätzen, aufgabenspezifische Erfassung, Modellbewertung und vollständige Datenprogramme bis zum Einsatz beim Kunden. Dazu kommen Web-Werkzeuge zum Durchsuchen, Visualisieren, Abfragen, für gemeinsame Arbeit und zum Ausführen von Inferenz.
Damit setzt sich Mecka an mehreren Stellen der Wertschöpfungskette fest. Das Angebot lautet nicht „hier sind Daten“, sondern: Wir helfen zu bestimmen, welche Daten fehlen, erzeugen sie, bewerten das Ergebnis und bringen es in einen realen Arbeitsablauf. Ein wörtliches Zitat dieser Art führt Mecka nicht; im eigenen FAQ heißt es, man baue die Daten-, Bewertungs- und Einsatzinfrastruktur, mit der Roboter und verkörperte KI aus realer menschlicher Tätigkeit lernen.
Diese Breite ist strategisch attraktiv und organisatorisch riskant, weil dahinter vier verschiedene Unternehmenstypen stecken. Datenerfassung ist ein Operationsgeschäft. Datenwerkzeuge sind Software. Bewertung ist Forschungs- und ML-Infrastruktur. Einsatz ist Systemintegration. Gelingt die Kombination, entsteht ein schwer kopierbarer Vorsprung; gelingt sie nicht, entsteht organisatorische Überbreite.
Das passt zur eigenen Problembeschreibung, die Mecka auf drei Fehlerbilder zuspitzt: Reale Aufgaben sind verrauscht, rohes Video reicht nicht, und das Labor ist nicht die Ziellinie. Daraus folgt das ganze Geschäftsmodell — Daten müssen die unordentliche Wirklichkeit enthalten, sie brauchen Kontext, Annotation, Qualitätsprüfung und Bewegungsverständnis, und das Modell muss im echten Arbeitsablauf bewertet und integriert werden. Ergänzend beschreibt die Website zehn Signal- und Handlungsbausteine von Pixelverständnis über Tiefe und Geometrie, Objektverfolgung, Segmentierung, taktile Kraft, Schall, Geschwindigkeit, Punktwolken und Oberflächenkontur bis zur Lokalisierung. Zehn einzeln kaufbare Produkte sind das nicht — öffentliche Preise und klare Produktzuschnitte fehlen. Sie zeigen aber die Denkweise: physische Erfahrung als multimodales Signalproblem, bei dem Video allein nicht genügt.
Verarbeitung ist die eigentliche Engstelle
Im Juni 2026 wurde öffentlich, dass Mecka das Unternehmen Docula übernommen hat. Das ursprünglich aus einer anderen Datenverarbeitungsdomäne kommende Team bestand aus drei Personen und wechselte nach Gründer- und Unternehmensangaben vollständig zu Mecka; der Kaufpreis ist nicht öffentlich.
Strategisch passt das besser, als der Herkunftsbereich vermuten lässt. Doculas Stärke lag in großvolumiger Verarbeitung, Normalisierung und datenintensiven Arbeitsabläufen — und genau daran entscheidet sich, ob Erfassung überhaupt skaliert. Hundert Menschen mit Smartphones erzeugen viel Video. Hunderttausend erzeugen ein Infrastrukturproblem aus Speicher, Upload, Kompression, Metadaten, Dublettenerkennung, Datenschutz, Qualitätssicherung, Neuverarbeitung, Versionierung, Herkunftsnachweis, Suche und Trainingspipeline.
Daraus folgt eine Lesart, die für die Bewertung wichtiger ist als die Größe des Zukaufs: Mecka behandelt Verarbeitung als strategische Engstelle, nicht als Unterstützungsfunktion. Und darin liegt auch der Weg zur Marge. Je besser Aufnahme, Normalisierung, Suche, Qualitätsprüfung, Annotation und Bewertung automatisiert sind, desto mehr Erfassung lässt sich mit derselben Belegschaft verarbeiten. Ein besonders interessanter Vorsprung wäre erreicht, wenn Mecka eigene Modelle nicht vor allem zur Robotersteuerung trainiert, sondern zur Bewertung von Datensätzen: Ist die Hand sichtbar, wurde die Aufgabe korrekt ausgeführt, in welcher Phase befindet sich die Episode, ist die Bewegung plausibel, ist das Objekt erkannt? Sinkt dadurch der Preis je akzeptierter Episode, ist das wirtschaftlich bedeutender als die Erfassung selbst.
Finanzierung, Run Rate und eine gemeldete Runde
Die Finanzierungsgeschichte ist bemerkenswert schnell. Im August 2025 kam ein Seed über 8 Millionen US-Dollar, geführt von Neo. Im Juni 2026 wurde öffentlich, dass Mecka insgesamt 60 Millionen US-Dollar über eine Series A über 25 Millionen und eine Erweiterung über 35 Millionen aufgenommen hatte; Framework Ventures führte, genannt wurden außerdem Menlo Ventures, SV Angel, Kindred Ventures und Ted Xiao. Fortune nennt für diesen Zeitpunkt rund 40 Mitarbeitende — bereits ungewöhnlich viel Kapital pro Kopf.
Noch aggressiver ist die Umsatzangabe, und hier lohnt jedes einzelne Wort. Josh Gao sagte Fortune, Mecka projiziere eine Jahres-Run-Rate von 100 Millionen US-Dollar auf Basis bereits unterschriebener Verträge. Das ist eine Projektion des Unternehmens, keine verbuchte Jahresleistung, kein testierter Abschluss und kein eingegangener Zahlungsstrom. Ein Rahmenvertrag kann Mindestabnahmen, Optionsvolumen, Meilensteine, nutzungsabhängige Anteile und Leistungsschwellen enthalten, und die Erlösrealisierung kann sich über Monate oder Jahre verteilen. Die Formulierung ist sauberer als ein vager Hinweis auf eine Vertriebspipeline, doch ohne Vertragsstruktur bleibt die wirtschaftliche Deutung begrenzt.
Am 11. September 2026 berichtete TechCrunch, Mecka stehe vor einer von Sequoia geführten Runde bei einer Bewertung um 500 Millionen US-Dollar. Die Konditionen sind dem Bericht zufolge nicht final und könnten sich ändern, beide Seiten kommentierten nicht, und auf der eigenen Website taucht Sequoia am 22. September 2026 nicht auf. Wir behandeln das deshalb als gemeldete, nicht abgeschlossene Runde — sie zeigt, wie aggressiv der Markt diese Kategorie bewertet, und nicht, dass Mecka hoch margig arbeitet.
Analytisch interessant ist eher der Zeitabstand. Wenn wenige Monate nach der Offenlegung von 60 Millionen bereits über eine neue Runde gesprochen wird, kann das schnellen Kapitalbedarf, starke Nachfrage, einen aggressiven Ausbau, Wettbewerb um die Marktposition oder hohe Hardware- und Operationsinvestitionen bedeuten. Was davon überwiegt, ist von außen nicht entscheidbar.
Die anonymen Kunden sind die größte Lücke der Akte
Fortune fragte nach Kunden, Gao nannte sie nicht. TechCrunch schreibt ebenfalls, die Kundenliste sei nicht offengelegt. Bei Datenverträgen mit Grundlagenmodell-Teams ist das nicht ungewöhnlich, denn dahinter stehen Vertraulichkeitsvereinbarungen und unveröffentlichte Robotikprogramme.
Für eine externe Bewertung bleibt es trotzdem die härteste Grenze. Welche Verträge gehören zu welchen Kunden, welcher Anteil ist Erfassung, welcher Bewertung, welcher Einsatzunterstützung, welche Laufzeiten gelten, welche Margen, welche Programme sind bereits angelaufen? Ohne diese Verteilung bleibt auch das Risiko unbestimmt. Hundert Kunden mit je einer Million wären etwas anderes als zwei sehr große Verträge; ein junges Datenunternehmen kann extrem schnell wachsen, wenn ein einzelnes Labor ein großes Erfassungsprogramm vergibt, und ebenso schnell einbrechen, wenn es wegfällt.
Was diese Lücke schließen würde, ist kein weiteres Finanzierungssignal, sondern ein benannter Fall von Anfang bis Ende: Kunde, Roboter, Aufgabe, Ausgangserfolgsquote, erfasste Episoden, davon vom Käufer akzeptiert, Training, neue Erfolgsquote, Pilotbetrieb, Rückgang der Eingriffe je hundert Aufgaben, Zunahme produktiver Roboterstunden. So würde Datenwert nachprüfbar. Aktuell fehlt ein öffentliches Beispiel dieser Transparenz — und der Maßstab dafür ist nicht neu: Aufgezeichnete Stunden sind keine Werteinheit, entscheidend sind der rechtlich geklärte Anteil, die technische Abnahme, der Aufgabenbezug, die Qualitätsprüfung und der gemessene Modellzuwachs.
Drei Wettbewerbsklassen, drei ganz verschiedene Bedrohungen
Mecka konkurriert nicht mit einer Firma, sondern mit drei Strategien — und jede greift an einer anderen Stelle an. TechCrunch nennt unter anderem XDOF als weiteren stark finanzierten Anbieter und verweist auf größere Plattformen für menschliche Daten wie Scale AI. Daneben existieren Anbieter mit ganz anderen Marktmodellen, von Simulation über Werksaufzeichnung bis zum Lizenzmarktplatz. Die Marktkarte der Anbieter für Roboterdaten ordnet diese Wege ein.
| Wettbewerbsklasse | Stärke gegenüber Mecka | Was Mecka dagegen setzen muss |
|---|---|---|
| Spezialisierte Robotikdatensammler (Teleoperation, taktile Erfassung, Werksaufzeichnung) | höhere Effizienz in einer einzelnen Modalität | Nachweis, dass Breite nicht zu Oberflächlichkeit führt |
| Große KI-Datenplattformen | Beschaffungszugang in Unternehmen, Datenoperationen, Annotation, Sicherheit, bestehende Verträge | fachliche Tiefe in Robotik statt allgemeiner Datenkompetenz |
| Roboterhersteller selbst | Sensor- und Körperpassung, Fehlerdaten, Kundenkontext und menschliche Korrekturen als Nebenprodukt des Betriebs | tiefe Integration in fremde Stacks, bevor die Flotten groß werden |
Die dritte Klasse ist die gefährlichste, und sie ist keine Spekulation: Wer Fabrikdaten intern erfasst, Teleoperations- und Einsatzdaten selbst sammelt oder eigene Datenfabriken betreibt, braucht externe menschliche Daten weniger — allenfalls für Lücken. Heute sind installierte Humanoidenflotten klein, weshalb Menschen erheblich mehr Manipulationserfahrung besitzen als Roboter. Genau das ist Meckas Fenster. Wenn Roboter irgendwann in großer Zahl arbeiten, verschiebt sich die Datenquelle zur Flotte, und Mecka müsste bis dahin entweder tief in fremden Stacks verankert oder selbst in der Einsatz- und Flottenschicht angekommen sein.
Die Forschungsseite liefert dafür im Übrigen auch einen weichen Vorteil, der in keiner Marktanalyse auftaucht: Der Kontakt zu Georgia Tech, Stanford, UC San Diego, der ETH, Meta und Scale hilft nicht nur dem Produkt, sondern der Personalgewinnung. Ein Unternehmen ohne Robotikgründer klinkt sich so in die Forschungsgemeinschaft ein.
Die Kernfrage ist nicht Datenmenge, sondern Bruttomarge
Ein Datenunternehmen kann beeindruckenden Umsatz erzeugen und trotzdem ein schwieriges Geschäftsmodell haben, weil Erfassung personalintensiv ist. Aufnehmende müssen gewonnen werden, Hardware muss versendet werden, Aufnahmen schlagen fehl und werden nachgeholt, Qualitätsprüfung kostet, Standorte müssen organisiert, Rechte dokumentiert werden. Unternehmensprojekte brauchen Lösungsingenieure, Einsätze binden Feldtechnik.
Oberflächlich klingt eine Datenplattform nach Software. Tatsächlich braucht Mecka potenziell Smartphones, eigene Kameras, Wearables, taktile Handschuhe, Logistik, Speicher, GPU-Verarbeitung, Vergütung der Aufnehmenden, Feldteams, Robotikingenieure, Rechts- und Compliancefunktionen sowie Einsatzbetrieb. Das ist kapitalintensiver als klassische Software, mit einem Vorteil und einem Nachteil: höhere Eintrittsbarrieren, schwerere Skalierung.
Die Entscheidung, wie viel Integration Produkt und wie viel Dienstleistung ist, dürfte deshalb die wichtigste der nächsten Jahre sein. Denkbar ist eine reine Dateninfrastruktur mit standardisierten Schnittstellen und hoher Softwaremarge, bei der Partner den Einsatz übernehmen. Denkbar ist ein Full-Stack-Integrator mit größeren Abschlüssen und deutlich mehr Personalintensität. Und denkbar ist die Mischform, in der die Plattform den Großteil standardisiert und beim Kunden eingesetzte Teams den Rest lösen. Die sichtbaren Stellenprofile für Einsätze und Roboternavigation deuten auf die Mischform, und die wichtigste künftige Offenlegung wäre deshalb: Welcher Teil des Geschäfts skaliert softwareartig, und welcher wächst linear mit Personal?
Für die Einsatznähe spricht ein starkes Argument. Die letzten Probleme werden erst beim Kunden sichtbar — falsche Kameraposition, schlechte Beleuchtung, ein anderes Objekt als angenommen, eine falsche Prozessannahme, Systemlatenz, fehlende Rechte, ein unpassender Bedienablauf. Wer dort mit eigenen Leuten sitzt, erfährt unmittelbar, welche Daten tatsächlich fehlen, und kann den Kreis schließen: Einsatzfehler, Datenlücke, neue Erfassung, Training, Bewertung, neuer Einsatz. Dieser Kreis wäre ein echter Vorsprung — allerdings nur, wenn Kunden Mecka an die Daten lassen. Produktionsdaten sind sensibel, Fehlerdaten können Betriebswissen enthalten, und ein Kunde kann verlangen, dass nichts davon für andere verwendet wird. Dann sinkt das Lernen über Kunden hinweg, und Vertragsrechte werden zur Produktstrategie, nicht zur Rechtsabteilungsaufgabe.
Mit dem Netzwerk wächst das Qualitätsproblem
Langfristig könnte das eigentliche Vermögen weder ein Datensatz noch ein Werkzeug sein, sondern das Netzwerk der Aufnehmenden. Ein Kunde braucht vielleicht Barista-Aufgaben in Japan, Mechanikertätigkeit in Deutschland, Lagerkommissionierung in Texas, Hauskochen in Frankreich oder eine spezifische Werkzeugaufgabe. Ein globales Netzwerk mit geprüftem Aufbau und geklärten Rechten wäre schwer schnell nachzubauen.
Ein Netzwerk ist aber nur wertvoll, solange Qualität steuerbar bleibt. Hunderttausend Aufnehmende können hunderttausend Arten erzeugen, eine Aufgabe falsch aufzunehmen: falscher Kamerawinkel, Hand nicht im Bild, Aufgabe missverstanden, unbrauchbares Licht, falsche Reihenfolge, fehlende Kalibrierung. Meckas eigene Neuverarbeitung in EgoVerse zeigt, dass Qualitätskontrolle kein theoretisches Problem ist.
Dazu kommen Fehlanreize, sobald je Episode bezahlt wird — schnell und schlecht erledigte Aufgaben, wiederholte Bewegungen, abgedeckte Sensoren, die falsche Umgebung, recycelte Aufnahmen. Aus Text- und Annotationsarbeit kennen große Datenunternehmen dieses Muster; bei multimodalen physischen Daten ist es schwerer zu erkennen. Ein skalierendes Netzwerk braucht deshalb automatische Qualitätsprüfung, unmittelbare Rückmeldung, Aufgabenverifikation, einen definierten Weg zur Nacherfassung, Betrugserkennung, Gerätestatus und vollständige Metadaten. Meckas langfristige Qualität hängt damit ebenso an Automatisierung wie an Robotikforschung.
Deutschland: App im Store, aber kein Vertrieb
Ein Detail wirkt zunächst nach Marktpräsenz: Die iOS-App ist im deutschen App Store verfügbar. Das senkt die Hürde für ein europäisches Labor, weil Software heruntergeladen und ausprobiert werden kann. Eine Vertriebsstruktur für Unternehmen ist es nicht.
In den geprüften Quellen findet sich kein deutscher Standort unter den 18 offenen Stellen, keine Preisseite und kein öffentlich benannter deutscher Kunde; Unternehmensanfragen laufen über ein Kontaktformular. Das heißt nicht, dass Mecka nicht nach Europa verkauft — EgoVerse selbst hat ETH-Beteiligung, und digitale Produkte sind global. Es heißt: Der öffentliche Deutschlandstatus ist Forschungszugang, nicht lokale Unternehmenspräsenz.
Bemerkenswert ist noch ein zweites Signal, und zwar ein zweideutiges. Am 1. Juli 2026 war auf der Karriereseite in Toronto eine Stelle für die Leitung von Recht und Compliance ausgeschrieben, als Teil eines Bereichs mit sieben Verwaltungs- und Personalrollen. Am 22. September 2026 ist sie dort nicht mehr zu finden, und die Zahl offener Stellen ist von 39 auf 18 gefallen, die der Teams von acht auf fünf. Ob die Stelle besetzt oder zurückgezogen wurde, ist öffentlich nicht erkennbar — und beides würde Gegenteiliges bedeuten.
Für die Beschaffungsakte bleibt daraus: Deutschland könnte für Mecka ein besonders passender Markt sein, weil Automobil, Maschinenbau, Logistik und Gesundheitswesen viele komplexe manuelle Prozesse und hohe Arbeitskosten mitbringen. Gerade weil hier Datenschutz und Mitbestimmung streng sind, wäre ein erfolgreiches Werksdatenprogramm ein starkes Vertrauenssignal. Dafür braucht es allerdings lokale Vertrauensinfrastruktur, und die fehlt öffentlich.
Was ein deutscher Kunde projektspezifisch klären muss
Mecka erfasst menschliche Tätigkeit, und damit potenziell Gesichter, Hände, Stimmen, Umgebungen, Bewegungsmuster und Arbeitsabläufe. Die veröffentlichte Datenschutzrichtlinie beschreibt Website- und Dienstdaten sowie Beiträge zu Datensätzen. Zur Rechtsgrundlage und zur Einwilligungslage der Aufnahmen von über 2.000 Demonstrierenden liegen keine öffentlichen Angaben vor, ebenso nicht zu Zweckbindung und Drittlandtransfer. Eine allgemeine Website-Richtlinie trägt ein konkretes Erfassungsprogramm im Unternehmen ohnehin nicht.
Wer in Deutschland ein solches Programm aufsetzt, klärt deshalb projektspezifisch, und zwar bevor die erste Aufnahme entsteht: die Rechtsgrundlage der Verarbeitung, die Behandlung von Beschäftigtendaten — für die Artikel 88 der Datenschutz-Grundverordnung ausdrücklich Raum für spezifischere Regeln öffnet —, die Beteiligung der Arbeitnehmervertretung, die Vereinbarung zur Auftragsverarbeitung nach Artikel 28, Speicherorte und Unterauftragnehmer, Löschkonzept und Widerruf sowie die Rechte an Betriebs- und Geschäftsgeheimnissen. Der letzte Punkt wird unterschätzt: Eine Kamera in einer Produktion zeigt nicht nur Hände, sondern auch Produkte, Prozessreihenfolgen, Vorrichtungen und Qualitätsprobleme.
Diese Einordnung ist redaktionell und keine Rechtsberatung; ob und in welchem Umfang im Einzelfall auch die KI-Verordnung greift, hängt am Verarbeitungszweck und ist gesondert zu prüfen. Wirtschaftlich liegt darin aber eine Chance: Viele Unternehmen wollen Daten kaufen, wenige wollen selbst globale Einwilligungs-, Erfassungs- und Nachweisprozesse betreiben. Ein Anbieter, der Rechteketten standardisiert, verkauft nicht Video, sondern Risikoentlastung. Ist die Steuerung dagegen schwach, wird genau dieselbe Datenstrategie zum Problem — und europäische Regulierung entscheidet dann nicht über Kosten, sondern über Marktzugang.
Wo ein Vorsprung entstehen kann — und wo nicht
EgoVerse ist offen, die App ist öffentlich, und egozentrische menschliche Daten sind kein Geheimnis. Ein Vorsprung kann daher nicht in einem einzelnen Datensatz liegen, sondern nur im System: Netzwerk der Aufnehmenden, Erfassungshardware, Aufgabengestaltung, Verarbeitung, Qualitätssicherung, Suche, Bewertung, Kundenverträge und Einsatzintegration. Lernen alle Schichten gemeinsam schneller, als ein Kunde sie selbst aufbauen könnte, entstehen Wechselkosten.
Öffentlich sichtbar sind bislang EgoVerse, App, Web-Werkzeuge, Finanzierung, Stellenaufbau, Forschung und ein Zukauf. Kaum sichtbar sind die Zahlen, die den kommerziellen Fall härten würden: kundenspezifischer Modellzuwachs, Vergleich vor und nach einem Einsatz, Verlängerungsquoten, Bruttomargen, Vertragslaufzeiten, Nacherfassungsquoten und die Zeit bis zur ersten abgenommenen Lieferung.
Ein zweites Gleichgewicht muss dabei gehalten werden. Offene Forschung schafft Verbreitung: Labore nutzen die Werkzeuge, Forschende kennen das Schema, Mecka lernt an Verarbeitungsproblemen, Beiträge wachsen, Unternehmen sehen Technologie und Talent, und private Programme können auf derselben Infrastruktur aufsetzen. Zu offen, und es bleibt wenig monetarisierbarer Unterschied. Zu geschlossen, und die Forschungsadoption bricht weg. Die Forschungsevidenz selbst ist übrigens ambivalenter, als das Marketing klingt: Das EgoVerse-Papier zeigt, dass mehr menschliche Daten die Leistung verbessern können, und zugleich, dass der Effekt von der Passung zwischen menschlichen Daten und dem Lernziel des Roboters abhängt. Mehr Daten sind nicht automatisch besser — womit ein Versprechen über viele Stunden als Verkaufsargument ausfällt.
Woran sich die nächste Stufe erkennen lässt
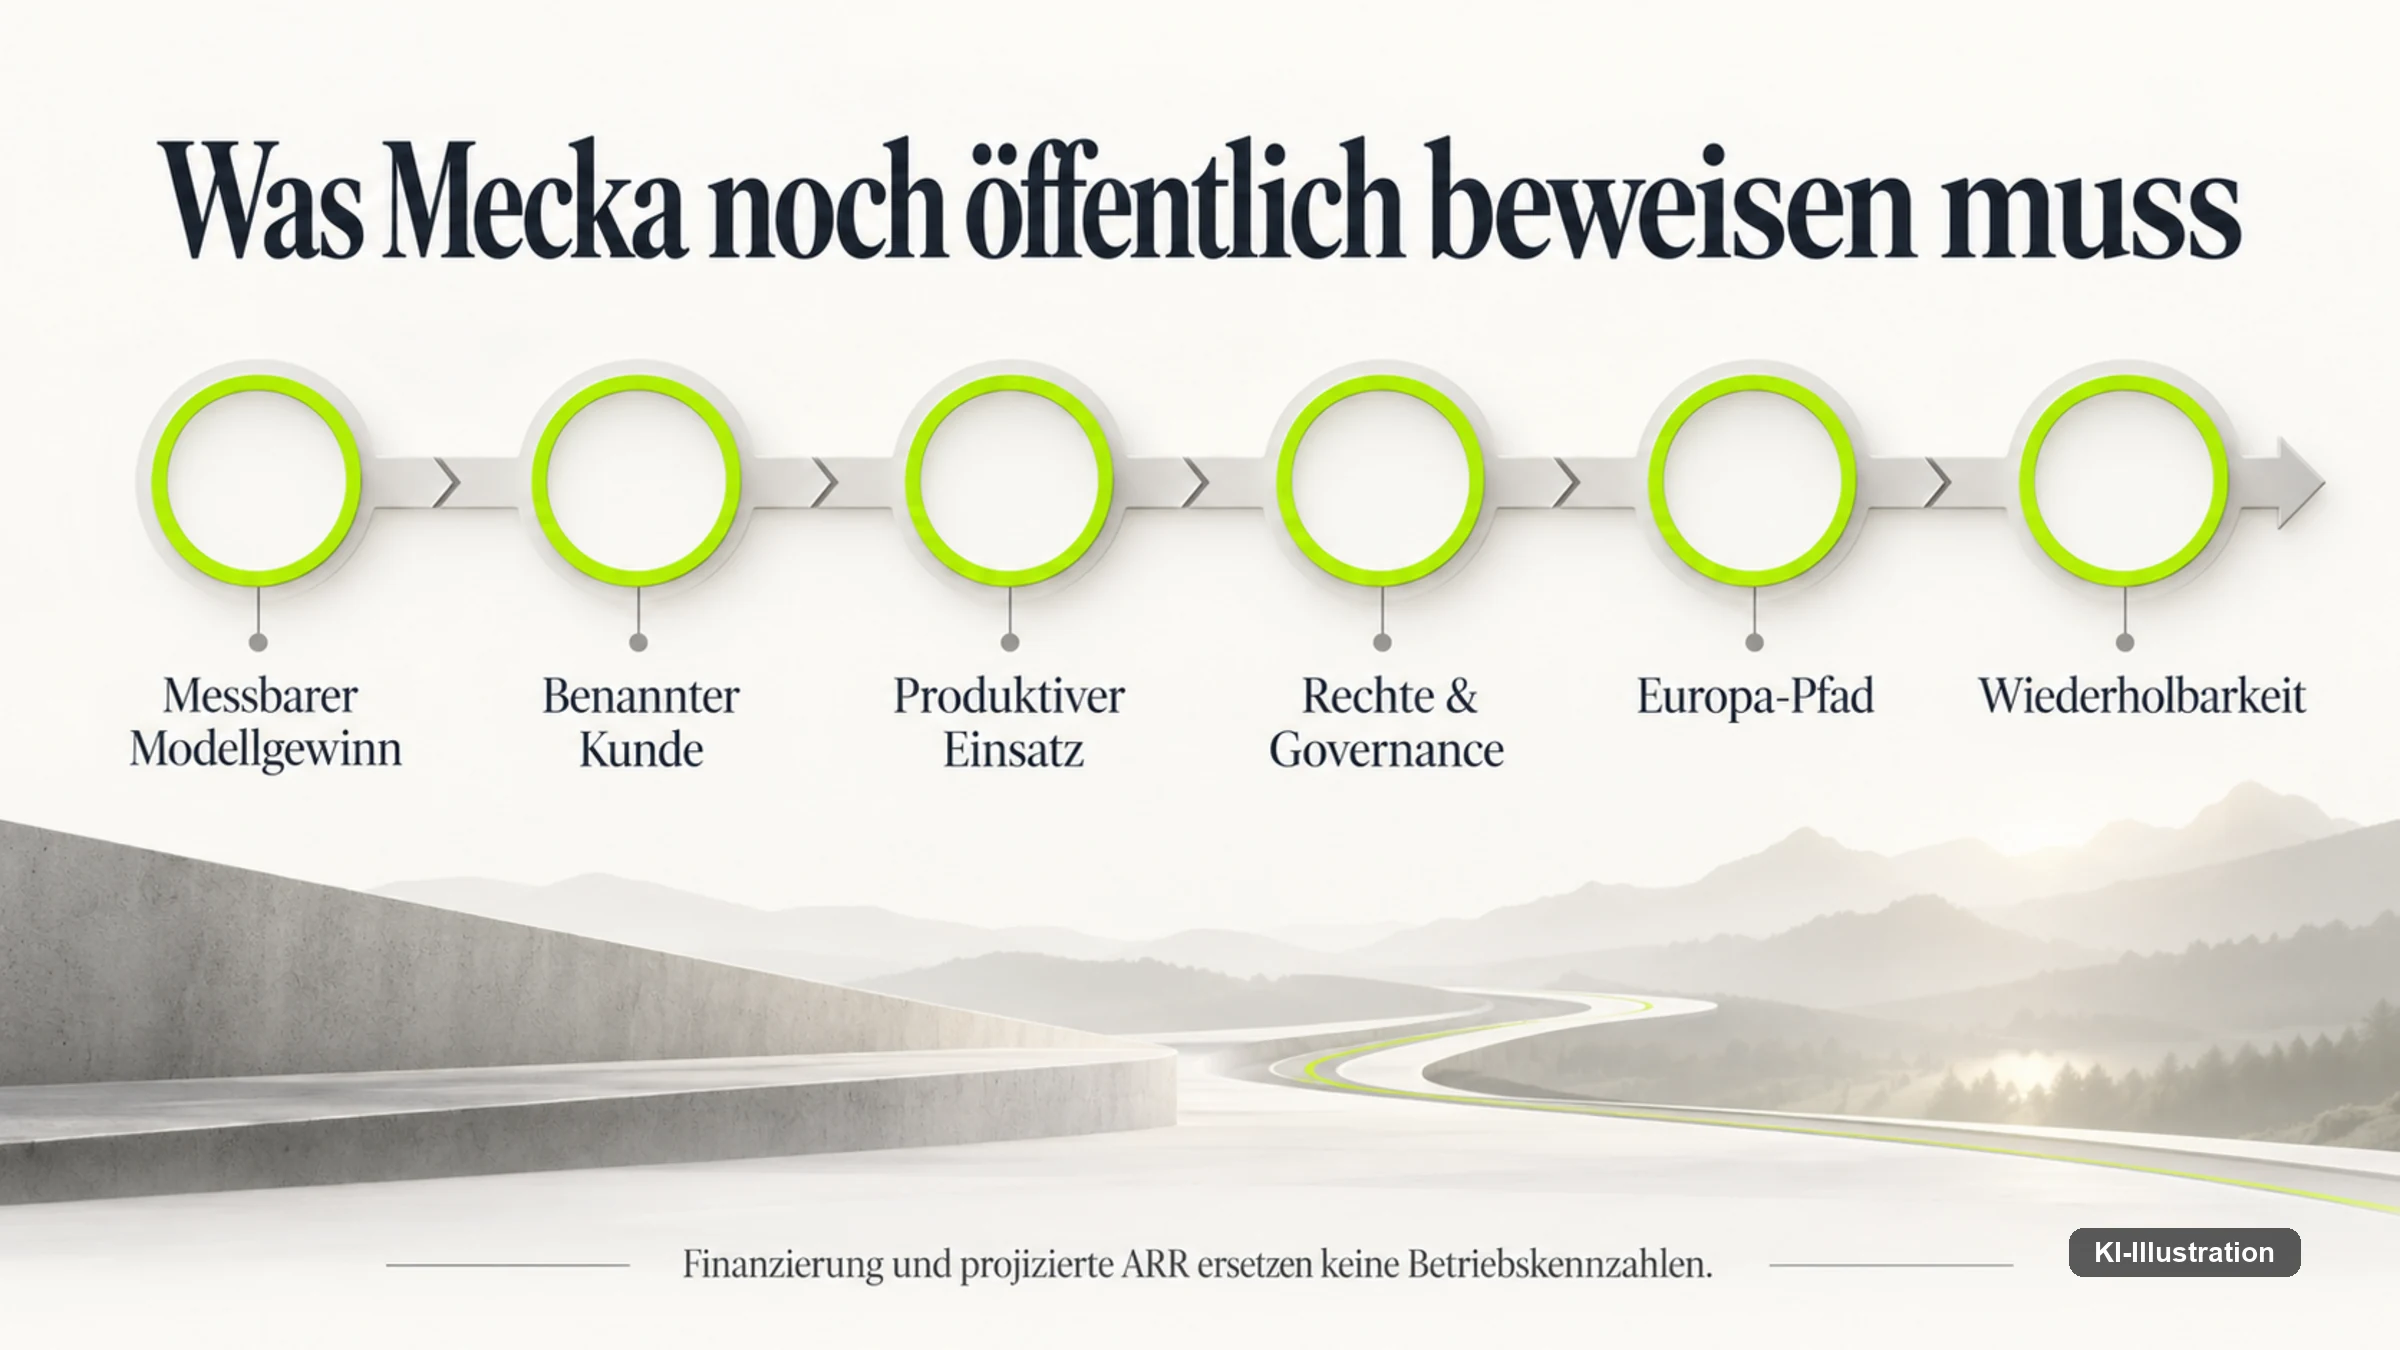
Für die nächsten Monate sind sieben Entwicklungen aussagekräftiger als jede weitere Datensatzgröße. Ob die gemeldete Runde abgeschlossen wird, in welcher Größe und zu welcher Bewertung, ist das schwächste dieser Signale — und trotzdem das, über das am meisten geschrieben werden wird.
Deutlich schwerer wiegt der erste öffentlich benannte Kunde aus dem Kreis der Grundlagenmodell-, Robotik- oder Industrieunternehmen, weil er die zentrale Lücke schließt. Daran hängt die Frage, ob sich die projizierte Run-Rate in wiederkehrenden Umsatz übersetzt oder ob sie aus einmaligen Großprogrammen besteht: Ein einmaliges Erfassungsprogramm ist ökonomisch etwas anderes als Plattformumsatz.
Technisch zählt, wie schnell hochwertige Episoden nach der Qualitätsprüfung wachsen — nicht die Bruttozahl. Kommerziell zählt der Nachweis der vollständigen Kette von Daten über gemessenen Modellzuwachs bis zu produktiver Roboterarbeit. Organisatorisch zählt, ob Rechte, Datenschutz und Standortdaten so weit standardisiert werden, dass ein Unternehmen sie ohne eigenes Projektteam übernehmen kann. Und für Europa zählt schlicht, ob eine belastbare lokale Route entsteht: Ansprechstelle, Kunde, Compliance-Rahmen, Partnerschaft. Kommt stattdessen die nächste Rekordzahl zu Stunden, ist das kein Fortschritt, sondern eine Wiederholung.
Fazit: verkauft wird die Übersetzung, nicht das Video
Die einfache Beschreibung lautet: Mecka sammelt Videos von Menschen für Robotertraining. Das trifft einen Teil, aber nicht mehr das Unternehmen, das im September 2026 sichtbar ist. Sichtbar sind Erfassungssoftware, eigene Erfassungshardware, menschliche Daten, Verarbeitung, Datensatzwerkzeuge, Bewertung, Einsatzunterstützung und ein offenes Forschungsökosystem als Verbreitungsweg.
Das ist ambitioniert, vielleicht zu ambitioniert, aber strategisch verständlich. Denn der wertvollste Punkt der Kette ist womöglich nicht das Video, sondern die Übersetzung: Ein Mensch tut etwas, die Tätigkeit wird sauber erfasst, ein Modell lernt daraus, ein Roboter kann es, und ein Unternehmen setzt es produktiv ein. Beherrscht Mecka diese Kette wiederholbar, ist es deutlich mehr als ein Datenlieferant. Beherrscht es sie nicht, droht die Zerreibung zwischen spezialisierten Sammlern, großen Datenplattformen und internen Datenmaschinen der Roboterhersteller.
Für Ihre Entscheidung zwischen Zukauf und Eigenaufbau folgt daraus ein pragmatischer Weg. Er beginnt nicht mit einer Stundenzahl, sondern mit der Lücke, an der das eigene Modell heute scheitert. Darauf folgt eine kleine, klar spezifizierte Stichprobe, an der Rechte und technische Qualität geprüft werden, und ein kontrolliertes Training gegen einen eigenen Bewertungssatz, den der Anbieter nicht kennt. Erst wenn dieser Test einen Zuwachs zeigt, wird skaliert. Die Finanzierung zeigt, dass Investoren die große Möglichkeit ernst nehmen, und EgoVerse zeigt, dass das technische Fundament Substanz hat. Was noch fehlt, ist der Beweis, der bei jedem jungen Physical-AI-Unternehmen irgendwann fällig wird: ein öffentlich nachvollziehbarer Weg von Datenausgaben über messbaren Modellzuwachs zu produktiver Roboterarbeit.
Verkauft Mecka Roboter oder Robotersoftware?
Weder noch. Mecka verkauft Zugang zu Datensätzen, aufgabenspezifische Erfassung, Modellbewertung und vollständige Datenprogramme bis zur Einsatzunterstützung. Eigene Hardware entsteht nur als Erfassungswerkzeug — Kameras, Körpersensorik und taktile Handschuhe —, nicht als Produkt für die Fabrik.
Gehört EgoVerse allein Mecka?
Nein. EgoVerse ist ein Konsortialdatensatz mit mehreren beteiligten Institutionen, darunter Georgia Tech, Stanford, UC San Diego und die ETH Zürich sowie Meta Reality Labs Research und Scale AI auf der Industrieseite. Mecka ist beteiligt und bezeichnet den Datensatz im eigenen FAQ als seinen — als Alleineigentum lässt sich das nicht lesen.
Ist die projizierte Jahres-Run-Rate von 100 Millionen US-Dollar ein Umsatz?
Nein. Es handelt sich um eine Projektion des Unternehmens auf Basis unterschriebener Verträge, genannt vom CEO gegenüber Fortune. Ein testierter Abschluss, eine verbuchte Jahresleistung oder ein Zahlungseingang ist damit nicht belegt, und über Laufzeiten, Mindestabnahmen und Kundenverteilung ist öffentlich nichts bekannt.
Ist die von Sequoia geführte Runde abgeschlossen?
Nach dem Bericht vom 11. September 2026 nicht. Die Konditionen sind ausdrücklich nicht final und könnten sich ändern, beide Seiten haben nicht kommentiert, und die eigene Website nennt Sequoia am 22. September 2026 nicht. Eine Bewertung um 500 Millionen US-Dollar ist damit gemeldet, nicht bestätigt.
Welche Zahlen zu EgoVerse sollte man zitieren?
Immer mit Stand. Die Publikation vom April 2026 nennt 1.362 Stunden und 80.000 Episoden, der laufende Explorer am 17. September 2026 über 4.108 Stunden und über 446.000 gefilterte Episoden. Beide Werte sind datierte Untergrenzen eines wachsenden Systems; eine Zahl ohne Datum ist binnen Monaten falsch.
Kann ein deutsches Unternehmen heute bei Mecka beschaffen?
Forschungszugang ja, eine lokale Unternehmensroute nein. Die iOS-App steht im deutschen App Store, Datensätze und Werkzeuge sind erreichbar. Ein deutscher Standort findet sich unter den 18 offenen Stellen nicht, eine Preisseite fehlt, und Unternehmensanfragen laufen über ein Kontaktformular — Servicezusagen und europäische Preislogik müssen individuell verhandelt werden.
Welche Datenschutzfragen entscheiden über ein Werksdatenprogramm in Deutschland?
Die Rechtsgrundlage der Verarbeitung, der Umgang mit Beschäftigtendaten, die Beteiligung der Arbeitnehmervertretung, eine Vereinbarung zur Auftragsverarbeitung, Speicherorte und Unterauftragnehmer, Löschung und Widerruf sowie die Rechte an Betriebsgeheimnissen. Zur Einwilligungslage der bereits erfassten Aufnahmen liegen keine öffentlichen Angaben vor. Das ist eine redaktionelle Einordnung und keine Rechtsberatung.
Warum ist die Zahl aufgezeichneter Stunden keine gute Einkaufsgröße?
Weil Rechteprüfung, technische Abnahme und Aufgabenbezug einen großen Teil des Rohvolumens aussortieren, bevor trainiert wird — und weil die Forschung zeigt, dass der Nutzen menschlicher Daten von der Passung zum Lernziel abhängt. Aussagekräftig sind die Kosten je akzeptierter Episode und der gemessene Modellzuwachs gegen einen eigenen Bewertungssatz.
Quellen & Stand: die Unternehmenswebsite von Mecka AI (Selbstbeschreibung, vier Wege der Zusammenarbeit, Signalbausteine, FAQ, Datenschutzrichtlinie, Stellenliste; Abruf 22.09.2026) sowie der EgoVerse-Explorer auf der Partnerplattform (Datenstand 17.09.2026); App-Store-Eintrag der Mecka-App unter Carbon Based Technology Corp.; EgoVerse-Publikation vom April 2026 auf arXiv und das zugehörige öffentliche Repositorium mit Änderungshistorie; Fortune vom Juni 2026 (Gründer, Finanzierung, Erfassungshardware, Run-Rate-Projektion, Mitarbeiterzahl); TechCrunch vom 11.09.2026 (Gründungsjahr, Gründerhintergrund, Wettbewerb, gemeldete Sequoia-Runde, Kundenliste nicht offengelegt); Unterlagen zur Series A und zur Erweiterung; Berichterstattung zur Docula-Übernahme vom Juni 2026; Internet-Archive-Stand der Karriereseite vom 01.07.2026 gegen den Lebendstand vom 22.09.2026. Rechtsrahmen: Verordnung (EU) 2016/679 (Datenschutz-Grundverordnung), insbesondere Artikel 28 und 88, sowie Verordnung (EU) 2024/1689 über künstliche Intelligenz. Unternehmensangaben sind Bestangaben und an der Primärquelle zu prüfen; Projektion ist nicht Umsatz, gemeldete Runde ist nicht abgeschlossene Finanzierung. Diese Einordnung ist redaktionell und keine Rechts- oder Anlageberatung. Stand: 22. September 2026.